
Microsoft, hızlı karar puanlama (decision scoring) için geliştirdiği yeni modeli Microsoft-Decision-1’i duyurdu. Model Microsoft Foundry’de ve OpenRouter üzerinden kullanılabiliyor. Hedefi metin üretmek değil; routing, sınıflandırma, önceliklendirme, doğrulama ve iş akışı kontrolü gibi işlerde yazılımın doğrudan kullanabileceği yapılandırılmış kararlar vermek.
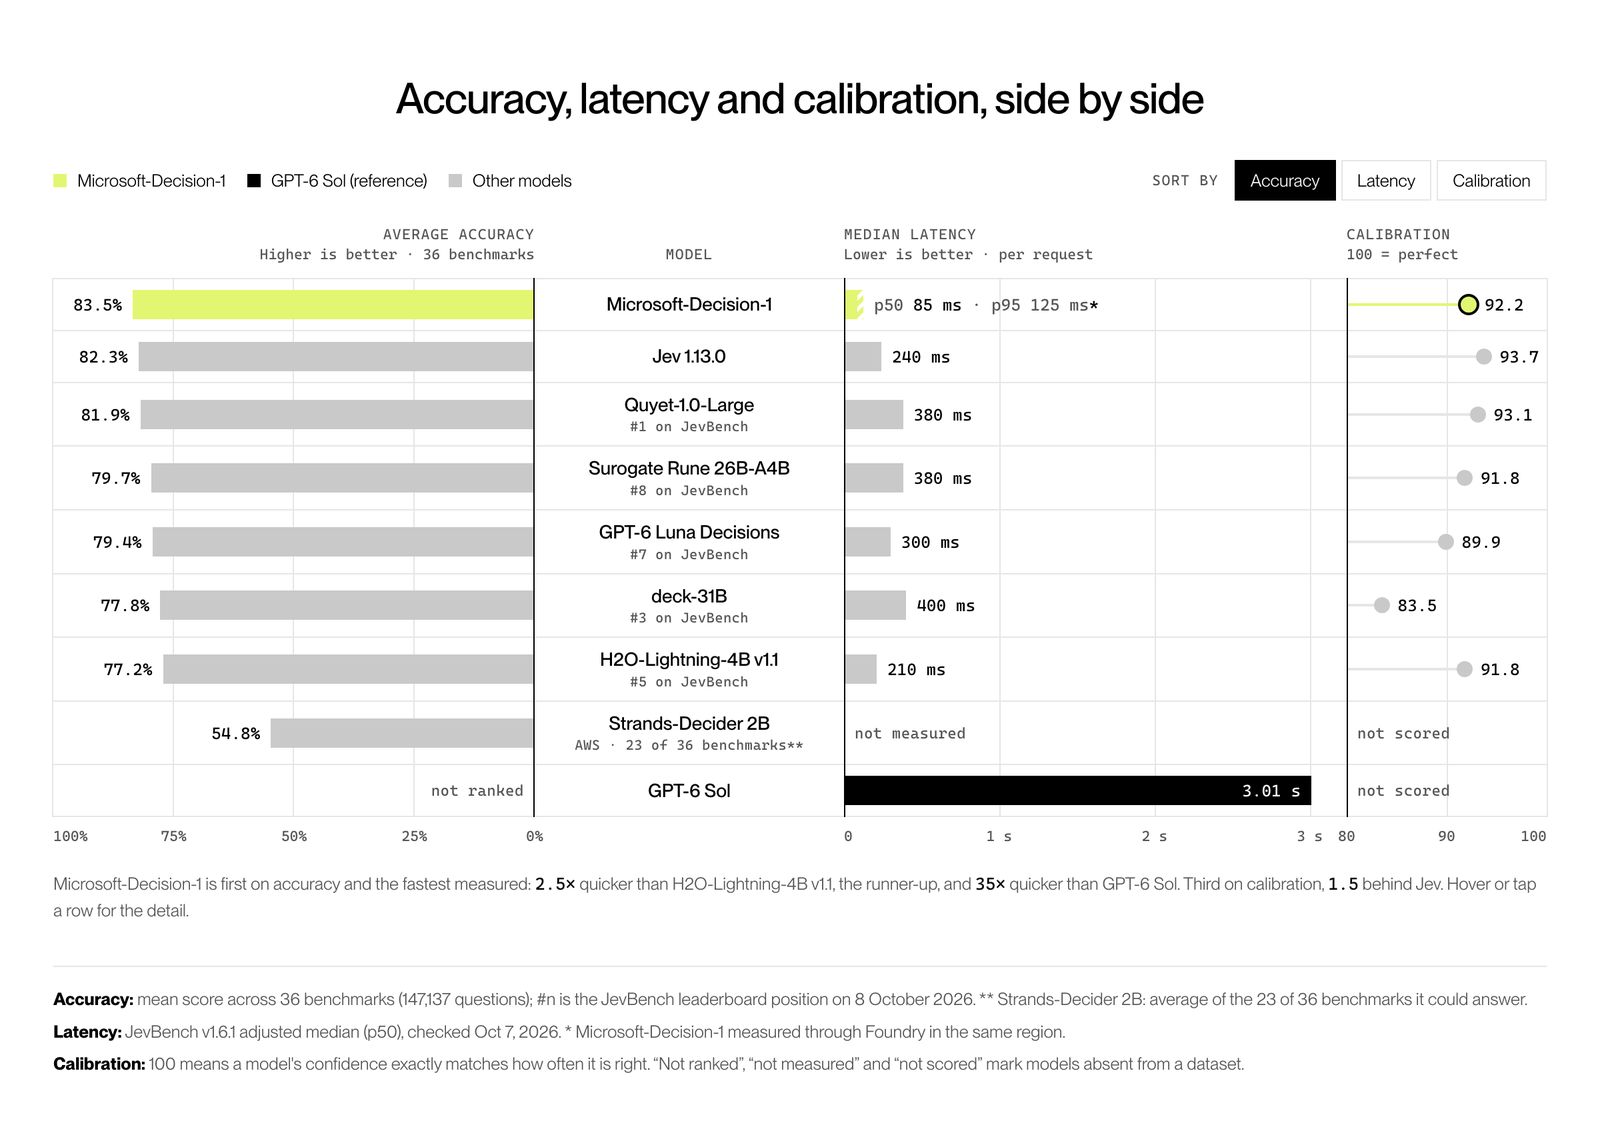
Microsoft’un iddiası net: Decision-1, eğitimde kullanılmayan yaklaşık 150 bin soruyu kapsayan 36 benchmark’lık karşılaştırmada en yüksek doğruluğu aldı ve ölçülen en hızlı model oldu. İkinci sıradaki H2O-Lightning-4B v1.1’den 2,5 kat, GPT-6 Sol’den 35 kat daha hızlı.
Decision model nedir?
Decision model’ler AI’da hızla öne çıkan yeni bir kategori. LLM’ler metin üretmek ya da karmaşık problemler üzerinde akıl yürütmek için tasarlanıyor. Decision model’ler ise tek bir iş için var: sabit bir seçenek kümesi içinden karar vermek ve bunu yazılımın hemen işleyebileceği yapılandırılmış bir çıktı olarak döndürmek. Çok düşük maliyetle ve yüksek performansla karar verip sınıflandırma yapabilen bir model olduğunda, bir LLM’e sormanın pahalı ya da yavaş kaldığı pek çok iş mümkün hale geliyor.
Microsoft-Decision-1 nasıl çalışıyor
Microsoft, modeli Qwen3.5-9B üzerinde hızlı ve tek geçişli (single-pass) karar puanlama için ek eğitimden geçirerek oluşturdu. Şirket yakında modeli Microsoft AI (MAI) ve OpenAI modelleri dahil başka temel modeller üzerine de taşıyacağını söylüyor.
Modele sabit bir cevap seçenekleri kümesi verildiğinde, her seçenek için kalibre edilmiş bir olasılık skoru döndürüyor. Evet/hayır, çoktan seçmeli ve derecelendirme seçeneklerini destekliyor; ayrıca AI yanıtlarının ve agent aksiyonlarının rubric’e göre notlanmasını da yapabiliyor. Hepsi basit, yapılandırılmış tek bir API çağrısıyla.
Microsoft, güvenilir bir decision model kurmak için beş sorunu çözmek zorunda kaldığını anlatıyor.
1. Hız
Her karar gecikme ekliyor, özellikle adımlar birbirine bağlıysa. Art arda gelen 20 kararın her birine sadece 100 milisaniye eklemek, toplam iş akışını iki saniye uzatıyor. Agent’ların her adımda bir şeye karar verdiği sistemlerde bu fark hızla büyüyor.
Decision-1’in medyan (p50) gecikmesi 85 ms, p95 gecikmesi 125 ms. Aynı ölçümde GPT-6 Sol 3,01 saniyede kalıyor; yani Decision-1 yaklaşık 35 kat hızlı. Diğer decision model’ler 210 ile 400 ms arasında.
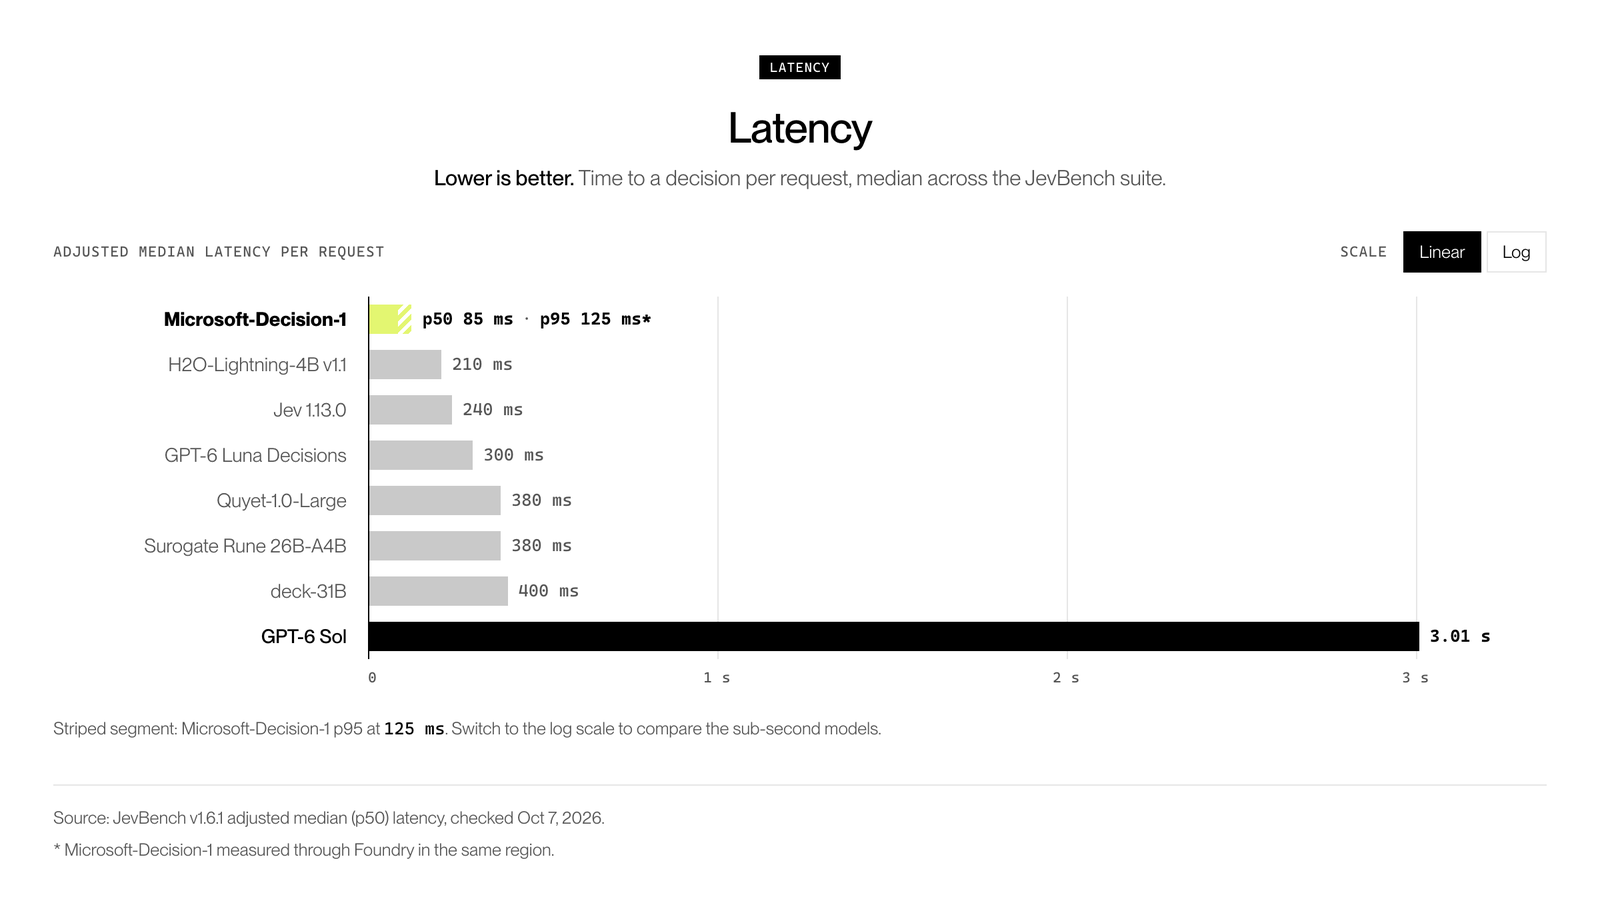
| Model | Medyan gecikme |
|---|---|
| Microsoft-Decision-1 | 85 ms (p95: 125 ms) |
| H2O-Lightning-4B v1.1 | 210 ms |
| Jev 1.13.0 | 240 ms |
| GPT-6 Luna Decisions | 300 ms |
| Quyet-1.0-Large | 380 ms |
| Surogate Rune 26B-A4B | 380 ms |
| deck-31B | 400 ms |
| GPT-6 Sol | 3,01 s |
2. Genellenebilen kalite
Bir modeli tek bir benchmark’a ya da tek tip karar görevine göre overfit etmek kolay. Asıl soru, kalitenin modelin eğitilmediği görevlere taşınıp taşınmadığı. Microsoft bu yüzden Decision-1’i eğitimden gizli tutulan onlarca benchmark’ta değerlendirdi: routing, ranking, uzun bağlam, çok dilli ve dağılım dışı (out-of-distribution) görevler, reasoning ve güvenlik.
Ayrıca popüler açık leaderboard JevBench’teki en iyi public modellerden birkaçını alıp 36 ek public ve private benchmark’ta test etti. Toplam 147.137 soruluk bu sette Decision-1 yüzde 83,5 ortalama doğrulukla birinci oldu. İlginç bir detay: JevBench’te 1. sırada olan Quyet-1.0-Large bu geniş sette üçüncülüğe, 3. sıradaki deck-31B ise altıncılığa düşüyor.
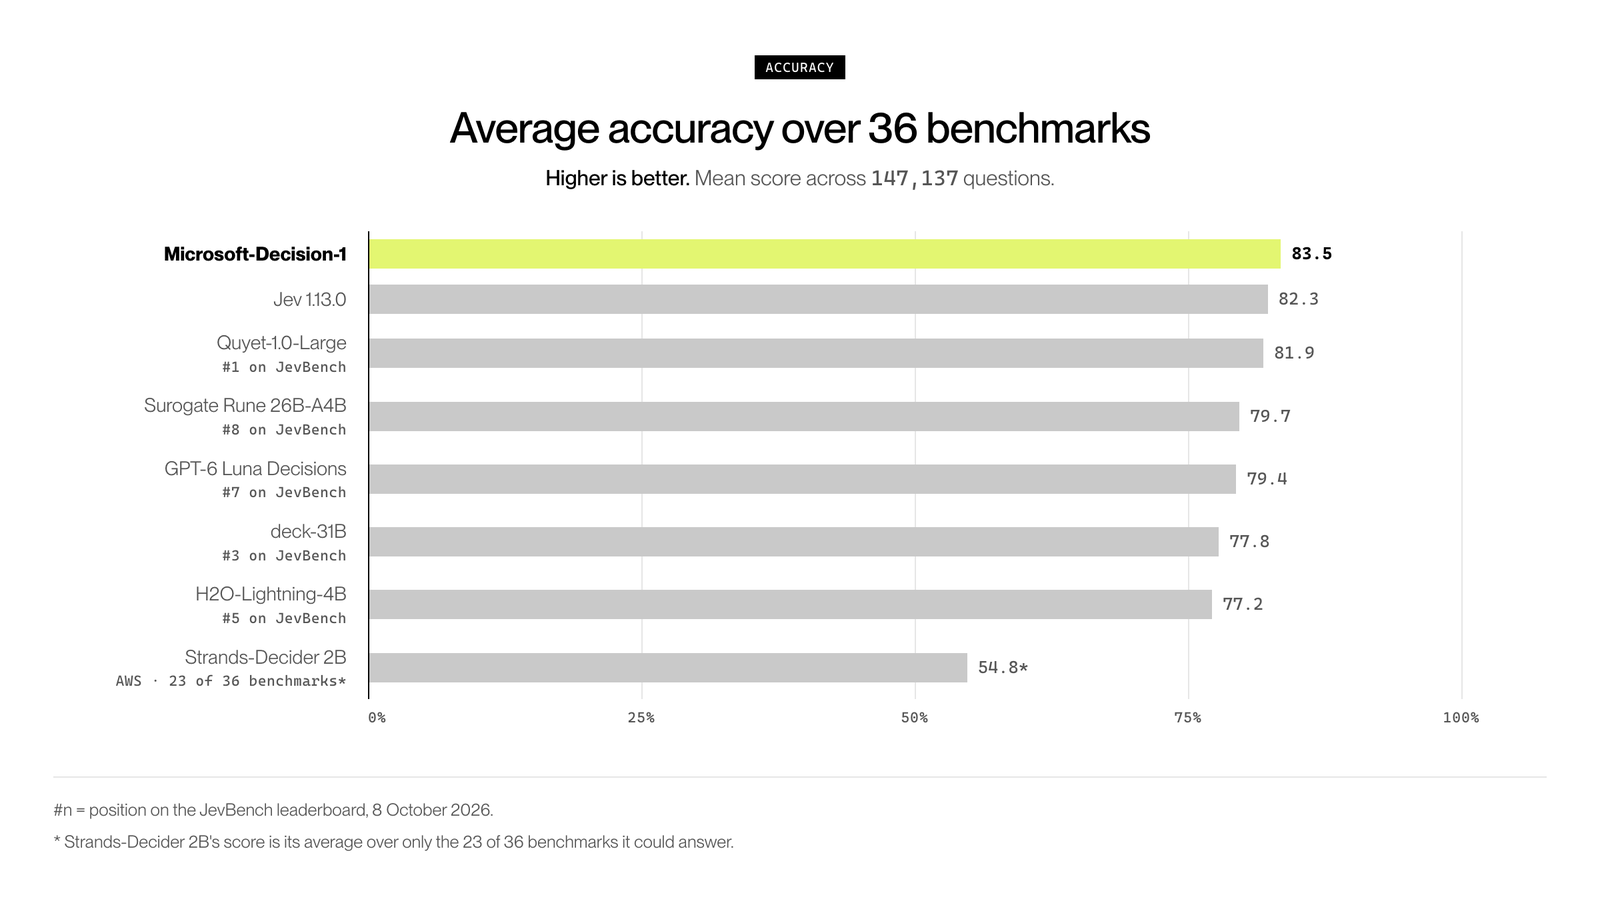
| Model | Ortalama doğruluk | JevBench sırası |
|---|---|---|
| Microsoft-Decision-1 | %83,5 | – |
| Jev 1.13.0 | %82,3 | – |
| Quyet-1.0-Large | %81,9 | 1 |
| Surogate Rune 26B-A4B | %79,7 | 8 |
| GPT-6 Luna Decisions | %79,4 | 7 |
| deck-31B | %77,8 | 3 |
| H2O-Lightning-4B | %77,2 | 5 |
| Strands-Decider 2B (AWS) | %54,8 (36 benchmark’ın 23’ü) | – |
3. Dayanıklılık
Eşdeğer girdiler eşdeğer kararlar üretmeli. Production’da durumlar ve talimatlar farklı kelimelerle ifade ediliyor, seçenek açıklamaları değişiyor, seçeneklerin sırası karışıyor, key’ler değişiyor ve zararsız format gürültüsü ortaya çıkıyor. Bunların hiçbiri kararı anlamlı şekilde değiştirmemeli.
Microsoft aynı isteği sekiz farklı şekilde bozup kararın ne sıklıkla değiştiğini ölçtü. Decision-1 ortalamada bu bozulmaların yüzde 1,3’ünde karar değiştiriyor. Seçenek açıklamaları başka kelimelerle yazıldığında ya da seçenekler ters çevrildiğinde veya karıştırıldığında ise hiç karar değiştirmiyor.
4. Olasılık ve güven kalibrasyonu
Olasılık değeri sadece bir sıralama skoru değil, API’nin bir parçası. Uygulamalar ne zaman harekete geçeceklerine, ne zaman erteleyeceklerine ya da insan incelemesi isteyeceklerine bu güven değerine bakarak karar veriyor. Dolayısıyla yüzde 90’lık bir tahmin, temsili vakalarda on seferin yaklaşık dokuzunda doğru çıkmalı.
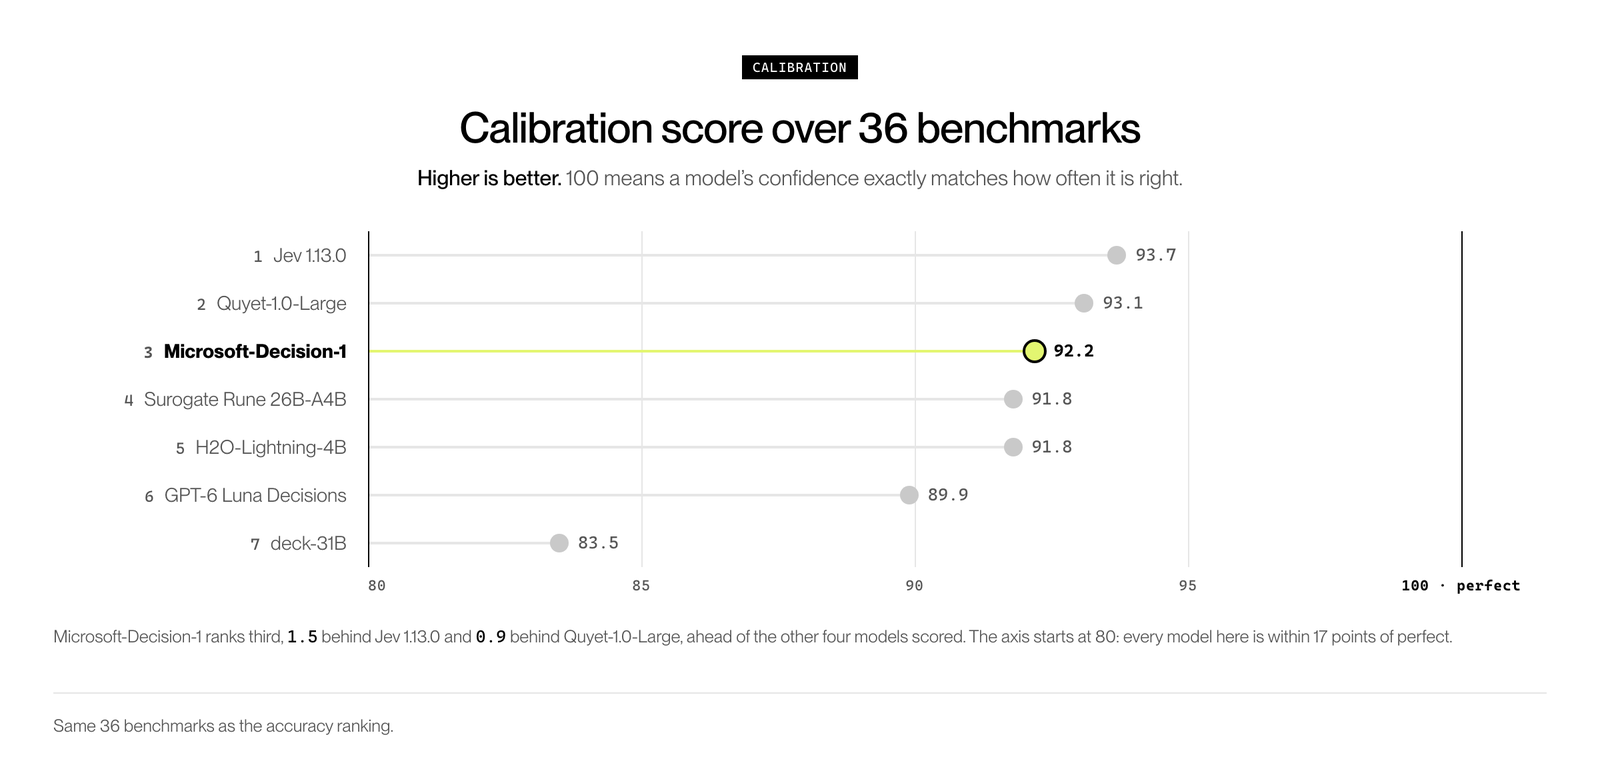
Kalibrasyon, Decision-1’in birinci olmadığı tek başlık. 100’ün mükemmel olduğu ölçekte 92,2 ile üçüncü sırada; Jev 1.13.0’ın (93,7) 1,5 puan, Quyet-1.0-Large’ın (93,1) 0,9 puan gerisinde. Microsoft yazıyı sonradan güncelleyip Jev sonuçlarını eklemiş ve bu tabloyu açıkça gösteriyor.
5. Güvenlik
Bir decision model zararlı istekleri tanımalı ama zararsız olanları gereksiz yere engellememeli. Microsoft, Decision-1’i zararlı içerik, jailbreak denemeleri ve prompt injection’ı kapsayan 11 benchmark’ta 5.250 istekle test etti. Şirkete göre model zararlı davranışı reddederken yüksek ölçüde kullanışlı kalmayı başardı. Bu bölümde yazı ayrıntılı rakam vermiyor.
Demo: sınıflandırma
Sınıflandırma, decision model’lerin temel kullanım alanı. Aşağıdaki demoda Decision-1’in farklı sorguları GPT-6 Sol’e kıyasla ne kadar hızlı ve doğru kategorize ettiği görülüyor.
Demo: computer use
Decision model’ler computer use senaryolarında da verimli olabiliyor: her adımda ekrandaki seçenekler arasından bir sonraki aksiyonu seçmek tam olarak bir karar problemi. Bu demo, bir sırt çantası satın alma görevinde Decision-1’in GPT-6 Sol’e göre ne kadar hızlı ilerlediğini gösteriyor.
Microsoft içeride nasıl test ediyor
Microsoft, modeli kendi ekiplerinde dört farklı alanda denemiş.
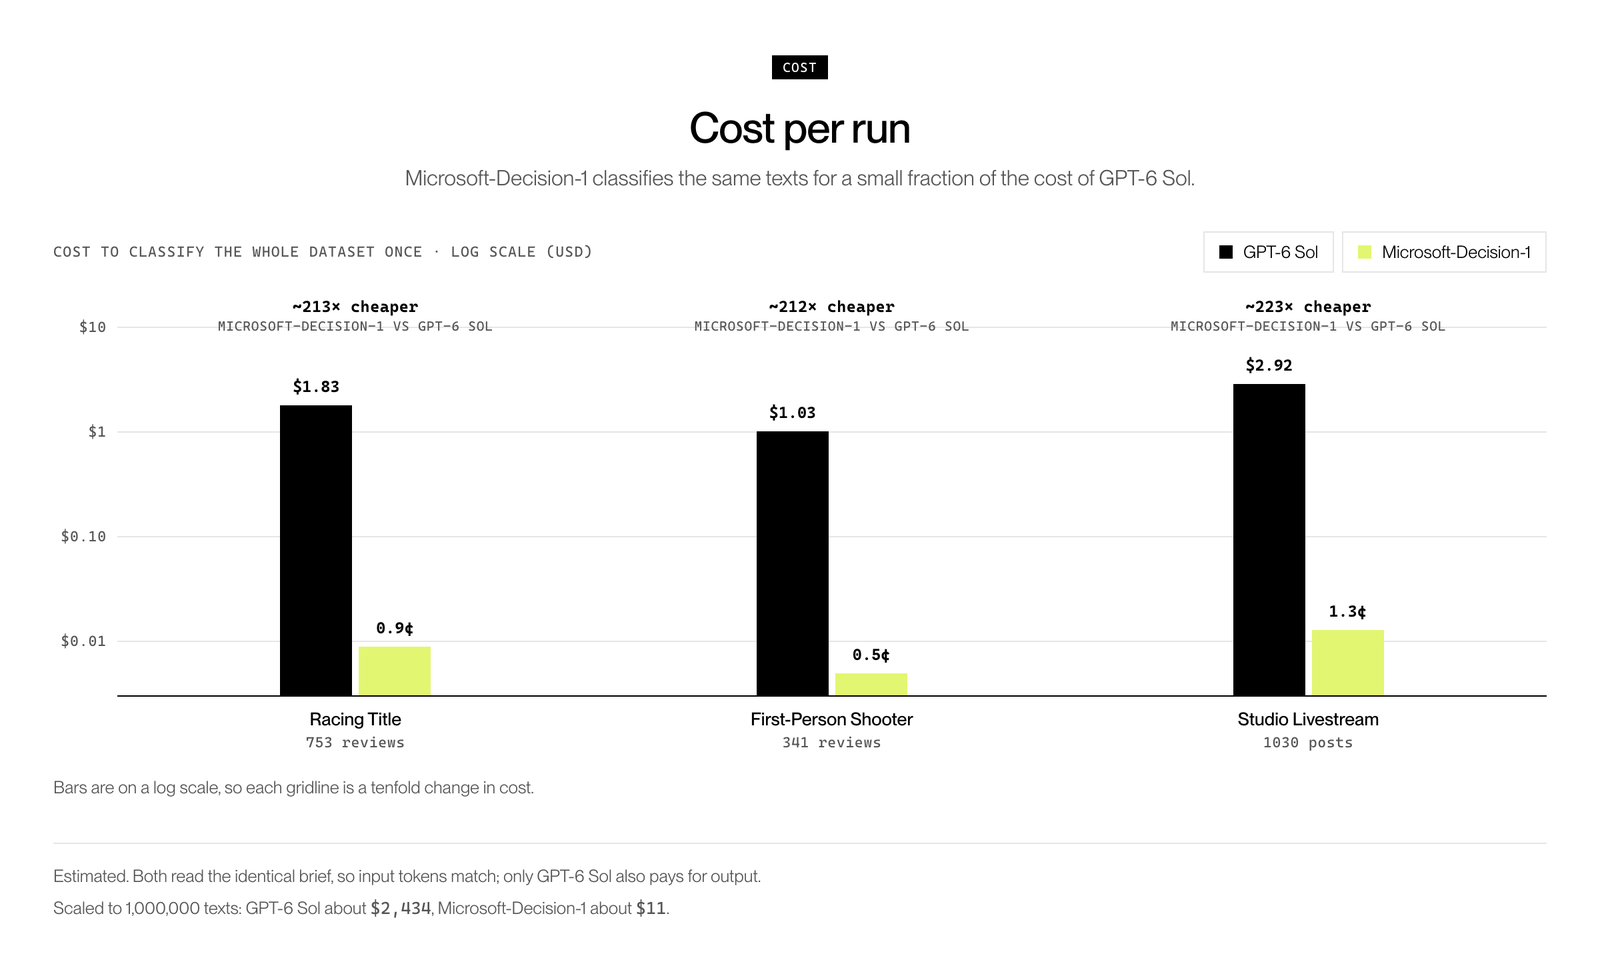
Veri etiketleme. Xbox Research; anketlerden, Steam’den ve Twitter/X’ten gelen 10 binden fazla açık uçlu geri bildirimi ve yorumu, araştırmacıların belirlediği sabit bir tema kümesine ayırmak için Decision-1’i kullandı. Amaç insanların farklı oyunlar, lansmanlar ve yayınlar hakkında ne söylediğini anlamak. Ekip, modelin kalitede GPT-6 Sol ile rekabet edebildiğini, ama 14 kattan fazla hızlı ve 200 kat ucuz çalıştığını gördü.
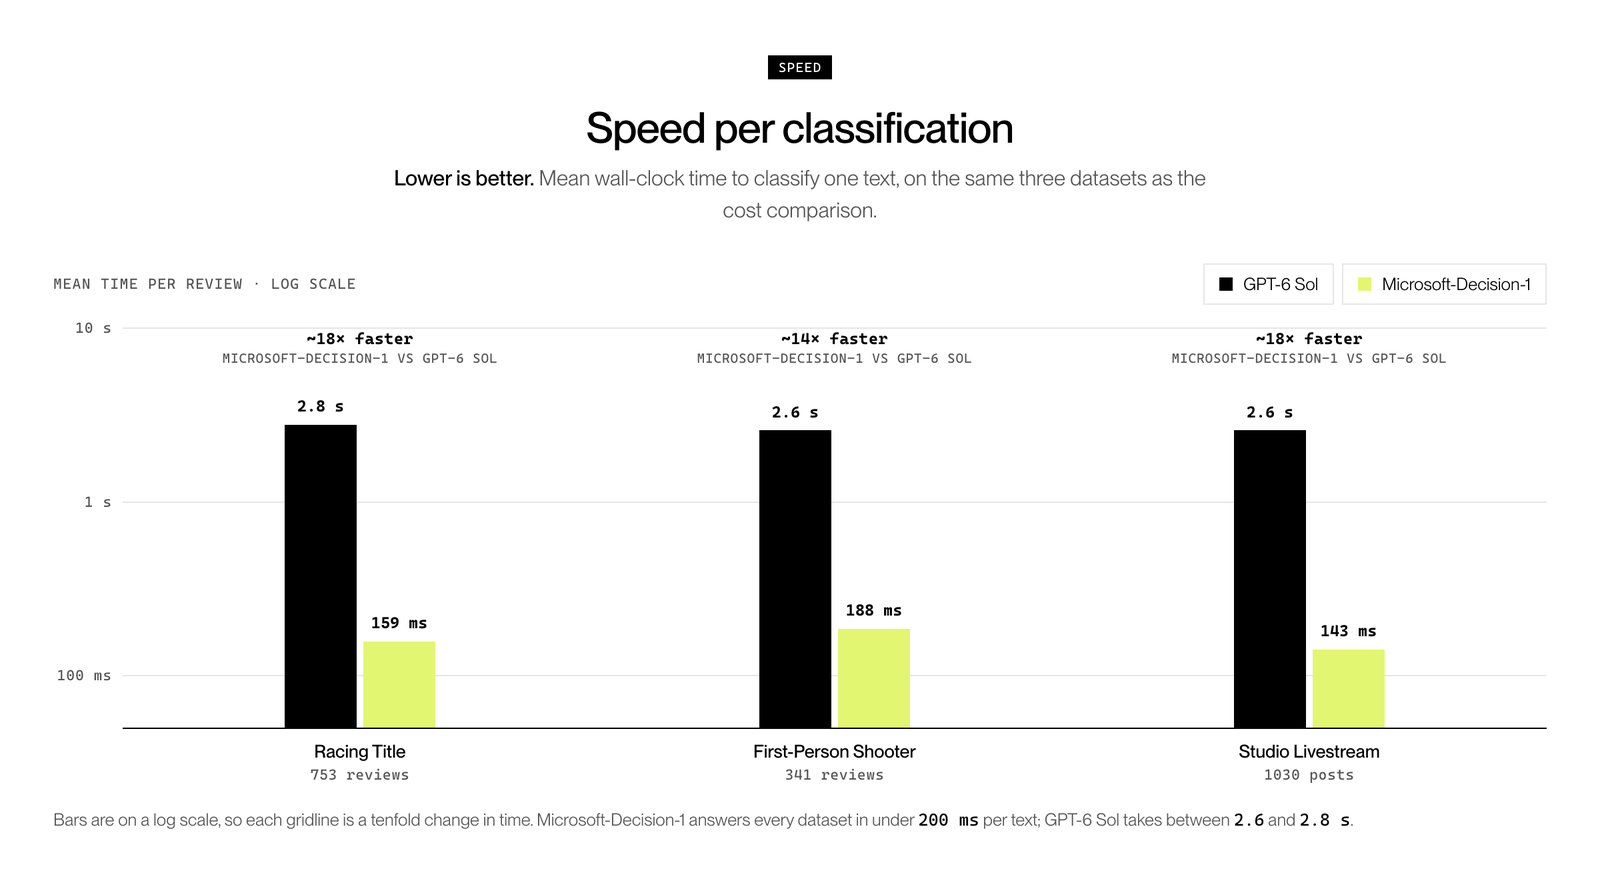
Üç veri setinde metin başına ortalama süre Decision-1 için 143 ile 188 ms arasında, GPT-6 Sol için 2,6 ile 2,8 saniye arasında. Maliyet farkı daha da büyük: aynı veri setini bir kez sınıflandırmak GPT-6 Sol ile 1 ila 3 dolar tutarken Decision-1 ile yaklaşık bir sent. Microsoft’un tahminine göre bir milyon metne ölçeklendiğinde GPT-6 Sol yaklaşık 2.434 dolar, Decision-1 ise yaklaşık 11 dolar tutuyor.
| Veri seti | GPT-6 Sol | Microsoft-Decision-1 | Fark |
|---|---|---|---|
| Racing Title (753 yorum) | 2,8 s / 1,83 $ | 159 ms / 0,9 sent | ~18 kat hızlı, ~213 kat ucuz |
| First-Person Shooter (341 yorum) | 2,6 s / 1,03 $ | 188 ms / 0,5 sent | ~14 kat hızlı, ~212 kat ucuz |
| Studio Livestream (1.030 gönderi) | 2,6 s / 2,92 $ | 143 ms / 1,3 sent | ~18 kat hızlı, ~223 kat ucuz |
Kalite kontrol. Copilot ekibi sohbet ve agentic yanıtların kalitesini ölçüyor. Testlerinde Decision-1’i GPT-5.6 Luna ile rekabet edebilir ve 100 kat daha hızlı buldular.
Olay müdahalesi. Microsoft’un nöbetçi mühendisleri canlı olaylara müdahale ederken log’lar, ticket sistemleri, görüşmeler, mesajlar ve diğer veri kaynaklarından ilgili bilgiyi AI ile çekiyor. Decision-1, bilgi getirme işinde bir LLM’den hem daha iyi hem daha hızlı sonuç verdi.
Bilimsel keşif. Microsoft Discovery’de bir agent önceki deneyi değerlendiriyor, rubric notlarına göre yaklaşımını gözden geçiriyor ve hedeflerine ulaşana kadar tekrarlıyor (adaptive replanning). Decision-1, LLM tabanlı puanlamaya göre 46 kat daha tutarlı ve üç kat hızlı çıktı; adaptive replanning’de de yaklaşık dört kat hız sağladı. Uzun süren bilimsel deneylerde daha hızlı ve güvenilir planlama, sonuçları ciddi şekilde etkileyebilir.
Nerelerde kullanılabilir
Microsoft, modelin potansiyel kullanım alanlarını uzun bir liste halinde veriyor:
- Agent kontrolleri: Agent’ın önerdiği bir sonraki adımı değerlendirip devam etmeye, durmaya, yeniden denemeye ya da bir modele, araca veya insana devretmeye karar vermek.
- Model routing: Gelen isteği değerlendirip kalite, maliyet ve gecikme gereksinimlerine göre en uygun modeli seçmek.
- Skill tabanlı kararlar: Uzun bir talimat listesini her seferinde yeniden işlemeden, bir agent skill’inin kurallarını uygulayıp uygun aksiyonu seçmek.
- Veri etiketleme: Sosyal medya gönderilerine, müşteri geri bildirimlerine ve diğer verilere analiz ya da eğitim için tutarlı etiketler atamak.
- AI judging: AI’ın ürettiği bir yanıtı tanımlı kalite kriterlerine göre değerlendirip kabul, revize ya da ret kararı vermek.
- Intent analizi: Kullanıcının ne yapmaya çalıştığını belirleyip desteklenen bir intent ile eşleştirmek.
- Olay yönlendirme: Bir olayı türüne ve aciliyetine göre sınıflandırıp doğru ekibe ya da iş akışına yönlendirmek.
- Veri doğrulama: Bir girdinin tanımlı gereksinimleri karşılayıp karşılamadığını kontrol edip kabul, ret ya da inceleme kararı vermek.
- Öneriler: Aday kümesinden en ilgili ürünü, teklifi ya da sonraki aksiyonu seçmek.
- Arama alaka düzeyi: Bir arama sonucunun sorguyla ne kadar eşleştiğini değerlendirip alaka etiketi ya da öncelik atamak.
- İçerik sınıflandırma ve filtreleme: İçeriği konuya ya da policy’ye göre kategorize edip göstermeye, filtrelemeye ya da incelemeye göndermeye karar vermek.
- Kod tarama: Kodu tanımlı kriterlere göre değerlendirip olası hataları ya da policy ihlallerini işaretlemek.
- Güvenlik taraması: İstekleri, çıktıları ya da önerilen aksiyonları riske göre sınıflandırıp izin vermek, engellemek ya da üst seviyeye taşımak.
- Computer ve UI kullanımı: Mevcut ekrana ve göreve göre bir seçenek kümesinden sonraki arayüz aksiyonunu seçmek.
- Robotik: Gözlemlere, görev hedeflerine ve çalışma kısıtlarına göre önceden tanımlı robot aksiyonları arasından seçim yapmak.
- Bilimsel keşif: Aday hipotezleri, bileşikleri ya da deneyleri tanımlı kriterlere göre eleyip önceliklendirmek.
Fiyat ve erişim
Fiyatlandırma modelin en dikkat çekici yanlarından biri: input token’lar milyon token başına 0,042 dolar, output token’lar ücretsiz. Model çıktı olarak uzun metin değil olasılık skorları döndürdüğü için maliyetin neredeyse tamamı girdiden geliyor.
- Microsoft Foundry: ai.azure.com/catalog/models/Microsoft-Decision-1
- OpenRouter: openrouter.ai/microsoft/microsoft-decision-1
- Dokümantasyon: Microsoft Learn
Karşılaştırılan modeller
Microsoft’un benchmark’larda kullandığı diğer modeller: Quyet-1.0-Large, Surogate Rune 26B-A4B, GPT-6 Luna Decisions, deck-31B, H2O-Lightning-4B ve Strands-Decider 2B. Sonradan eklenen Jev 1.13.0 ise doğrulukta ikinci, kalibrasyonda birinci sırada.
Bundan sonrası
Microsoft’a göre agentic AI gerçek olduğundan beri maliyet, insanların AI’ı nasıl kullanacağına karar vermesinde büyük rol oynuyor ve doğru iş için doğru modeli seçmek giderek önem kazanıyor. Agent’lar gerçek dünyada aksiyon alırken decision model’ler, onları karmaşık ortamlarda yönlendirmek ve kontrol etmek için kullanılabilir. Şirket, kaliteyi, güveni ve maliyeti iyileştirmek için modeli güncellemeye devam edeceğini söylüyor.
Decision-1’in önemi tek bir benchmark birinciliğinden çok, işaret ettiği mimari değişiklikte. Agent sistemlerinde çağrıların büyük kısmı aslında metin üretimi değil, “devam mı, dur mu”, “hangi model”, “hangi araç” gibi küçük kararlar. Bunları 85 ms’de ve milyon token başına 4 sente veren bir model, her adımda büyük bir LLM çağırmanın maliyetini ve gecikmesini ciddi şekilde düşürebilir. Bazı noktaları da akılda tutmak gerek: benchmark’ları Microsoft kendisi koşturmuş ve bir kısmı private; doğruluk farkı ikinci sıradaki Jev’e göre sadece 1,2 puan; kalibrasyonda model üçüncü; güvenlik bölümünde ise somut rakam yok. Qwen3.5-9B tabanlı olması da açık modellerin bu kategoride ne kadar rekabetçi olduğunu gösteriyor. Kendi sınıflandırma ya da routing iş yükünüz varsa, fiyat bu kadar düşükken kendi verinizle denemek en sağlıklı karşılaştırma olur.
Kaynak: https://commandline.microsoft.com/microsoft-decision-1-model-foundry/