
Microsoft AI, yeni foundation modeli MAI-Base-2’nin pre-training aşamasını tamamladı. MAI-Base-2, aktif 80 milyar ve toplam 2,8 trilyon parametreye sahip bir Mixture of Experts (MoE) modeli. Haziran’da duyurulan MAI-Thinking-1, bir önceki temel model MAI-Base-1 üzerine post-training ile geliştirilmişti; MAI-Base-2 şu an post-training aşamasında ve Microsoft’un yeni nesil modellerinin temelini oluşturacak.
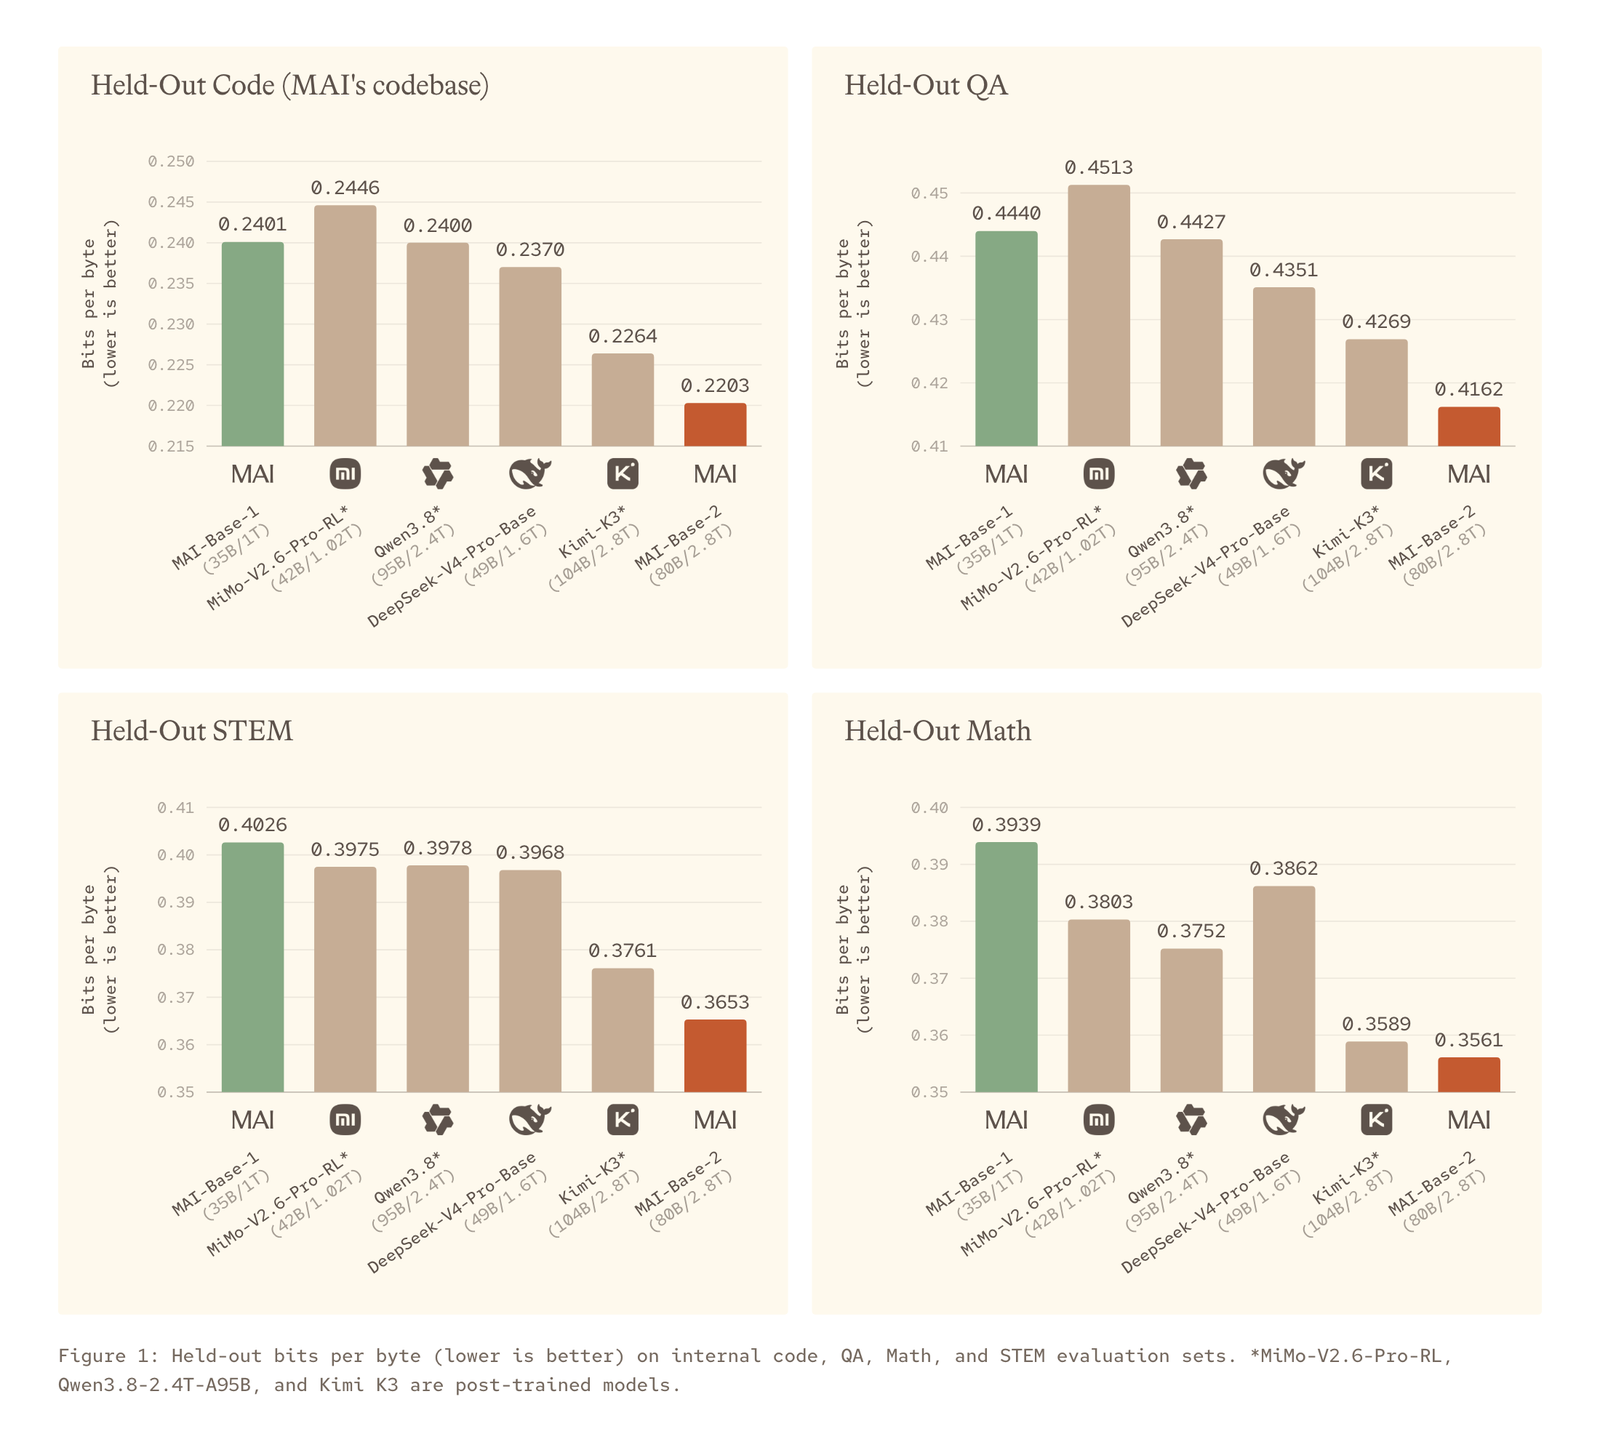
Microsoft AI’ın iddiası iki parçalı. Birincisi, MAI-Base-2 şirketin kendi dışarıda tuttuğu (held-out) değerlendirmelerde test edilen tüm open-weight modelleri geride bırakıyor. İkincisi, en güçlü açık base model olan DeepSeek-V4-Pro-Base’e göre pre-training FLOP’ları açısından 4 ila 12 kat daha verimli; Microsoft bu tasarrufu daha büyük bir model eğitmek için kullanmış.
Neden kendi modelini eğitiyor
Microsoft, model hattının tamamına sahip olmanın müşterilerine farklı bir şey sunmasını sağladığını söylüyor. Modele giren eğitim token’larının kaynağı üzerinde güçlü bir kontrol var ve pre-training, başka modellerden distillation içermeyen organik veriye dayanıyor. Bu da model ağırlıklarının Foundry üzerinden güvenilir partnerlere lisanslanmasını mümkün kılacak. Tüm yığına sahip olmak ayrıca modeli ve altyapıyı en iyi performans ve en düşük maliyet için birlikte ayarlamayı sağlıyor; önce Microsoft’un kendi ürünlerinde, sonra Foundry müşterilerinde.
MAI-Base-2 nasıl eğitildi
MAI-Base-1’den sonra yol açıktı: ölçeği büyütmek. MAI-Base-1 boyutuna göre güçlü bir model olsa da frontier’daki açık ve kapalı modellerden küçüktü. MAI-Base-2’nin başarısında üç çalışma öne çıkıyor:
- Ölçekleme bilimi: tekrarlanan eğitim verisini hesaba katan scaling ladder’lar ve deneysel hiperparametre scaling law’ları.
- Model ve altyapının birlikte tasarlanması: daha iyi MoE ve Muon implementasyonları, buna ek olarak activation gradient clipping.
- Veri ölçekleme: genişletilmiş veri hatları ve görsel verinin eklenmesi.
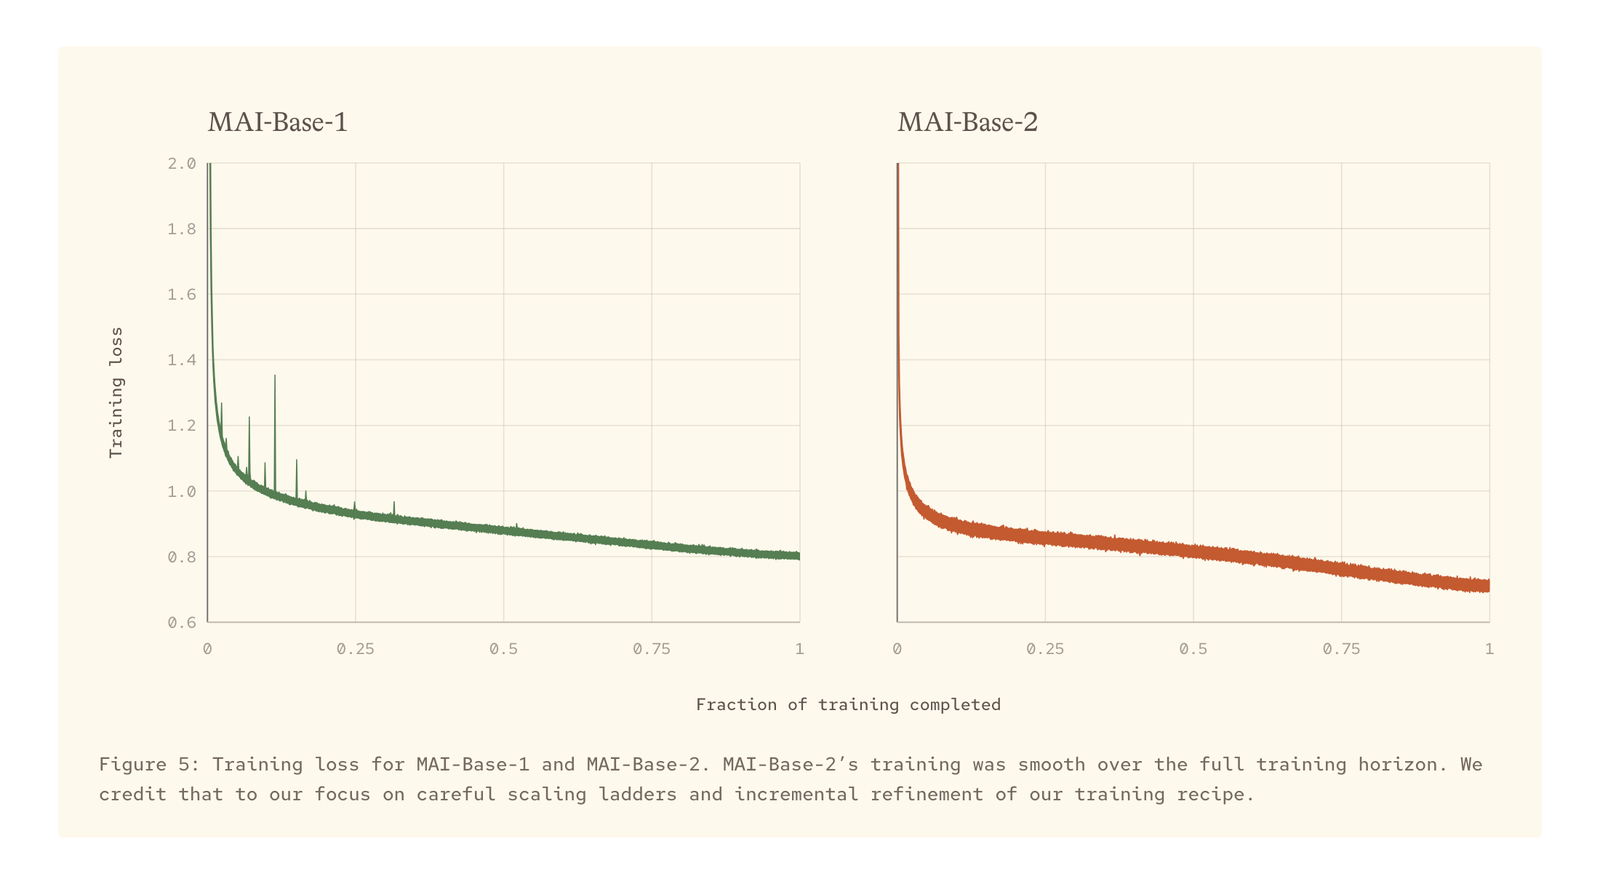
MAI-Base-2, MAI-Base-1’den daha büyük ve daha seyrek (sparse) bir model ve daha fazla veriyle eğitildi. Eğitim Ağustos ve Eylül 2026’da, 16 bin GB200 GPU üzerinde 38 gün sürdü. Eğitim boyunca ortalama MFU (model FLOPs utilization) yüzde 21, goodput (eğitimin ilerlediği zamanın oranı) yüzde 89 oldu.
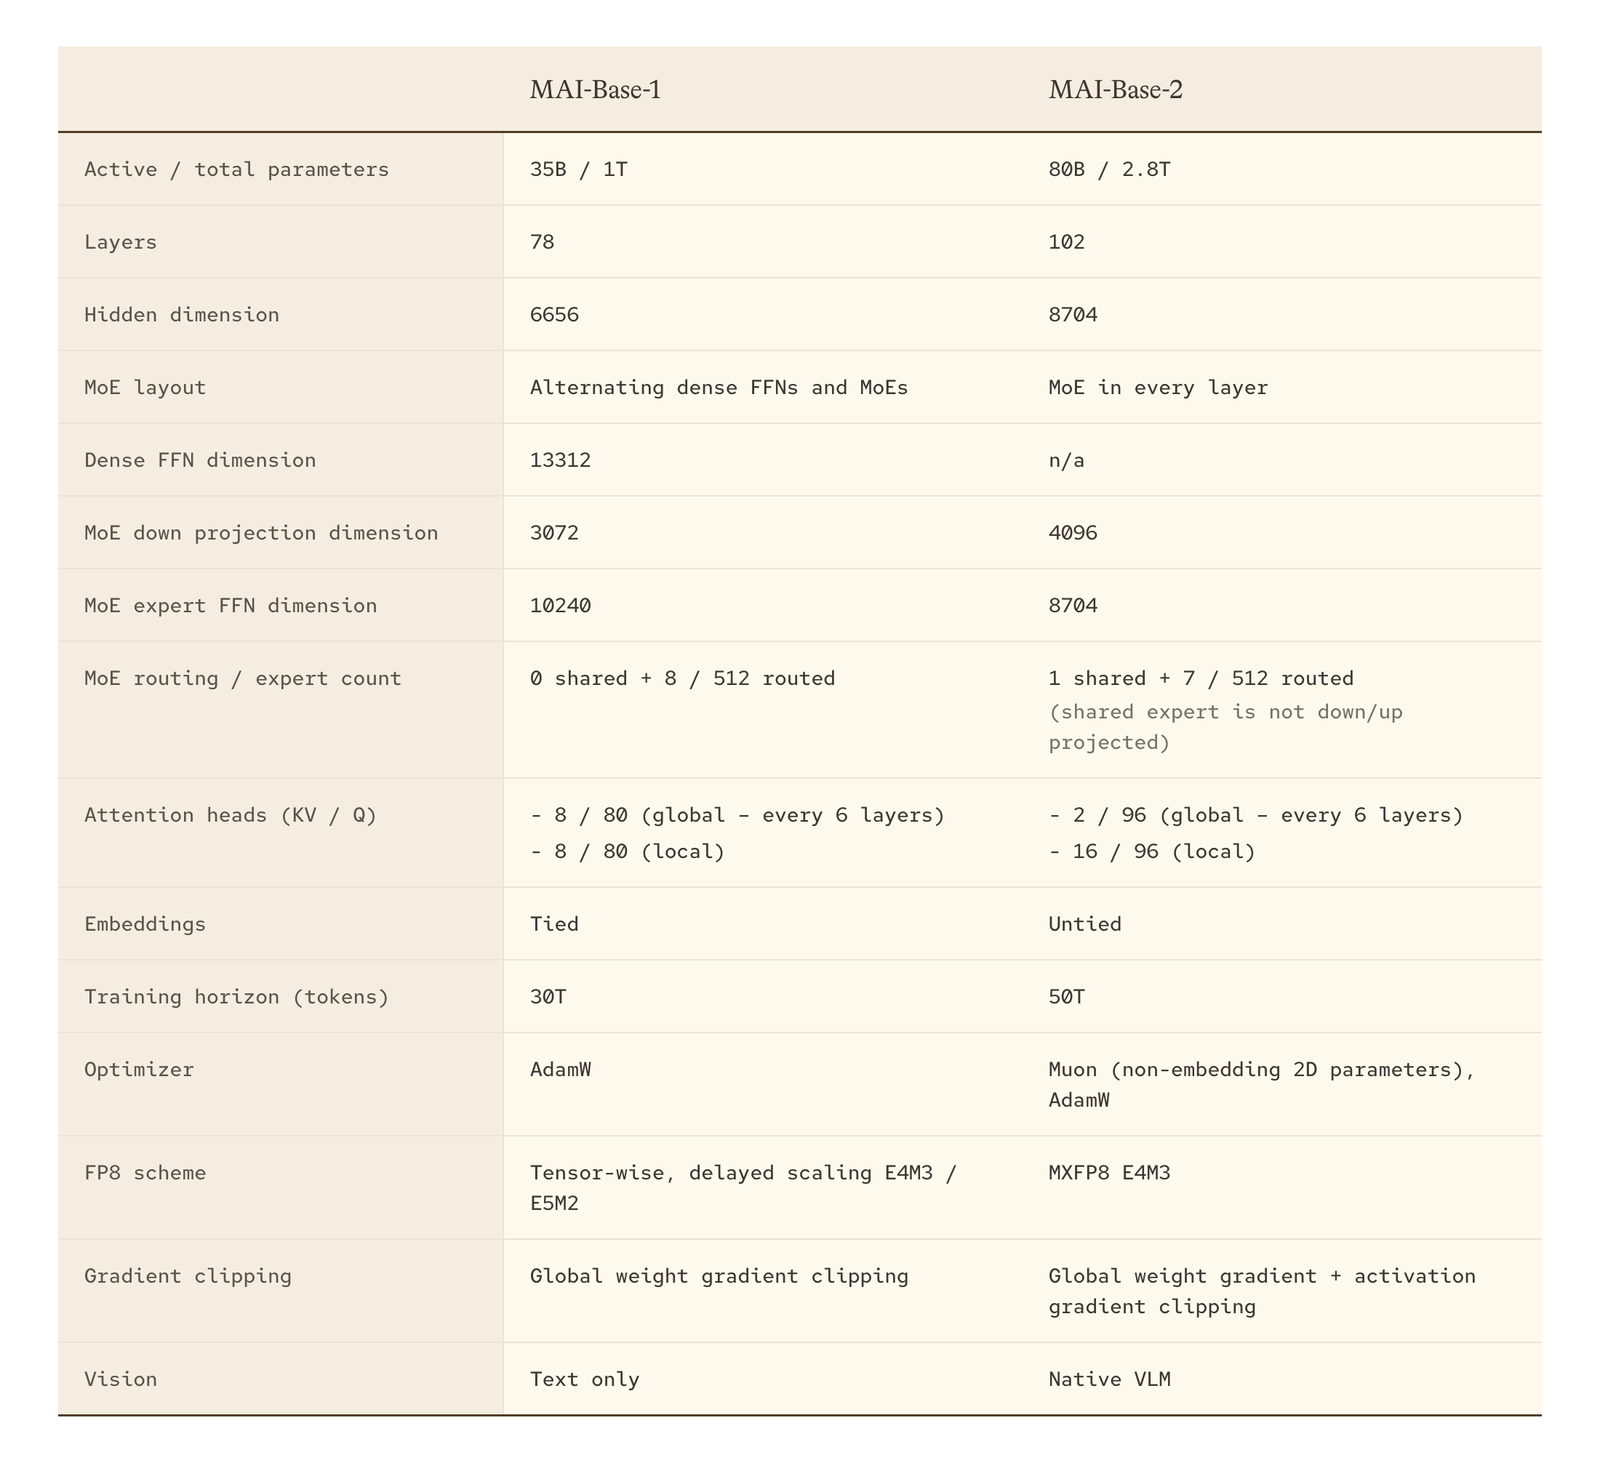
Tablodaki en dikkat çekici farklar: parametre sayısı 35B/1T’den 80B/2,8T’ye, katman sayısı 78’den 102’ye çıkmış; MoE artık dönüşümlü katmanlarda değil her katmanda; eğitim ufku 30T token’dan 50T token’a uzamış; optimizer olarak AdamW yerine (gömme dışındaki 2D parametreler için) Muon kullanılıyor; FP8 şeması MXFP8’e geçmiş ve model artık sadece metin değil, native bir VLM.
Değerlendirme yöntemi
Microsoft, pre-train edilmiş modelleri dışarıda tutulan metinler üzerinde, her modelin tokenizer’ından bağımsız olan bits-per-byte (BPB) metriğiyle karşılaştırıyor. Kod değerlendirmesi için MAI’ın kendi kod tabanı kullanılıyor; STEM, matematik ve soru-cevap setleri ise eğitim verisine sızma riskini azaltmak için dış tedarikçilere hazırlatılmış. Tüm değerlendirme setleri ayrıca eğitim verisine karşı temizlenmiş (decontamination).
Karşılaştırmada Ekim 2026 öncesinde erişilebilen frontier checkpoint’ler kullanılmış. DeepSeek-V4-Pro-Base, open weight’li en yetenekli base model. Kimi K3, Qwen3.8-2.4T-A95B ve MiMo-V2.6-Pro-RL’nin ise sadece post-training görmüş checkpoint’leri mevcut; Microsoft bu sonuçları post-training’in değerlendirmeleri etkileyebileceği notuyla veriyor. Bu dört değerlendirmenin hepsinde MAI-Base-2 en düşük BPB’yi elde ediyor.
Scaling ladder ve source scaling
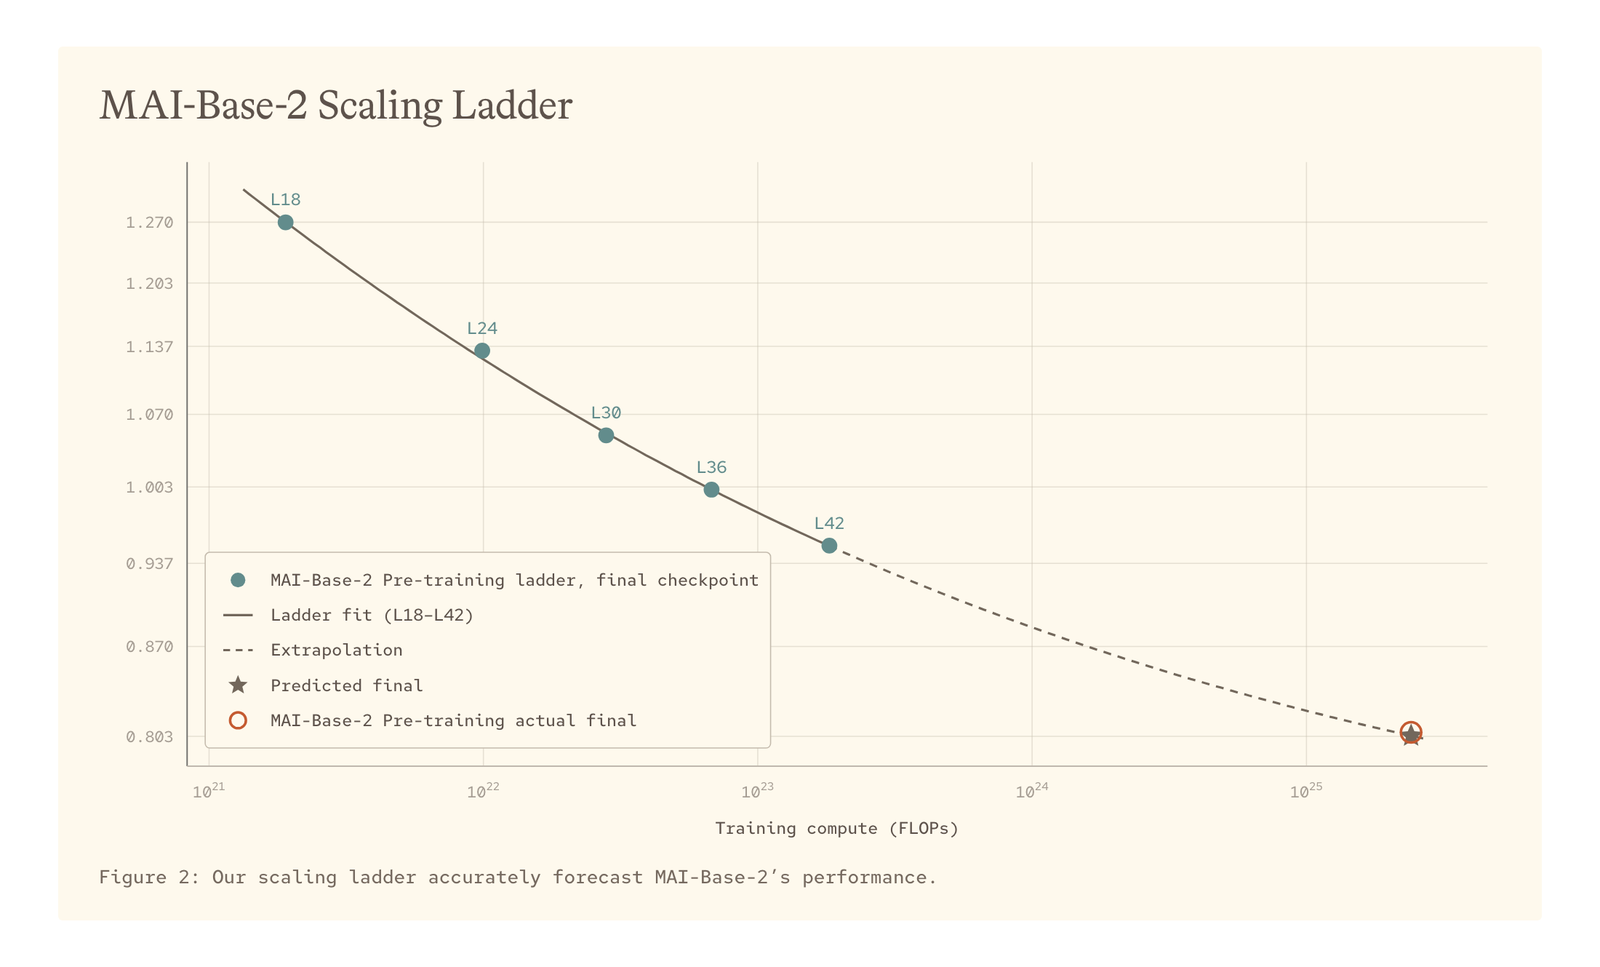
Microsoft, model değişikliklerini bir scaling ladder ile değerlendiriyor: sabit bir eğitim tarifine sahip, farklı boyutlarda modellerden oluşan bir aile. Her basamak katman sayısı L ile adlandırılıyor ve mimarinin geri kalanını sadece L belirliyor; örneğin hidden size (256/3)·L. Model boyutu büyürken aktif parametre başına eğitim token’ı (TPP) sabit tutuluyor.
Küçük ölçekte çok epoch’lu eğitimi doğru yansıtmak için “source scaling” adlı bir teknik kullanılıyor. Alt basamaklarda modelin gördüğü benzersiz örnek sayısı yapay olarak kısıtlanıyor, böylece her veri seti eğitim süresinden bağımsız olarak aynı sayıda tekrarlanıyor. Örneğin bir veri seti 50T token’lık tam eğitimde 8 kez tekrarlanıyorsa, 5T token’lık bir eğitim bu verinin sadece 1/10’u üzerinde 8 kez dönüyor. Bu yapılmazsa küçük ölçekli deneyler, büyük ölçekte overfit olan yetersiz regularize edilmiş mimarileri ve hiperparametreleri öne çıkarabiliyor. Microsoft’a göre source scaling, 2,8T parametreli modele güvenilir şekilde ölçeklenmenin anahtarı oldu.
Verimliliği hesaplama gücünden ayırmak
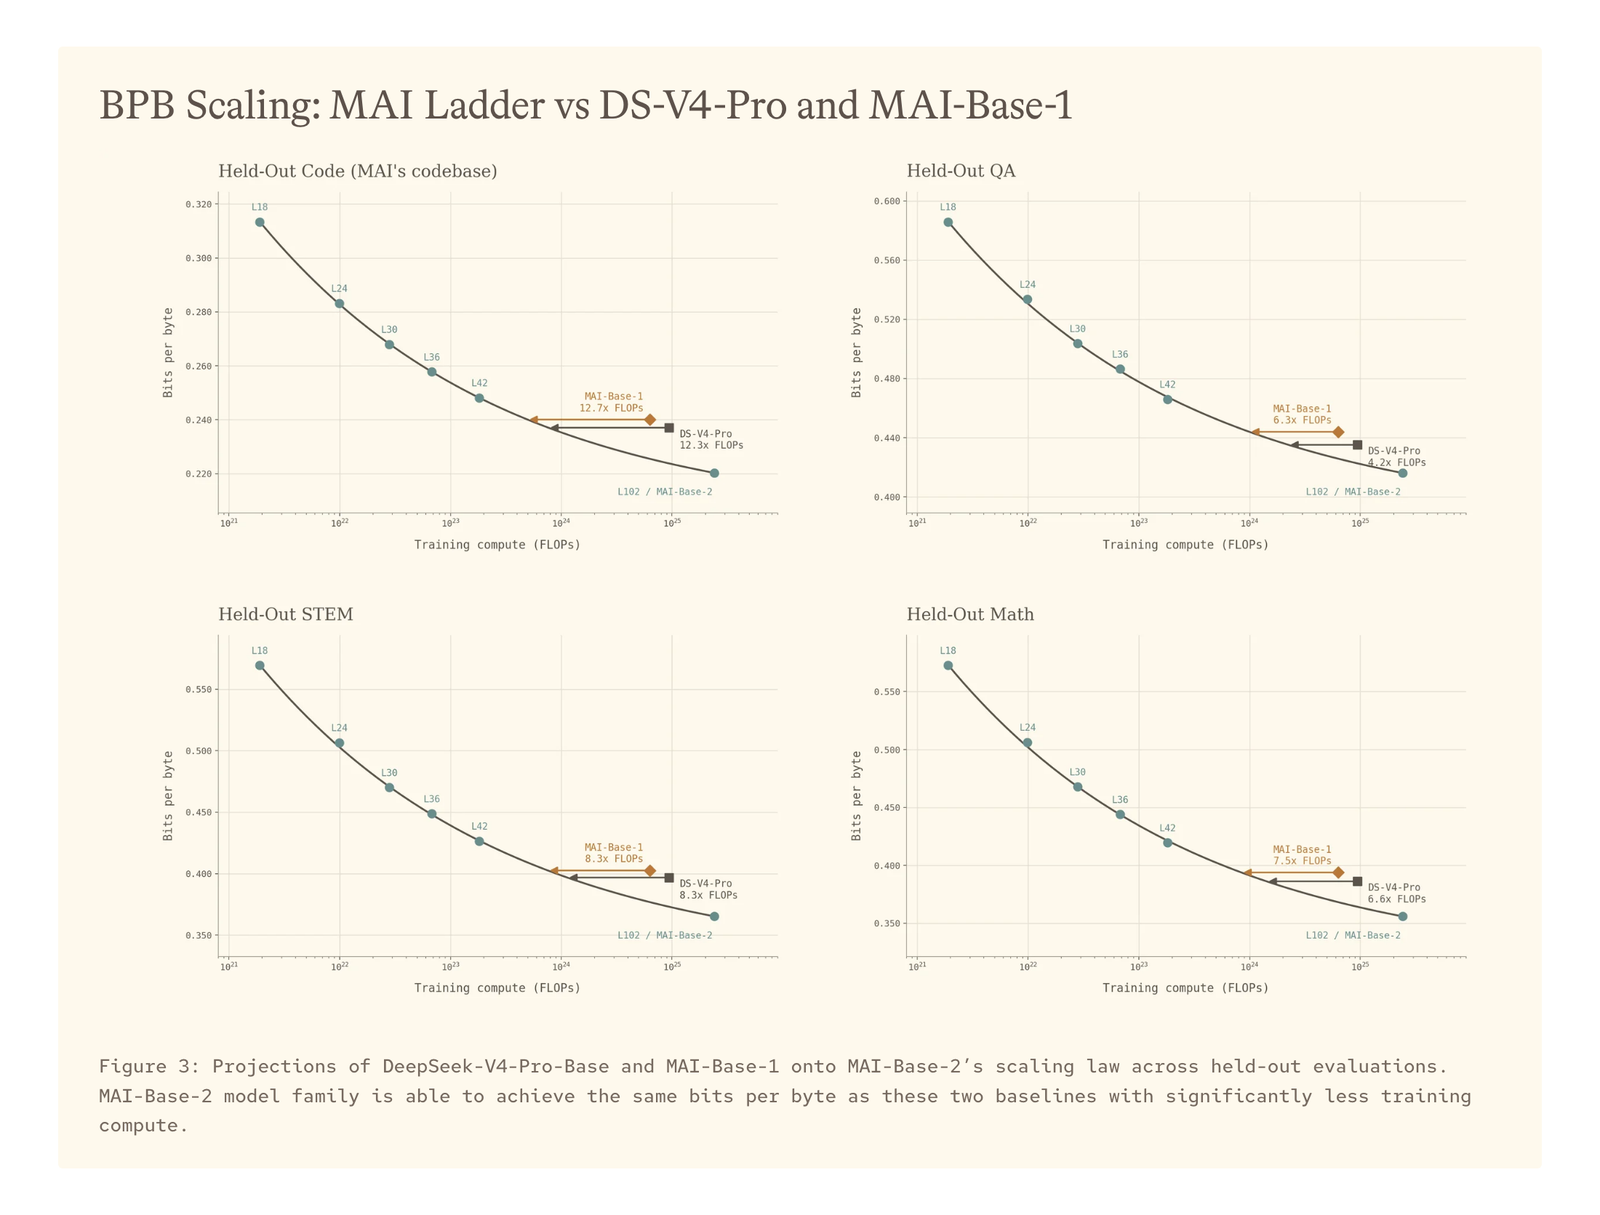
Modelleri doğrudan karşılaştırmak, eğitim tarifinin kalitesini model boyutu ve hesaplama farklarıyla karıştırıyor. Microsoft bunu ayırmak için kendi tarifinin, güçlü bir dış base modelle aynı sonucu almak için ne kadar hesaplamaya ihtiyaç duyacağını tahmin ediyor. Referans olarak DeepSeek-V4-Pro-Base seçilmiş; bir trilyondan fazla parametreye sahip, yayımlanmış tek base pre-training checkpoint’i bu.
Dört değerlendirmenin her biri için BPB’nin eğitim FLOP’larına göre bağımsız bir scaling law’u çıkarılmış. Sonuç: Microsoft’un tarifi DeepSeek-V4-Pro-Base’e göre 4,2 ila 12,3 kat daha FLOP verimli. Haziran’da yayımlanan MAI-Base-1’e göre ise 6,3 ila 12,7 kat verimlilik artışı sağlanmış. Microsoft bu verimliliği veri kalitesine ve modelleme tercihlerine bağlıyor.
Hiperparametreler için scaling law’lar
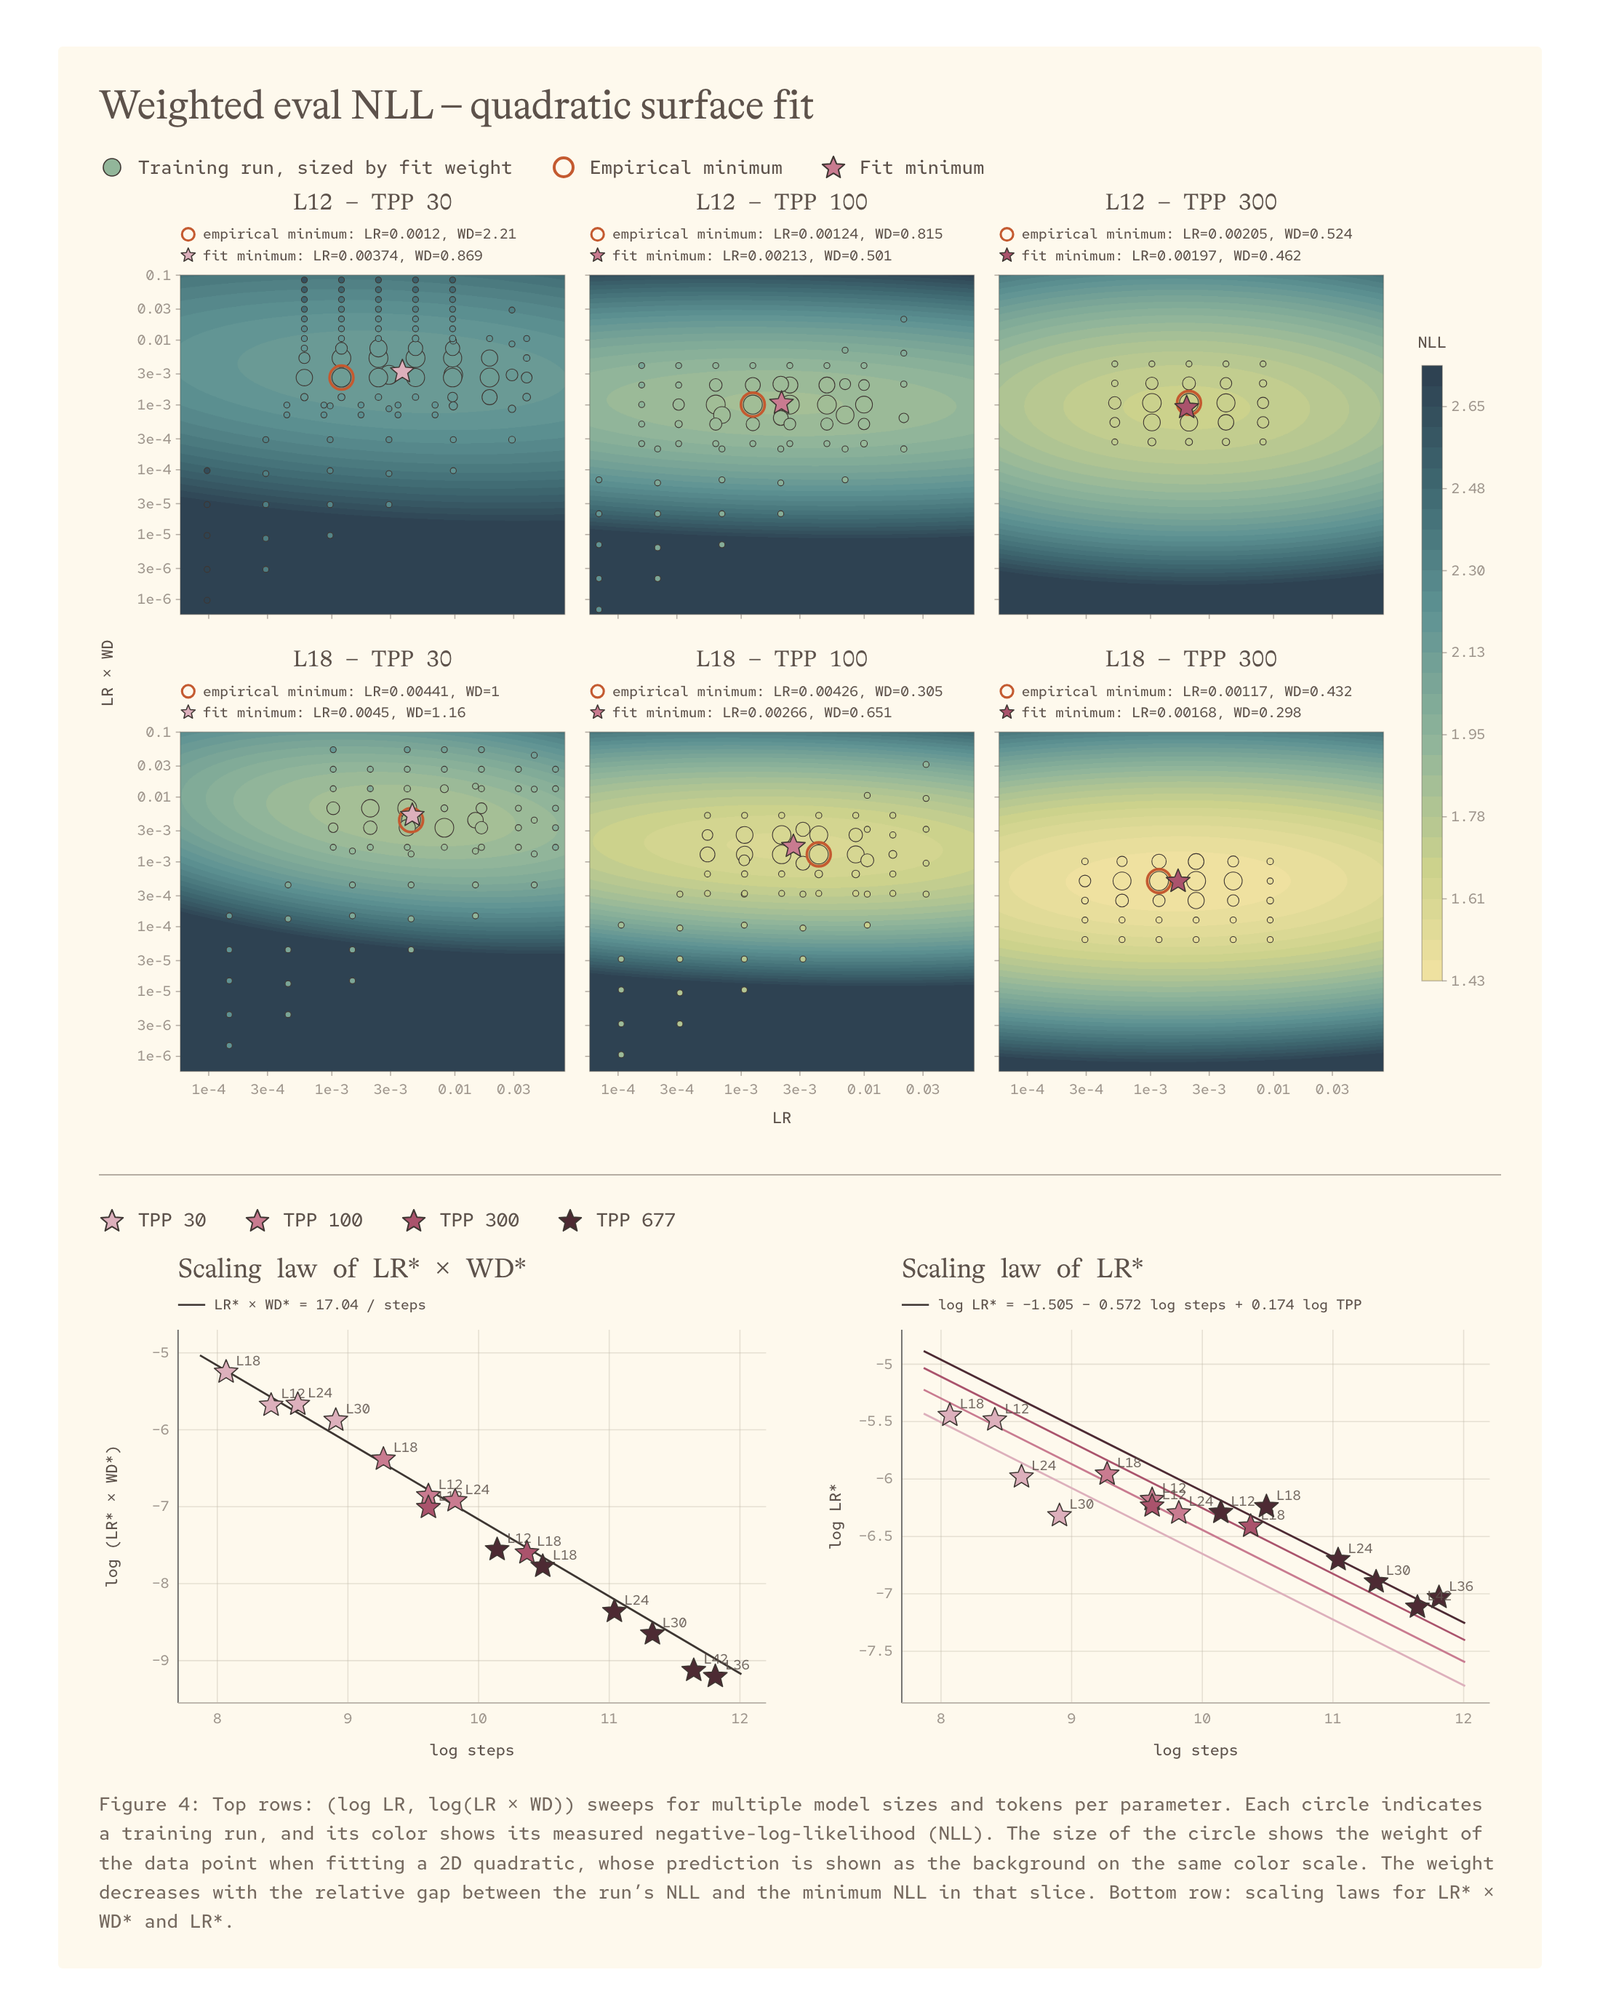
Büyük bir eğitim için hiperparametre seçmek zor, çünkü bir hiperparametreyi değiştirmek diğerlerinin optimum değerini etkileyebiliyor. Microsoft learning rate (LR) ile weight decay’i (WD) birlikte taramış, çünkü performans en çok ikisinin çarpımına duyarlı ve iyi ayarlar (log LR, log WD) düzleminde dar bir çapraz bant üzerinde yer alıyor. Bu yüzden tarama (log LR, log(LR × WD)) üzerinde yapılmış ve sonuçlara 2 boyutlu bir ikinci derece fonksiyon uydurulmuş.
Elde edilen scaling law’lar şunlar:
LR* × WD* = 17.04 / steps
log LR* = -1.51 + 0.175 log TPP - 0.573 log steps
Dropout = sigmoid(0.526 (log ActiveParams - 27.2))
LR × WD için adım sayısına göre üs yaklaşık -1 çıkmış; bu, ayrık weight decay zaman ölçeğinin eğitimin sabit bir oranı olması gerektiği görüşüyle uyumlu. LR’nin üssü ise yaklaşık -0,5; bu da batch size iki katına çıktığında learning rate’in √2 ile çarpılması şeklindeki yaygın kuralla örtüşüyor. Bu kurallar küçük ölçekte bulunup orta ölçekte doğrulanmış ve MAI-Base-2’nin hiperparametrelerini belirlemiş.
Model ve altyapı birlikte tasarlandı
Microsoft kararlarını bir “efficiency gain” (EG) metriğiyle veriyor: bir adayın, baseline ile aynı loss’a ulaşmak için gereken hesaplama oranı. Bu FLOP olarak (EG_FLOPs) ya da gerçek süre olarak (EG_time) ölçülebiliyor. Ekip ağırlıklı olarak altyapının bugünkü durumunu yansıtan EG_time’a bakıyor. FLOP’ta kazandıran ama sürede kaybettiren bir değişiklik ise altyapıya nereye yatırım yapılması gerektiğini gösteriyor.
MoE’yi her katmana taşımak
Önceki deneyler her katmanda MoE kullanmanın, dense FFN ve MoE katmanlarını dönüşümlü kullanmaya göre FLOP açısından tutarlı bir avantajı olduğunu göstermişti. Ancak MoE implementasyonundaki verimsizlikler yüzünden MAI-Base-1’de dönüşümlü yapı daha hızlıydı. MAI-Base-2 için iki sorun tespit edilmiş: dinamik routing’in bellek parçalanmasını artırması ve nadir, aşırı yük dengesizlikleri için bellek ayırması; ve daha çok, daha küçük expert eklemenin expert başına ek yükü artırması. Bunlar çözülünce MoE katmanlarının MFU’su yüzde 24’ten 35’e çıkmış ve her katmanda MoE kullanmak mümkün hale gelmiş.
MoE katmanlarında her expert değişken sayıda token görüyor ve aşırı yüklenen expert’lerin belleği tükenebiliyor. Yaygın çözüm, expert başına bir eşik koyup fazlası token’ları düşürmek; ama Microsoft’un deneylerinde token düşürmek performansı kötüleştirmiş. Bunun yerine geliştirilen çok turlu, token düşürmeyen (dropless) MoE, keyfi routing dengesizliklerinde bile sabit bellek kullanıyor. Expert’ler gruplara ayrılıyor; her grup sabit kapasiteyle dispatch, compute ve collect turları çalıştırıyor. Kapasitesini aşan token’lar ek turlarda işleniyor, aşırı yüklenen expert’ler aynı gruptaki diğer expert’lerin kullanılmayan kapasitesini kullanabiliyor. Pratikte kapasite, normal durumda tek tur yetecek şekilde ayarlanıyor. İletişim ve hesaplama tüm turlar boyunca pipeline halinde çakıştırılıyor.
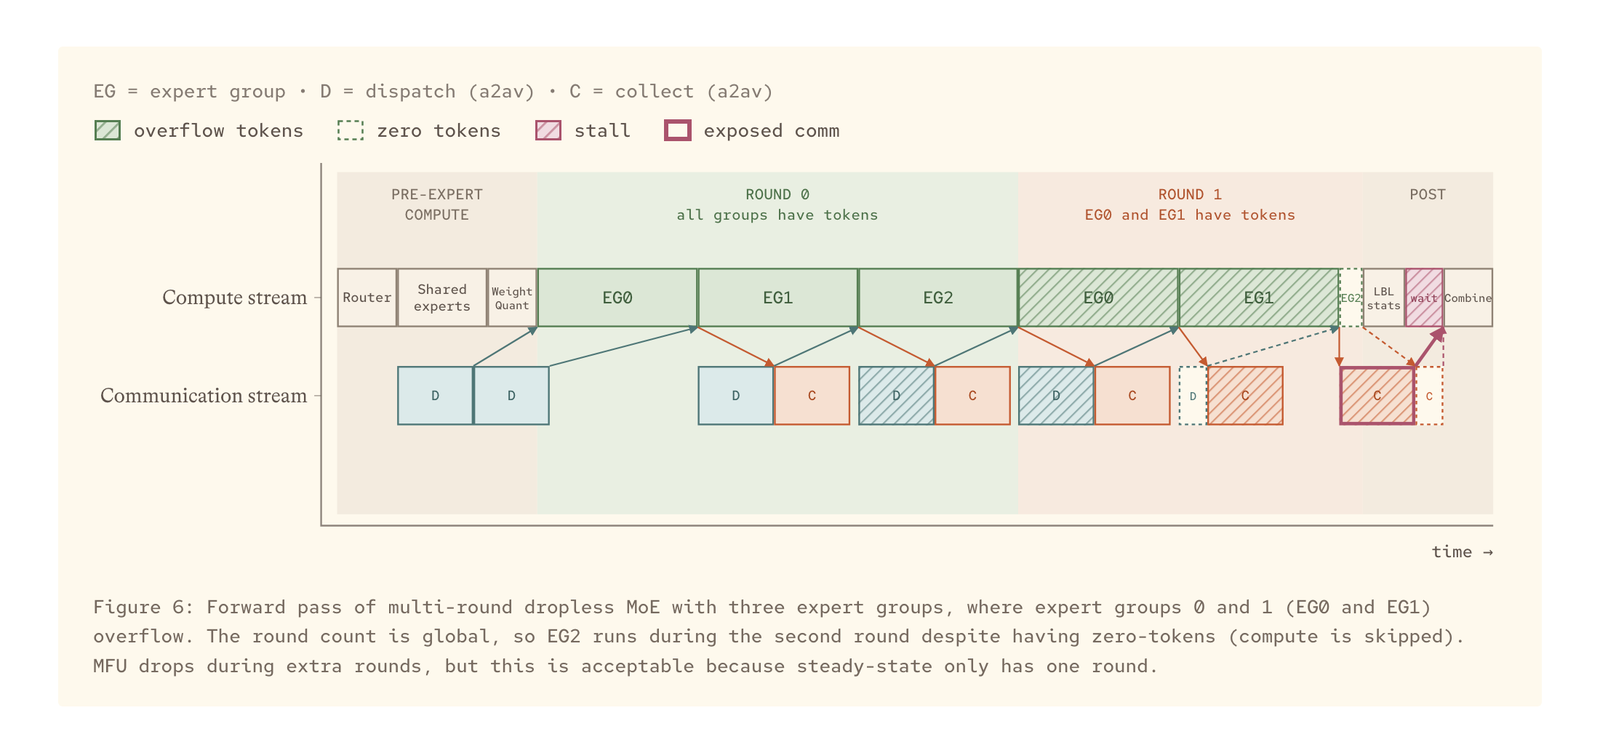
Expert başına ek yük ise dört yolla azaltılmış: her expert grubu için hesaplama ve iletişimi gruplayarak GEMM ve NVLink verimliliğini artırmak; token metadata’sını GPU’da tutup all-to-all iletişimi doğrudan GPU’dan başlatarak host-device senkronizasyonunu azaltmak; simetrik bellek ile token’ları ara kopya olmadan NVLink üzerinden değiştirmek; ve load-balancing loss’unu katman katman değil tek seferde toplu indirgemek.
Muon optimizer’ını ölçeklemek
MAI-Base-2’ye ölçeklenirken Muon, AdamW’ye göre daha kararlı eğitim dinamikleri ve büyük verimlilik kazancı sağlamış. Muon, her ağırlık matrisinin momentumunu Newton–Schulz yöntemiyle ortogonalleştiriyor ve bunun için matrisin tamamına ihtiyaç duyuyor; bu da momentumu data-parallel boyutunda bölen ZeRO ile çelişiyor. Microsoft momentumu optimizer adımında yeniden dağıtarak, all-to-all değişimleriyle her GPU’nun bir grup tam matrisi kendi başına ortogonalleştirmesini sağlıyor. Prefetch, yeniden dağıtım metadata’sının önbelleğe alınması ve MoE router ağırlıkları gibi bazı ağırlıkların kopyalanması gibi optimizasyonlardan sonra Muon, ortalama eğitim adımı süresinin sadece yüzde 2,1’ini (165 ms) tutuyor.
Activation gradient clipping
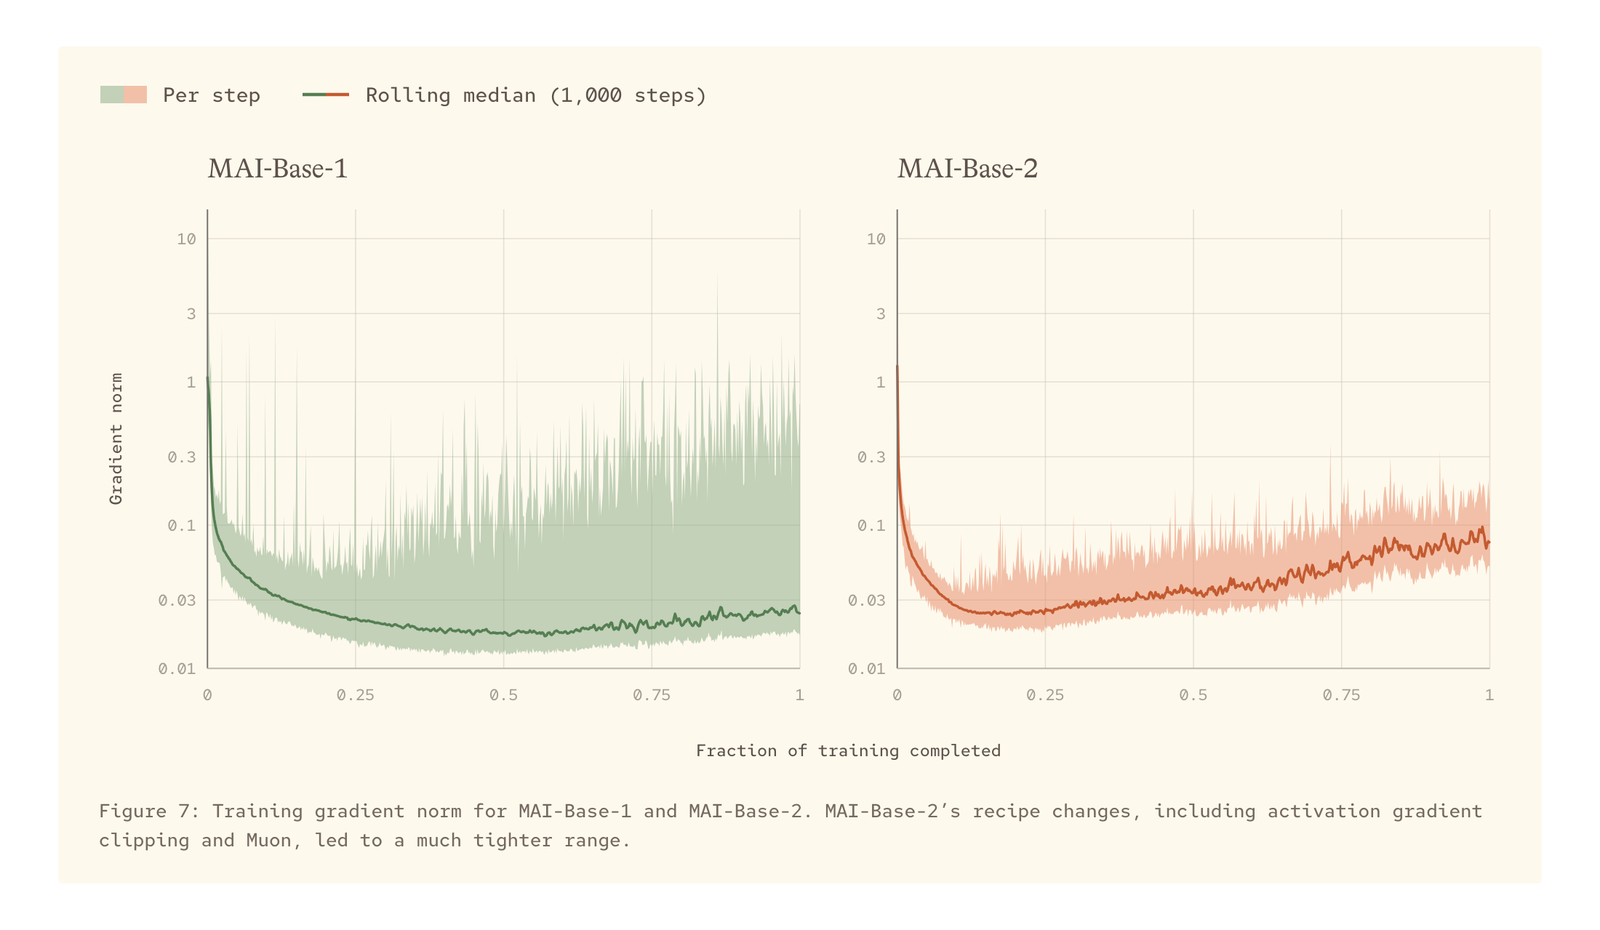
Standart gradient clipping tüm batch’in ağırlık gradyanının global normu üzerinde çalışıyor. Ama aykırı gradyanlar genelde batch içindeki küçük bir veri kısmından kaynaklanıyor ve tek bir aykırı örnek tüm batch’in gradyanlarını küçültebiliyor. Microsoft bunun yerine ağın belirli noktalarında aktivasyonların gradyanlarını kırpıyor. Muon ile birlikte bu, MAI-Base-2’nin gradyan normunu MAI-Base-1’e göre çok daha dar bir aralıkta tutuyor.
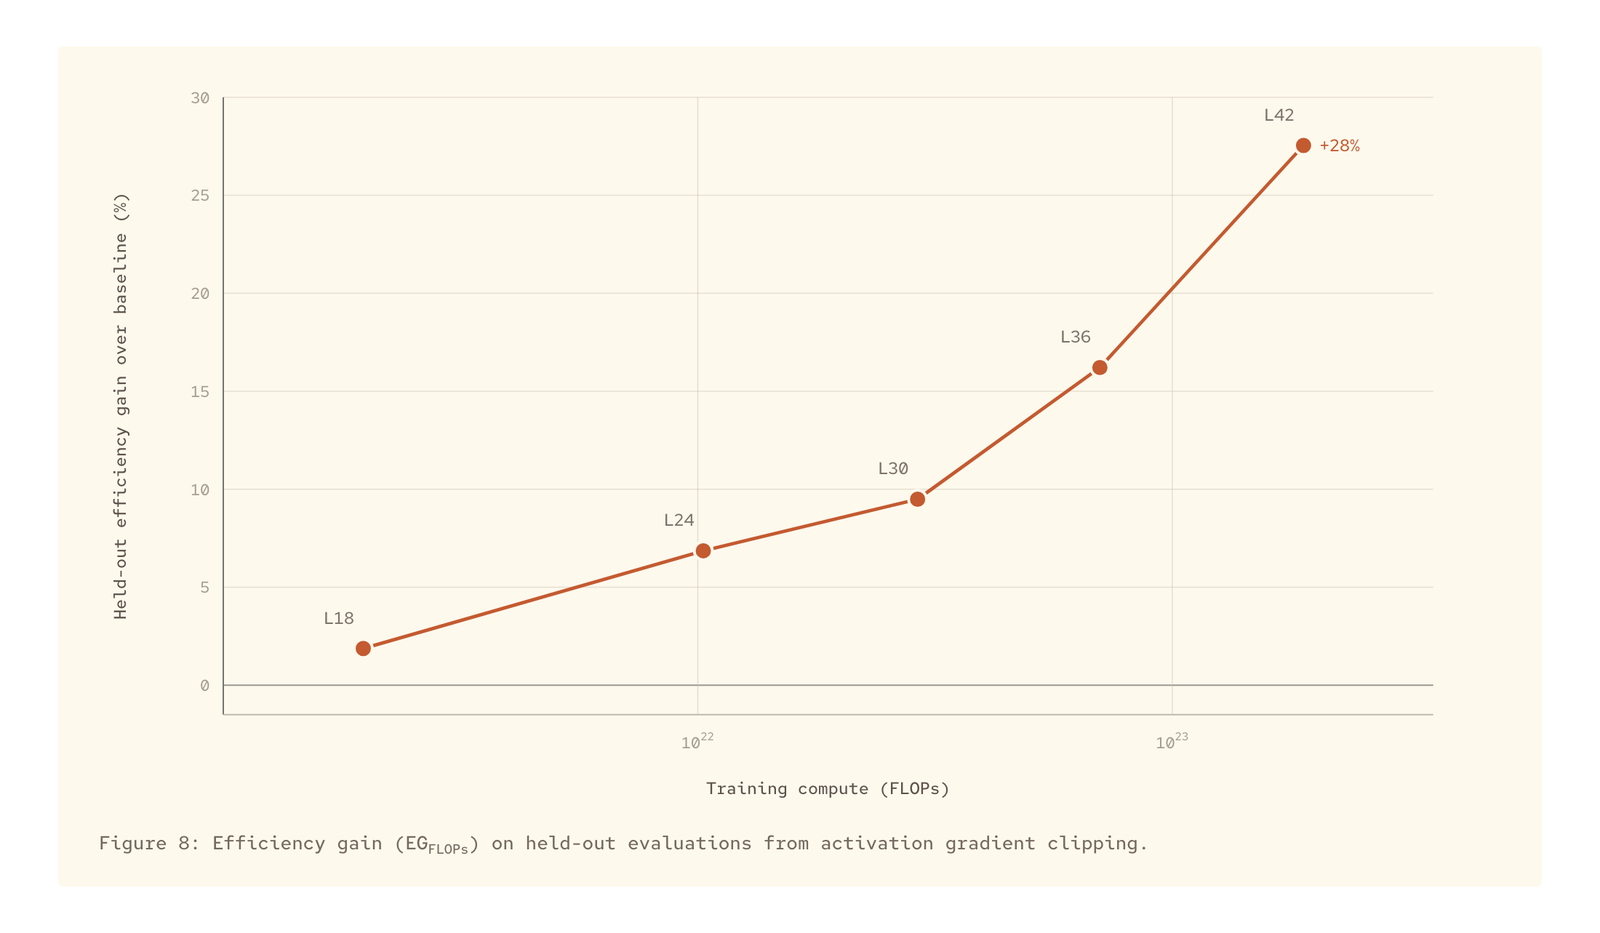
Activation gradient clipping optimizasyonu da daha kararlı hale getirmiş ve ilginç şekilde faydası ölçek büyüdükçe artmış. Test edilen çoğu değişiklik ise ölçekler arasında yaklaşık sabit bir kazanç sağlıyor.
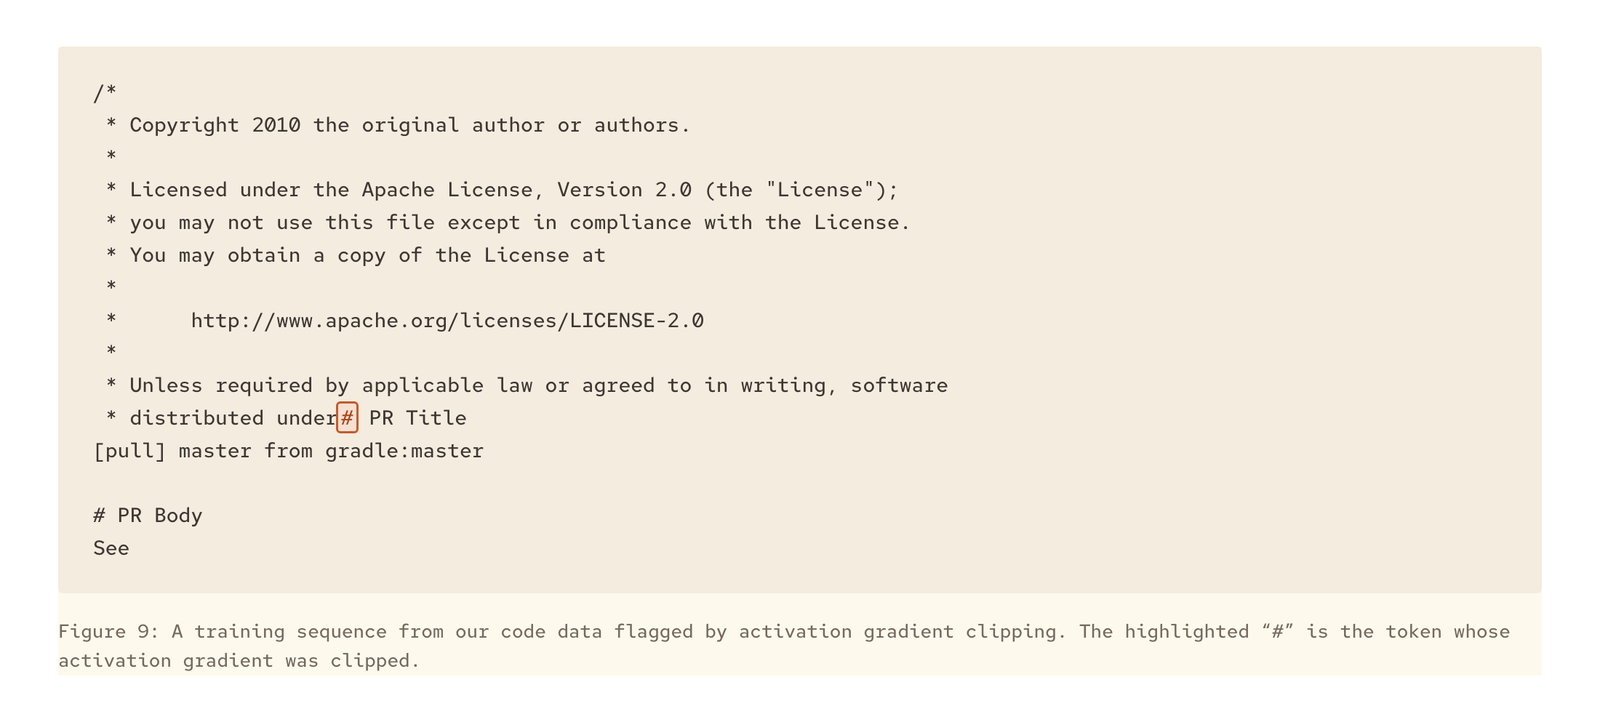
Yöntemin bir yan faydası da var: eğitim verisini doğrulamak için tanı aracı olarak kullanılabiliyor. Activation gradient clipping’in işaretlediği bir örnekte, kod verisindeki bir pull request’te lisans başlığının cümle ortasında kesildiği görülmüş. Bu örneğin izi sürülünce ön işleme hattında bir hata bulunmuş ve düzeltilmiş.
Veri ölçekleme
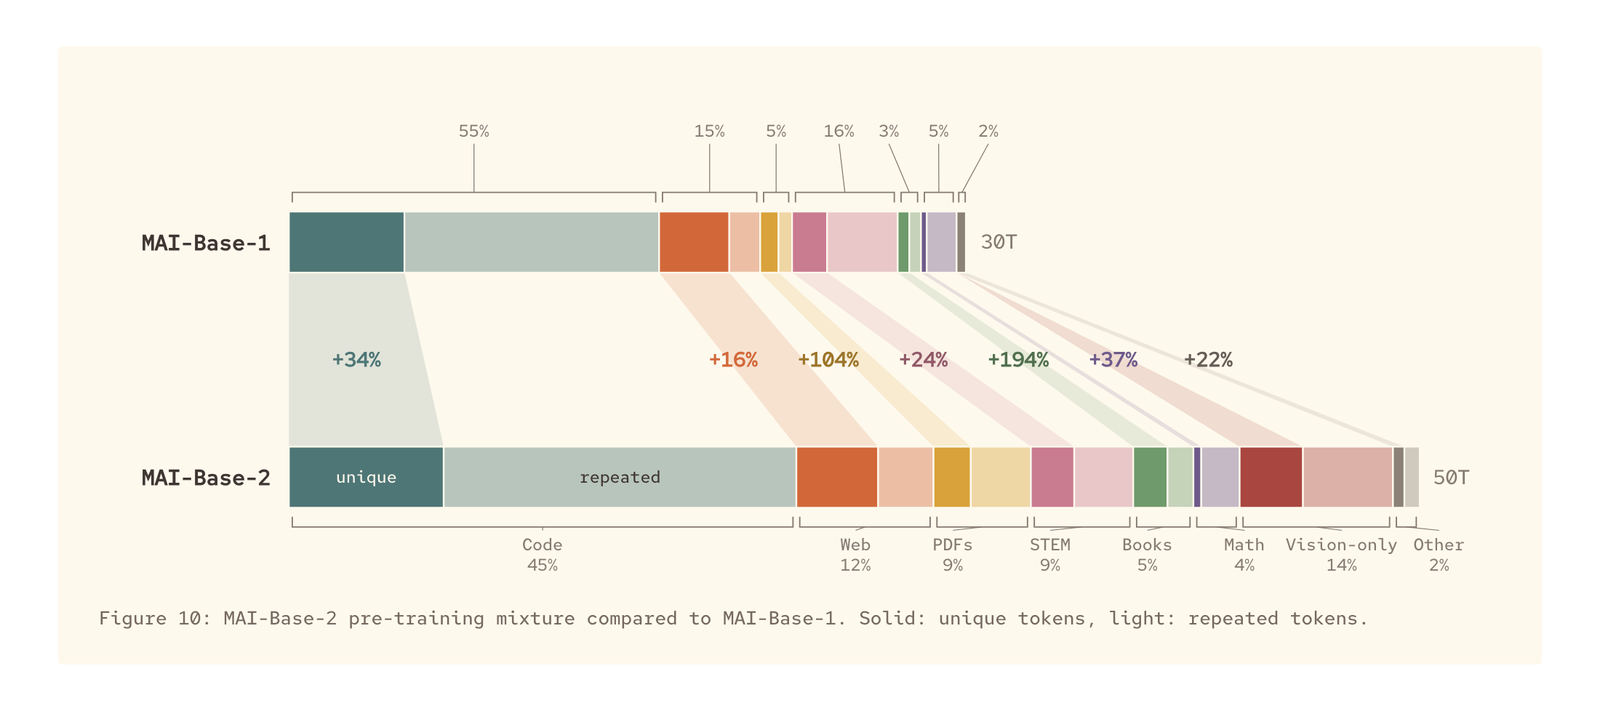
MAI-Base-2, MAI-Base-1 ile aynı veri prensibini izliyor: frontier performansa giden yol başka modellerden distillation değil, organik veri. Tüm eğitim token’ları şirket içinde işlenmiş. Benzersiz eğitim token’ı bazında korpus yaklaşık yüzde 36 büyümüş. Kalite sınıflandırma, konu gruplama, web ayrıştırma, deduplication ve değerlendirme temizliği iyileştirilmiş; web içeriği çok daha fazla işlenmiş ve bilgi kesim tarihi Mart 2026. Embedding tabanlı çeşitlilik örneklemesiyle yeni veriye öncelik verilip tekrar eden içerik azaltılmış.
MAI-Base-1’den farklı olarak MAI-Base-2, encoder kullanmayan bir VLM mimarisiyle baştan görsel veriyle birlikte eğitildi. Görsel-dil korpusu web’den görsel açıklama, grafik anlama, görsel konumlandırma, uzamsal akıl yürütme, tıbbi anlama, computer use ve nota okuma gibi alanları kapsıyor. Bu korpus 4,5T benzersiz token içeriyor ve tekrarlarla birlikte 50T token’lık eğitim karışımının yüzde 18’ini oluşturuyor.
Microsoft, web verisi için robots.txt ve ilgili meta etiketlerine uyan kendi crawler’ını kullandığını; Responsible AI politikalarını ihlal eden kaynakları ve ABD Ticaret Temsilciliği’nin Notorious Markets listesindeki siteleri dışarıda bıraktığını belirtiyor.
Sırada ne var
MAI-Base-2 post-training’den geçerken MAI-Base-3 için hazırlıklar başlamış bile. Microsoft AI tüm modellerini MAI-Base-1’den beri aynı üç prensiple geliştirdiğini söylüyor: zekâ temel prensiplerden öğrenilmeli, basit yöntemler en iyi ölçeklenir ve kestirme yerine bilimsel titizlik.
Bu yazı bir ürün duyurusundan çok bir laboratuvar notu ve frontier pre-training’in nasıl yapıldığına dair alışılmadık derecede ayrıntılı bilgi veriyor. İki noktası özellikle dikkat çekici. Birincisi strateji: Microsoft, OpenAI ortaklığına rağmen 2,8T parametreli kendi frontier base modelini eğitiyor ve ağırlıkları Foundry üzerinden lisanslamayı planlıyor; “distillation yok, organik veri” vurgusu da kurumsal müşterilere yönelik bir güven mesajı. İkincisi rakamlar: karşılaştırmalar BPB üzerinden ve Microsoft’un kendi held-out setleriyle yapılmış; post-training görmüş modellerle base modeli karşılaştırmanın sınırlarını Microsoft da açıkça belirtiyor. Asıl önemli olan, MAI-Base-2 post-training sonrası gerçek görevlerde nasıl performans göstereceği; bunu henüz bilmiyoruz.
Kaynak: https://microsoft.ai/news/frontier-pre-training-at-microsoft-ai/