
Üretken AI girişimleri statik klip üretiminden etkileşimli, gerçek zamanlı dünyalara geçiyor. Google Cloud’un teknik yazısı, AI girişimi Visko‘nun Google Cloud TPU mühendisleriyle birlikte sürekli yayın yapan Live World Model’i Orbis’i Cloud TPU’ya nasıl taşıdığını anlatıyor. Proje başlangıcından production devrine kadar geçen süre sadece 30 gün.
Canlı bir video world model’ini production’da sunmayı zorlaştıran şey ortalama throughput değil, acımasız bir gerçek zamanlı saati yenmek. Kullanıcının bir prompt girip kuyrukta beklediği offline video üreticilerin aksine canlı bir world model sürekli yayın yapıyor. Her yeni video parçası ve senkronize sesi, izleyici bir önceki parçayı izlemeyi bitirmeden render edilmeli; yoksa dünya donuyor.
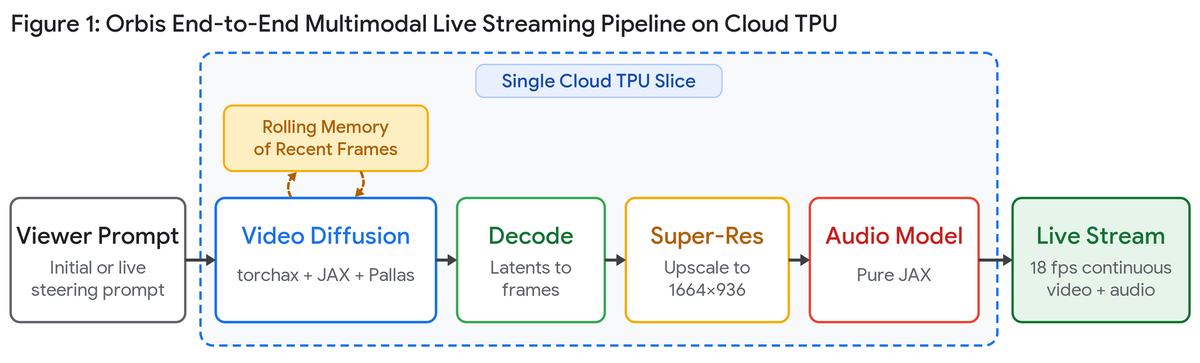
Visko ve Google Cloud mühendisleri, video üretimi, süper çözünürlük ölçekleme ve senkronize sesi birleştiren uçtan uca canlı inference hattını tek bir Cloud TPU slice üzerine yerleştirdi ve oynatma hızının 1,07 katında render elde etti.
Live World Model nedir?
Çoğu üretken video platformu önceden pişirilmiş sabit klipler üretirken Visko, sürekli üreten ve anında tepki veren video world model’leri, yani “Live Model”ler geliştiriyor. Visko’nun amiral gemisi modeli Orbis, tek bir metin ya da görsel prompt’tan başlayarak canlı video akışı sağlıyor. Yayın devam ederken izleyiciler yeni yönlendirme prompt’ları girebiliyor ve sahne, sürekliliği bozmadan ya da baştan başlamadan değişiyor. Örneğin bir test oturumunda yayın, çıtırdayan bir şöminenin yanında uyuyan bir kediyle açılıyor; izleyici sahneye bir mama kabı eklediğinde kap sorunsuzca beliriyor, kedi gerinip kalkıyor ve miyavlıyor.
Orbis’in 1 Eylül 2026’da açılan public demosu; etkileşimli eğlence, canlı ticaret, AI arkadaşlar, sürükleyici eğitim ve robotik simülasyonu gibi alanlarda yeni olanaklar sunuyor. Visko, bu etkileşimli oturumları güvenilir şekilde ölçeklemek için Ağustos 2026’da Google Cloud TPU mühendisleriyle çalışmaya başladı ve 30 gün içinde tüm çok modlu hat TPU’larda gerçek zamanlı çalışır hale geldi.
Visko, Cloud TPU ekosistemine heyecan verici yeni bir gerçek zamanlı, yönlendirilebilir iş yükü sınıfı getiriyor. Canlı çok modlu hatlarını JAX, torchax ve özel Pallas kernel’leriyle tek bir TPU slice üzerinde birlikte geliştirerek, küçük bir girişim ekibinin bir PyTorch prototipinden Google Cloud’un AI Hypercomputer’ında oynatma hızının 1,07 katında render’a ne kadar hızlı geçebileceğini gösterdik.
Dave Elliott, Head of Developer Advocacy for AI, Google Cloud
Canlı video, katı bir zaman sınırı problemi
Offline bir klip üreticisinde gecikme affedilebilir; kullanıcı bir kez bekler. Canlı bir world model’in bekleme salonu yok. Her parçanın denoise edilmesi, latent’lerden decode edilmesi, 18 fps’de 1664×936’ya ölçeklenmesi ve üretilen sesle eşleştirilmesi, oturum sürdüğü sürece gerçek zamanlı oynatma hızından daha hızlı tamamlanmalı. İki yapısal kısıt bunu standart batch inference’tan çok daha zor hale getiriyor:
- Batch boyutu bir: Her canlı yayın tek bir izleyicinin etkileşimli oturumu. Hızlandırıcıları doymuş tutmanın standart yolu olan düzinelerce eşzamanlı isteği büyük bir batch’te toplayarak gecikmeyi gizlemek mümkün değil.
- Katı ardışık bağımlılık: Her parça doğrudan bir öncekine bağlı. Video modeli, N+1. parçanın N. parçadaki hareketi akıcı şekilde sürdürmesi için son video latent’lerinin kayan bir hafızasını tutuyor; parçaları sırasız önceden render etmek ya da gelecekteki zaman damgalarını paralelleştirmek mümkün değil.
LLM serving’den gelen altyapı mühendisleri için canlı world modeling’i saniye başına token throughput benchmark’ı değil, affetmeyen bir adım başına gecikme SLO’su olarak düşünmek faydalı.
Çok modlu hattın tek bir TPU slice üzerindeki mimarisi
Altyapıyı yalın ve uygun maliyetli tutmak için ekip, BF16 hassasiyetinde çalışan tek bir Cloud TPU slice üzerinde üç ayrı üretken modeli zincirledi. Bir izleyici ilk prompt’u ya da canlı bir yönlendirme güncellemesi gönderdiğinde video diffusion modeli, süper çözünürlük ölçekleyici ve ses üreticisi aynı çipleri paylaşıyor ve her parça için donanımı sırayla kullanıyor.
Yazılım yığını üç açık kaynak temel üzerine kurulu:
- JAX: Google’ın hızlandırıcılar için yüksek performanslı Python dizi kütüphanesi; XLA derleyicisiyle optimize makine koduna derleniyor.
- torchax: PyTorch modellerini JAX üzerinden doğrudan Cloud TPU’da çalıştıran bir uyumluluk katmanı; girişim ekiplerinin mevcut PyTorch bileşenlerini baştan yazmadan taşımasını sağlıyor.
- Pallas: JAX’te TPU’lar için özel kernel programlama dili.
Gerçek zamanlı performans dökümü
Her aşama BF16’da tek bir slice üzerinde profillenip optimize edilerek parça başına toplam gecikme hedefin altına indirildi ve canlı yayındaki dalgalanmaları karşılamak için yaklaşık yüzde 7 pay bırakıldı.
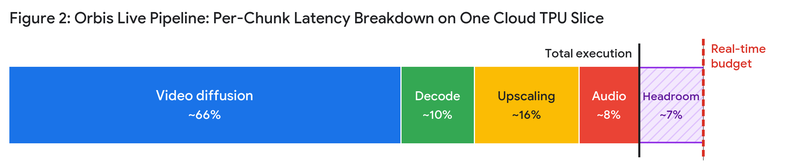
Video denoising toplam hesaplama bütçesinin neredeyse üçte ikisini oluşturduğu için kernel ve paralellik optimizasyonlarının ana odağı bu aşama oldu.
Gerçek zamanlı yayını mümkün kılan üç optimizasyon
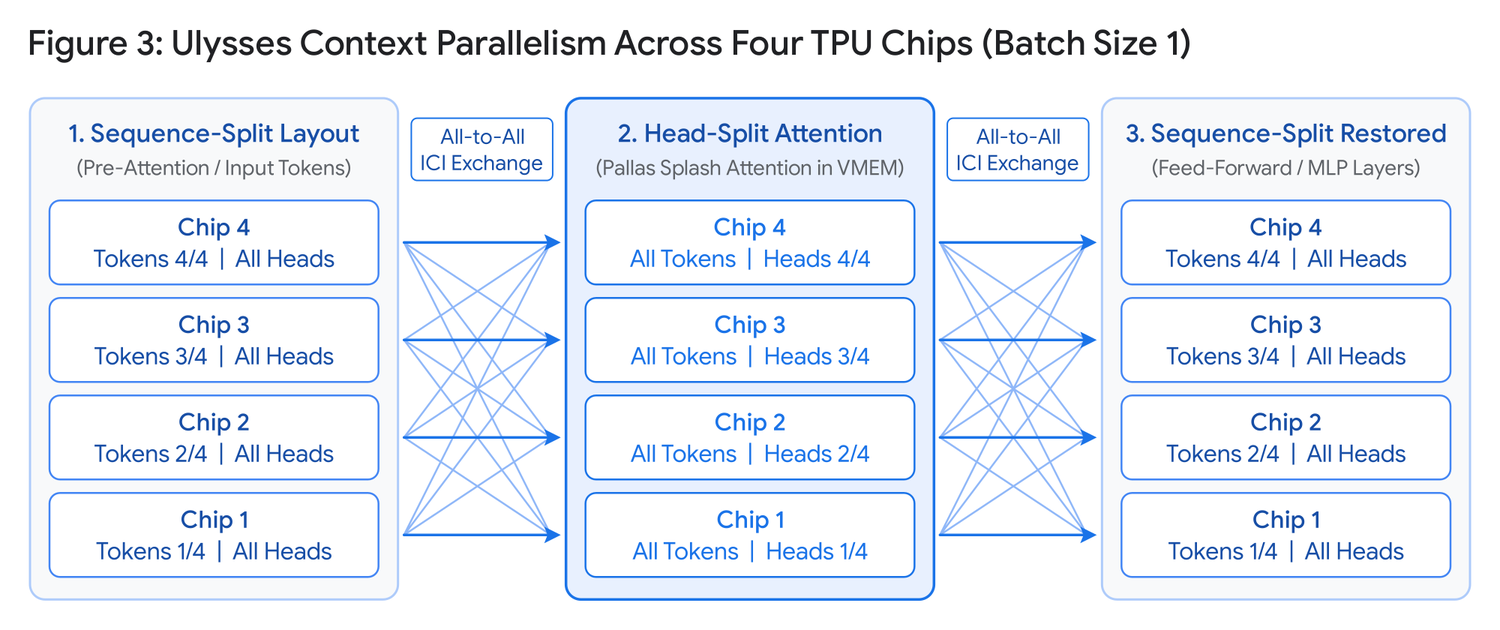
1. Tüm TPU çiplerinde Ulysses context parallelism. Bir video parçası, video transformer içinde devasa bir uzay-zamansal token dizisine dönüşüyor. Bu iş yükünü batch boyutu birken TPU çiplerine dağıtmak için ekip Ulysses context parallelism kullandı. Ulysses model ağırlıklarını değil, token dizisini çiplere bölüyor. Attention katmanından hemen önce yüksek hızlı bir all-to-all değişim, tensörleri her çip tüm video dizisini ama attention head’lerinin sadece dörtte birini tutacak şekilde yeniden grupluyor. Her çip kendi head’leri için tüm dizi üzerinde attention hesapladıktan sonra ikinci bir all-to-all değişim, feed-forward katmanları için dizi bölünmüş yapıyı geri getiriyor.
2. MaxDiffusion’dan özel Pallas splash attention. Attention hesaplamasını hızlandırmak için ekip, Google Cloud’un Cloud TPU üzerinde diffusion modelleri için açık kaynak referans kütüphanesi MaxDiffusion‘dan özel bir Pallas splash attention kernel’i entegre etti. Splash attention, FlashAttention tarzı parçalama (tiling) yaklaşımını TPU mimarisine getiriyor: tüm karesel attention matrisini HBM’de oluşturmak yerine attention’ı çip üzerindeki çok hızlı VMEM’de kalan küçük parçalarda hesaplıyor. Bu portta kullanılan kernel custom_splash_attention.py dosyasından doğrudan alınabiliyor.
3. torchax’tan saf JAX’e geçişle ses modelinde 5,8 kat hızlanma. Üç Orbis modeli de önce, PyTorch kodunu yeniden yazmadan JAX ve XLA üzerinden TPU’da çalıştıran torchax ile Cloud TPU’ya taşındı. Video ve ölçekleme modelleri için torchax ile Pallas attention kernel’leri gecikme hedefini doğrudan karşıladı ve iki model son hatta da torchax’ta kaldı. Sadece ses modelinin yeniden yazılması gerekti; ses aşamasını torchax’tan native JAX’e taşımak onu 5,8 kat hızlandırdı ve tüm hattı oynatma süresinin altına indirdi.
AI geliştiricileri için Cloud TPU notları
- Tek akışlı video için Ulysses context parallelism: Batch boyutu birken token dizisini all-to-all değişimlerle çiplere bölmek hem tensor parallelism’den hem ring attention’dan daha hızlıydı.
- Sürekli akışlar için native BF16: FP8 quantization bellek bant genişliği baskısını azaltıyor, ama sürekli bir akışta küçük quantization hataları parçalar boyunca birikiyor. Native BF16 gecikme bütçesi içinde görsel kaliteyi korudu.
- Seçici JAX taşıma: torchax sayesinde video ve ölçekleme modelleri PyTorch’ta kaldı, ekip sadece darboğaz olan ses modelini native JAX’te yeniden yazdı.
- XLA derleme önbelleği: İlk açılışta XLA grafiklerinin derlenmesi birkaç dakika sürüyor; derlenmiş çıktıları önbelleğe almak worker yeniden başlatmalarını bir dakikanın altına indiriyor.
Nereden başlanır
Canlı video, world model ya da çok düşük gecikmeli çok modlu inference üzerinde çalışan girişimler aynı araç setini kullanabilir: MaxDiffusion’daki açık kaynak splash attention kernel’i ve Pallas dokümantasyonu, PyTorch modellerini hızla TPU’ya taşımak için torchax ve darboğazları bulmak için Cloud TPU Profiler, uzun vadeli rezervasyon olmadan kısa geliştirme ve benchmark çalışmaları için TPU Flex-start VM‘ler ve cloud kredisi ile teknik mentorluk için Google for Startups Cloud Program.
Bu yazı, canlı video üretiminin LLM serving’den ne kadar farklı bir problem olduğunu iyi anlatıyor: batch’leme ile gecikmeyi gizleyemediğiniz, her parçanın bir öncekine bağlı olduğu bir sistemde tek ölçüt adım başına gecikme. Bence en öğretici iki not şunlar: FP8’in sürekli akışta hata biriktirdiği için BF16’da kalınması ve tüm hattı yeniden yazmak yerine sadece darboğazdaki ses modelinin JAX’e taşınması. Yüzde 7’lik pay ve 1,07 kat hız gerçek zamanlı sınırın ne kadar dar olduğunu da gösteriyor. Tabii bu bir Google Cloud müşteri hikâyesi; aynı iş yükünün GPU’larda nasıl performans gösterdiğine dair bir karşılaştırma yazıda yer almıyor.