
Bir ajanı değerlendirirken sorulan bazı sorular dar ve tekrarlanabilir: Bu yanıt politikaya uydu mu? Bu araç çağrısı onaylanabilir mi? Yanıt alınan bağlamla uyuşuyor mu? AWS’nin yeni yazısı, bu tür sorular için karar modellerinin (decision model) Amazon Bedrock AgentCore Evaluations’a nasıl bağlanacağını anlatıyor. Örnekte iki arka uç var: TypeSafe’in barındırılan modeli Jev ve kendiniz çalıştırdığınız açık kaynak Strands Decider 2B.
AgentCore Evaluations; geliştirme sırasında isteğe bağlı, saklanan oturumlarda toplu ve üretim trafiğinde çevrim içi değerlendirme yapıyor. 15 yerleşik değerlendiricinin yanı sıra LLM-as-a-judge ve AWS Lambda üzerinde çalışan kod tabanlı özel değerlendiricileri destekliyor. Karar modelleri kod tabanlı değerlendiriciler üzerinden bağlanıyor.
Karar modeli nedir?
Sabit seçenekler arasından seçim yapmak için eğitilmiş küçük, uzmanlaşmış bir model. Serbest metin yerine önceden tanımlı yanıtlar üzerinde kalibre edilmiş bir olasılık dağılımı döndürüyor; bu değere eşik koyabilir, toplayabilir ve programla işlem yapabilirsiniz. Jev ve 2 milyar parametreli Strands Decider üç soru tipini destekliyor:
- noul: Evet/hayır sorusu; 0 (hayır) ile 1 (evet) arasında olasılık döndürür.
- choice: En fazla 255 seçenekten hangisinin geçerli olduğunu sorar; en olası seçeneği, dağılımı ve güveni döndürür.
- score: 2-10 sıralı seviyeden hangisinin geçerli olduğunu sorar; olasılık ağırlıklı skor, dağılım ve güven döndürür.
Bunlar LLM değerlendiricilerinin yerine geçmiyor. Kanıtları birleştirmek ya da eksik bilgiyi bulmak gerektiğinde ve açıklamanın da skor kadar faydalı olduğu işlerde yerleşik değerlendiriciler daha uygun. Karar modelleri bunların yanında dar ve net kontroller için kullanılıyor.
Çözüm: İK asistanı örneği
Örnek, Strands Agents ile yazılıp AgentCore Runtime’a dağıtılan bir İK asistanını deterministik kontroller, yerleşik LLM değerlendiricileri ve karar modelleriyle birlikte değerlendiriyor. Ajanın izin bakiyesi, izin talebi, politika, yan haklar ve maaş bordrosu için sabit örnek veri döndüren beş aracı var.
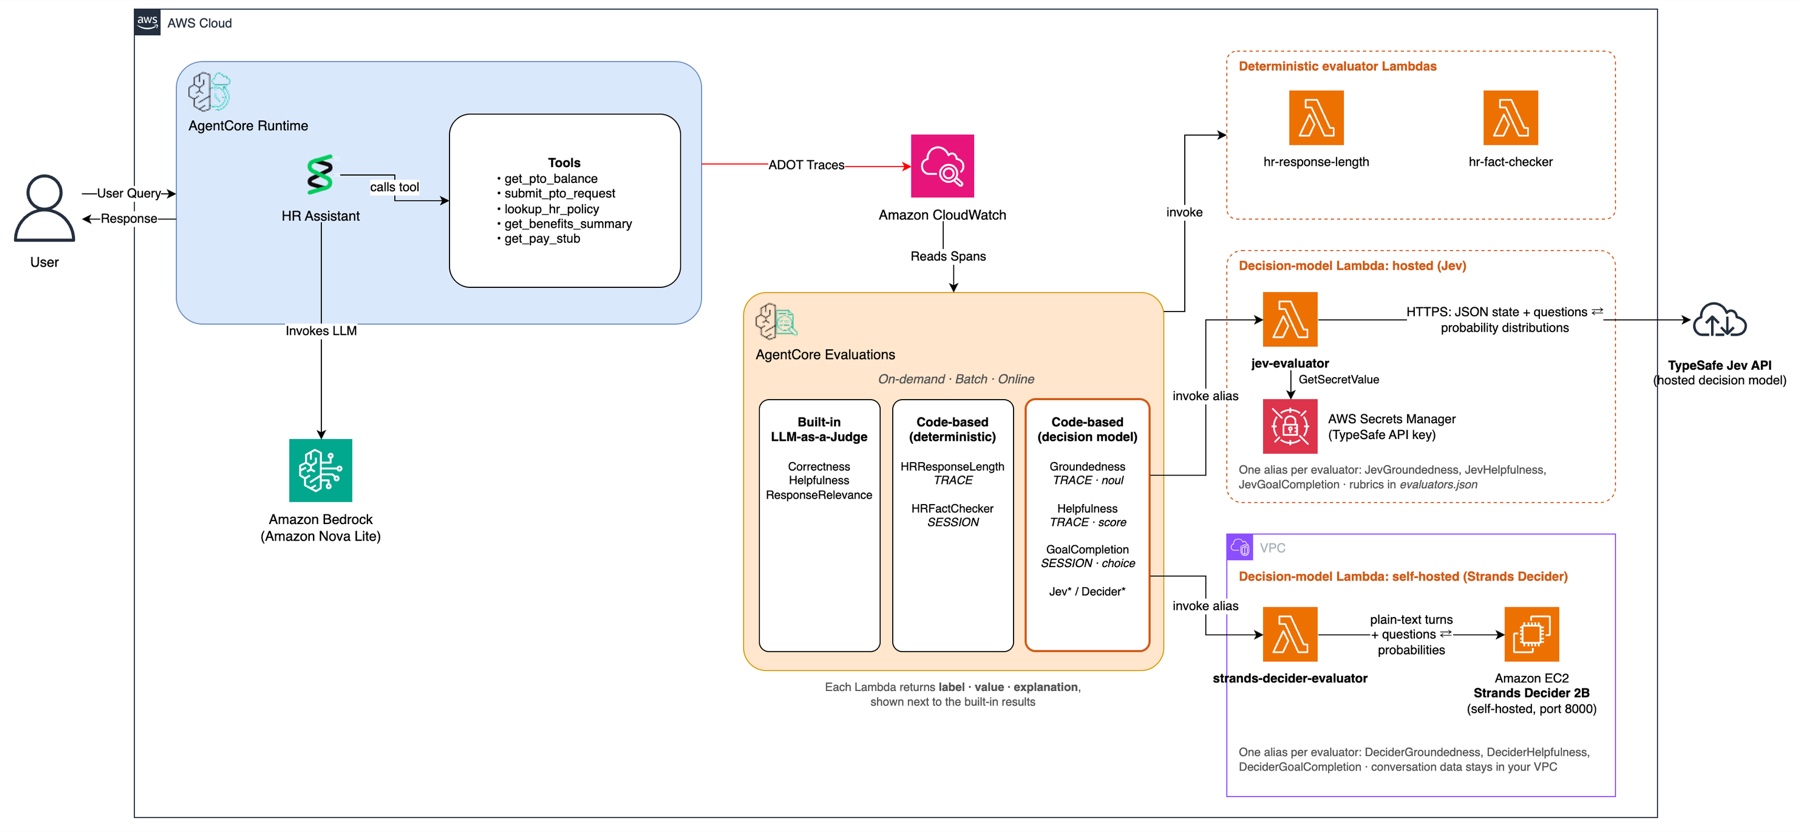
Ön koşullar: AgentCore Evaluations’ın bulunduğu bir bölgede AWS hesabı (örnek varsayılanı US West Oregon), CloudWatch Transaction Search, Bedrock’ta bir temel modele erişim, Python 3.12+, AWS CLI ve Docker. Jev için TypeSafe API anahtarı, Strands Decider için ise sunucuyu çalıştıran bir makine (yerel ya da VPC içinde EC2) gerekiyor.
Çalıştırma
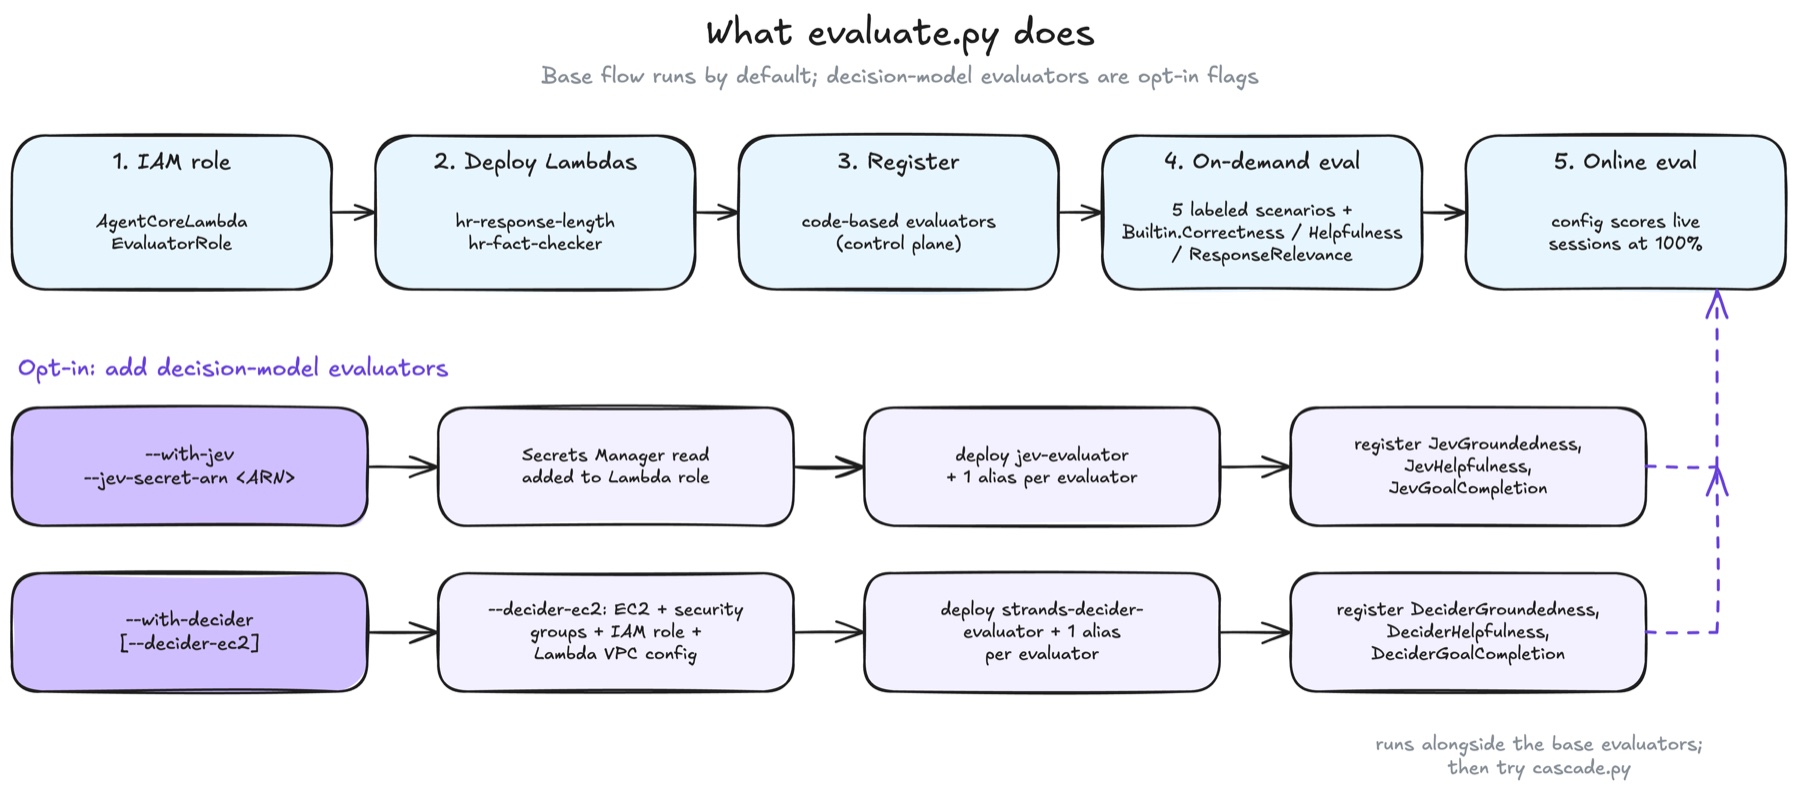
Kod örneği AgentCore samples GitHub deposunda. ../utils/deploy.py asistanı dağıtıyor, evaluate.py ise bayraksız çalıştığında şu adımları yürütüyor:
AgentCoreLambdaEvaluatorRolerolünü oluşturur.- İki deterministik Lambda değerlendirici dağıtır: yanıt uzunluğunu denetleyen
hr-response-lengthve İK bilgilerini regex ile doğrulayanhr-fact-checker. - Bunları kod tabanlı değerlendirici olarak kaydeder.
- Beş etiketli senaryoda Builtin.Correctness, Builtin.Helpfulness ve Builtin.ResponseRelevance ile isteğe bağlı değerlendirme çalıştırır.
- Canlı oturumları %100 örneklemeyle puanlayan çevrim içi yapılandırma oluşturur.
Karar modelleri isteğe bağlı: --with-jev --jev-secret-arn <ARN> ya da --with-decider bayraklarıyla ekleniyor. --decider-ec2, EC2 sunucusunu, güvenlik gruplarını, IAM rolünü ve Lambda VPC ayarını otomatik hazırlıyor.
| Değerlendirici | Seviye | Soru tipi | Etiket | Değer |
|---|---|---|---|---|
| JevGroundedness / DeciderGroundedness | TRACE | noul | Grounded ya da Ungrounded | P(grounded) |
| JevHelpfulness / DeciderHelpfulness | TRACE | score (4 seviye) | En olası seviye | Beklenen seviye, 0-1 arası |
| JevGoalCompletion / DeciderGoalCompletion | SESSION | choice (3 seçenek) | En olası seçenek | Olasılık ağırlıklı değer |
Değerlendirici nasıl çalışıyor?
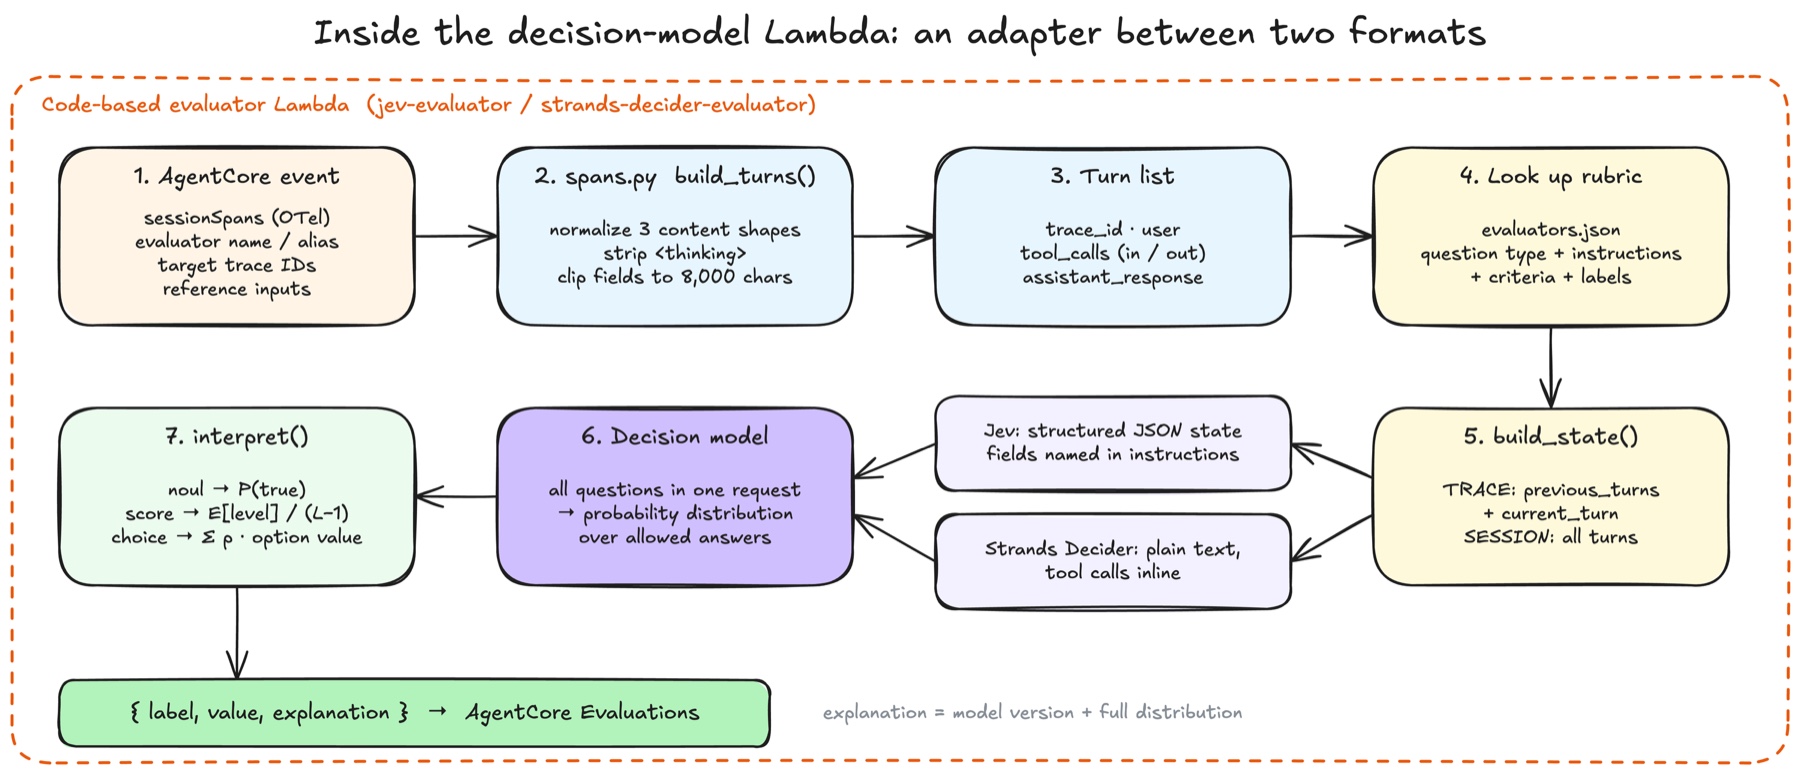
Lambda, ajanın OpenTelemetry span’lerini alıyor; spans.py modülü bunları normalize edip karar modeli isteğine çeviriyor. Trace seviyesinde yalnızca hedef tur ve kısa geçmiş, oturum seviyesinde tüm konuşma gönderiliyor. Adaptör, olasılık dağılımını AgentCore sonucuna dönüştürüyor: noul’da doğru olma olasılığı değer olur; score’da beklenen seviye [0, 1] aralığına ölçeklenir; choice’ta seçenek değerlerinin ağırlıklı ortalaması alınır.
Kendi trafiğinizde doğrulama
Bir rubriği karar modeli sorusuna çevirmek eskisinin kopyasını değil, yeni bir ölçüm yaratır ve orijinalinden daha katı ya da gevşek olabilir. Bu yüzden yayını buna bağlamadan önce beş adımlı doğrulama öneriliyor:
- Etiketli örnek oluşturun: Hatalar ve uç durumları kapsayan oturumlar seçin; yalnızca sorunsuz akışlar bir şey söylemez.
- İnsan referans etiketleri alın: Üç bağımsız etiketleyicinin çoğunluk oyunu kullanın, oy birliği olan ve bölünen turları ayrı tutun.
- İki değerlendiriciyi aynı girdilerde çalıştırın: Karar modeli ve karşılık gelen yerleşik değerlendirici.
- Üç açıdan okuyun: İnsanlarla uyum oranı (soru bazında ve kolay/zor ayrımıyla), kalibrasyon (yüksek güven yüksek doğruluğa denk geliyor mu; eşiği 0,5 varsaymak yerine buna göre seçin) ve anlaşmazlık analizi (çoğu sorunun ifadesinden kaynaklanıyor).
- Değişiklikte tekrarlayın: Soru ya da model sürümü değiştiğinde yeniden çalıştırın.
Hangi değerlendiriciler seçilmeli?
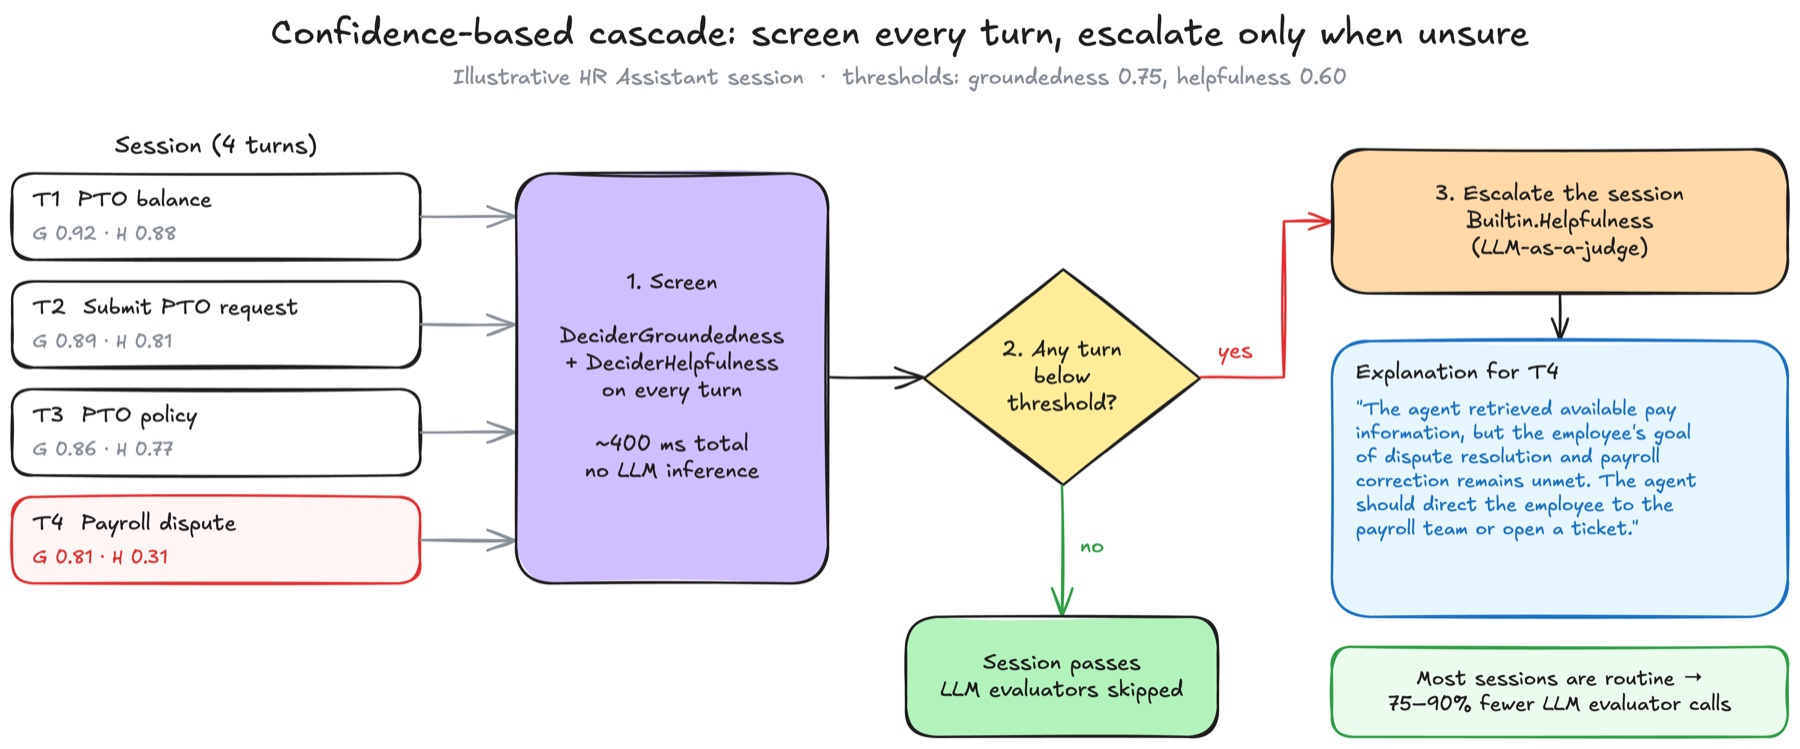
Karar modelleri en iyi yerine geçen değil, kapı işlevi gören bir katman olarak çalışıyor. Kaskad kalıbında her oturumun her turunda hızlı ve kalibre bir karar modeli ucuz bir geçti/kaldı sinyali veriyor; tam LLM değerlendiricisi yalnızca sinyal eşiğin altına düşen oturumlarda çağrılıyor.
| Ölçüt | LLM as Judge | Decision Models as Judge |
|---|---|---|
| Çıktı | Skor ve açıklama | Kalibre olasılık |
| Gecikme | 2-10 sn | ~yüzlerce ms (ağ) |
| Özelleştirme | Sınırlı (sabit prompt şablonları) | Soru tanımları |
| En uygun | Nitel ayrıntı, açıklama | Kalibre karar |
Önerilen kurulum:
- Çevrim içi değerlendirmede yerleşik değerlendiricileri standart kalite ölçüsü olarak kullanın.
- Aynı yapılandırmaya alana özgü evet/hayır ve seçim soruları için karar modellerini, tam hesaplanabilen şeyler için deterministik değerlendiricileri ekleyin.
- Düzenli olarak karar modeli kontrolünü geçemeyen ya da eşiğe yakın oturumları sorgulayıp yerleşik değerlendiricilerle toplu çalıştırın.
- Yayın kapılarını yerleşik değerlendiricilere ve etiketli veriyle doğruladığınız karar modellerine bağlayın, ikisinin uyumunu izleyin.
İş bittiğinde ücret oluşmaması için cleanup.py ajanı, değerlendiricileri, Lambda fonksiyonlarını, EC2 sunucusunu, Secrets Manager anahtarını ve log grubunu siliyor.
Yazıdaki pratik mesaj, karar modellerini doğrudan yayın kapısı yapmamak: Önce yerleşik değerlendiricilerin yanına ekleyin, kendi trafiğinizde insan etiketleriyle ölçün, güven oluştukça kapsamı genişletin. Bu arada EC2’de çalışan Decider ve %100 örneklemeli çevrim içi değerlendirme maliyet yaratabilir; testten sonra temizliği unutmamak gerekiyor.