
Microsoft AI’ın sağlık ekibi (MAI Health), yapay zekâ tabanlı tanı sistemi MAI-DxO (Microsoft AI Diagnostic Orchestrator) üzerine yaptığı çalışmanın hakemli bilim dergisi Science‘ta yayımlandığını duyurdu. Microsoft’un sorusu şu: Yapay zekâ, karmaşık bir tıbbi tanıda klinisyenlere adım adım yardım edip daha az tetkikle, daha düşük maliyetle daha doğru sonuca ulaşabilir mi?
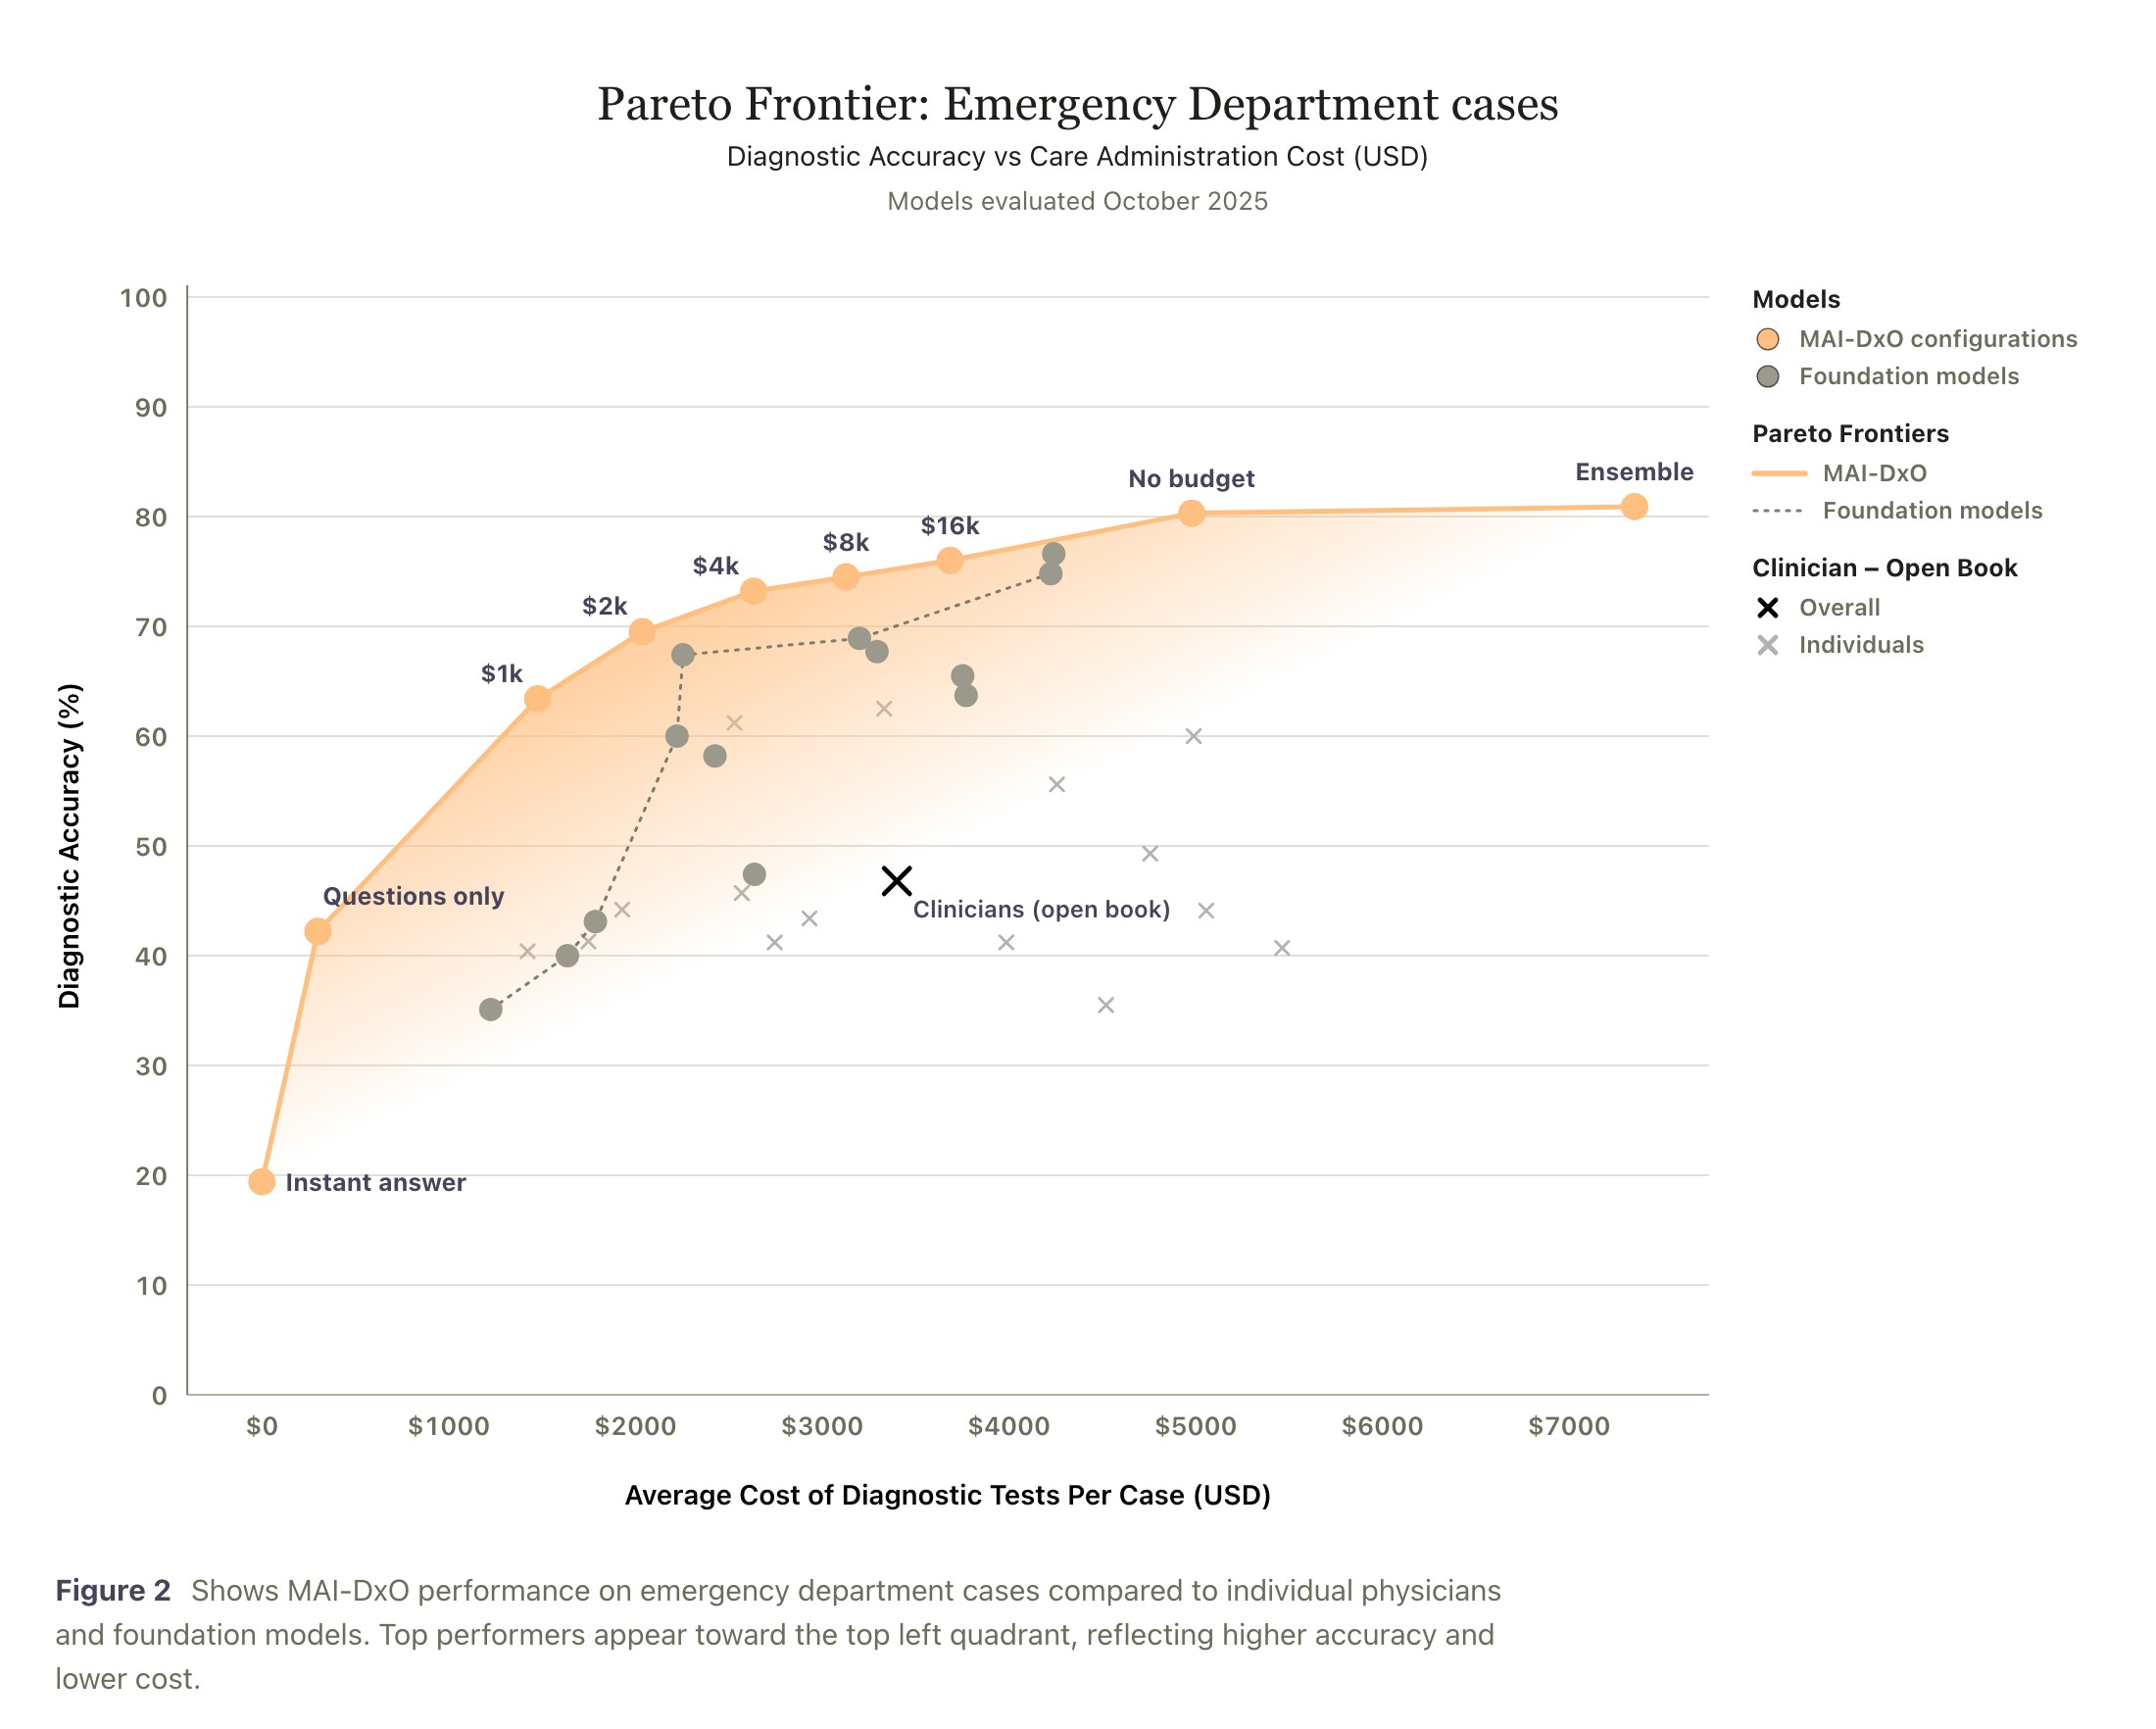
Paylaşılan sonuçlara göre ABD acil servislerine sık başvuru nedenleri olan vakalarda (MIMIC-IV-ED veri seti) MAI-DxO, hekimlerden 1,7 kat daha doğru tanı koyuyor. The New England Journal of Medicine’de (NEJM) yayımlanan en karmaşık vakalarda ise ders kitabı ve internet kullanan hekimlerden iki kattan fazla, bu kaynaklar olmadan tanı koyan hekimlerden ise yaklaşık dört kat daha doğru. Microsoft bunu, daha az test ve işlemle, maliyetin yarısı hatta üçte biriyle başardığını söylüyor.
Ekip aynı hafta “tıbbi süperzekâ” vizyonunu anlatan ayrı bir makaleyi de BMJ Digital Health and AI dergisinde yayımladı.
Yapay zekâ nasıl geliştirilmeli ve test edilmeli?
Microsoft’a göre sağlıkta yapay zekâ hızla ilerliyor; asıl zorluk, modellerin klinik akıl yürütme yeteneklerini anlamlı bir etkiye dönüştürecek sistemleri kurmak ve titizlikle değerlendirmek. Science’taki makale, önceki çalışmanın üzerine iki temel bileşen getiriyor: adım adım tanı koyma becerisini ölçen Sequential Diagnosis Benchmark (SDBench) ve bu benchmark’ta en iyi sonucu alan MAI-DxO.
Sağlıkta yapay zekâyı değerlendirmek için genellikle ABD tıp lisans sınavları (USMLE) gibi testler kullanılıyor. Ancak bu sınavlar hekimin bilgisini ölçmek için tasarlanmış, gerçek tanı sürecini değil. Sınavda tüm bilgi baştan veriliyor ve tek bir cevap seçiliyor. Gerçek hayatta ise klinisyen tabloyu adım adım oluşturuyor: Neyi soracağına, hangi tetkiki isteyeceğine ve her yeni bulgunun olası tanıyı nasıl değiştirdiğine karar veriyor.
SDBench: Adım adım tanı testi
SDBench iki tamamlayıcı vaka setinden oluşuyor: NEJM vaka tartışmalarından alınan 304 karmaşık vaka ve MIMIC-IV-ED’den alınan, acil serviste daha sık görülen başvurular. Her vaka etkileşimli hale getiriliyor: Yapay zekâ modelleri ve hekimler sınırlı bilgiyle başlıyor ve bir sonraki adımda ne isteyeceklerini seçiyor. Benchmark tanı doğruluğunu, istenen kanıtları ve tahmini test maliyetlerini ölçüyor; yani hem cevabı hem de cevaba giden yolu değerlendiriyor.
MAI-DxO: Sanal bir hekim konseyi
MAI-DxO, anında cevap veren tek bir modele dayanmak yerine bir sanal hekim konseyi gibi çalışıyor. Her “hekim” tanı öneriyor, faydalı sorular ya da testler seçiyor ve oluşan görüşe itiraz ediyor. MAI-DxO bu tartışmayı birkaç tur boyunca yönetiyor, yeni kanıt geldikçe değerlendirmesini güncelliyor ve her testin olası faydasını maliyetiyle karşılaştırıyor.
Sonuçlar
| Vaka seti | MAI-DxO | Hekimler | Fark |
|---|---|---|---|
| NEJM karmaşık vakalar | %83 | %22 (kaynaksız) / %36 (kaynaklı) | ~3,7 kat / ~2,3 kat |
| MIMIC-IV-ED acil servis vakaları | %80 | %47 | 1,7 kattan fazla |
- Maliyet için daha fazla optimize edildiğinde MAI-DxO’nun performansı yüksek kalırken daha ekonomik tetkikler seçti. NEJM vakalarında bir yapılandırma, karşılaştırılan sistemlerin yarısından az maliyetle %81 doğruluk elde etti.
- İki veri setinde de MAI-DxO’dan hem daha doğru hem de daha ucuz olan başka bir insan ya da yapay zekâ yaklaşımı çıkmadı.
- Değerlendirme, orkestrasyon yöntemi değiştirilmeden GPT-5.5 dahil daha yeni modellerle tekrarlandığında kazanımlar korundu ve arttı. Microsoft’a göre bu, yaklaşımın belirli bir model nesline bağlı olmadığını gösteriyor.
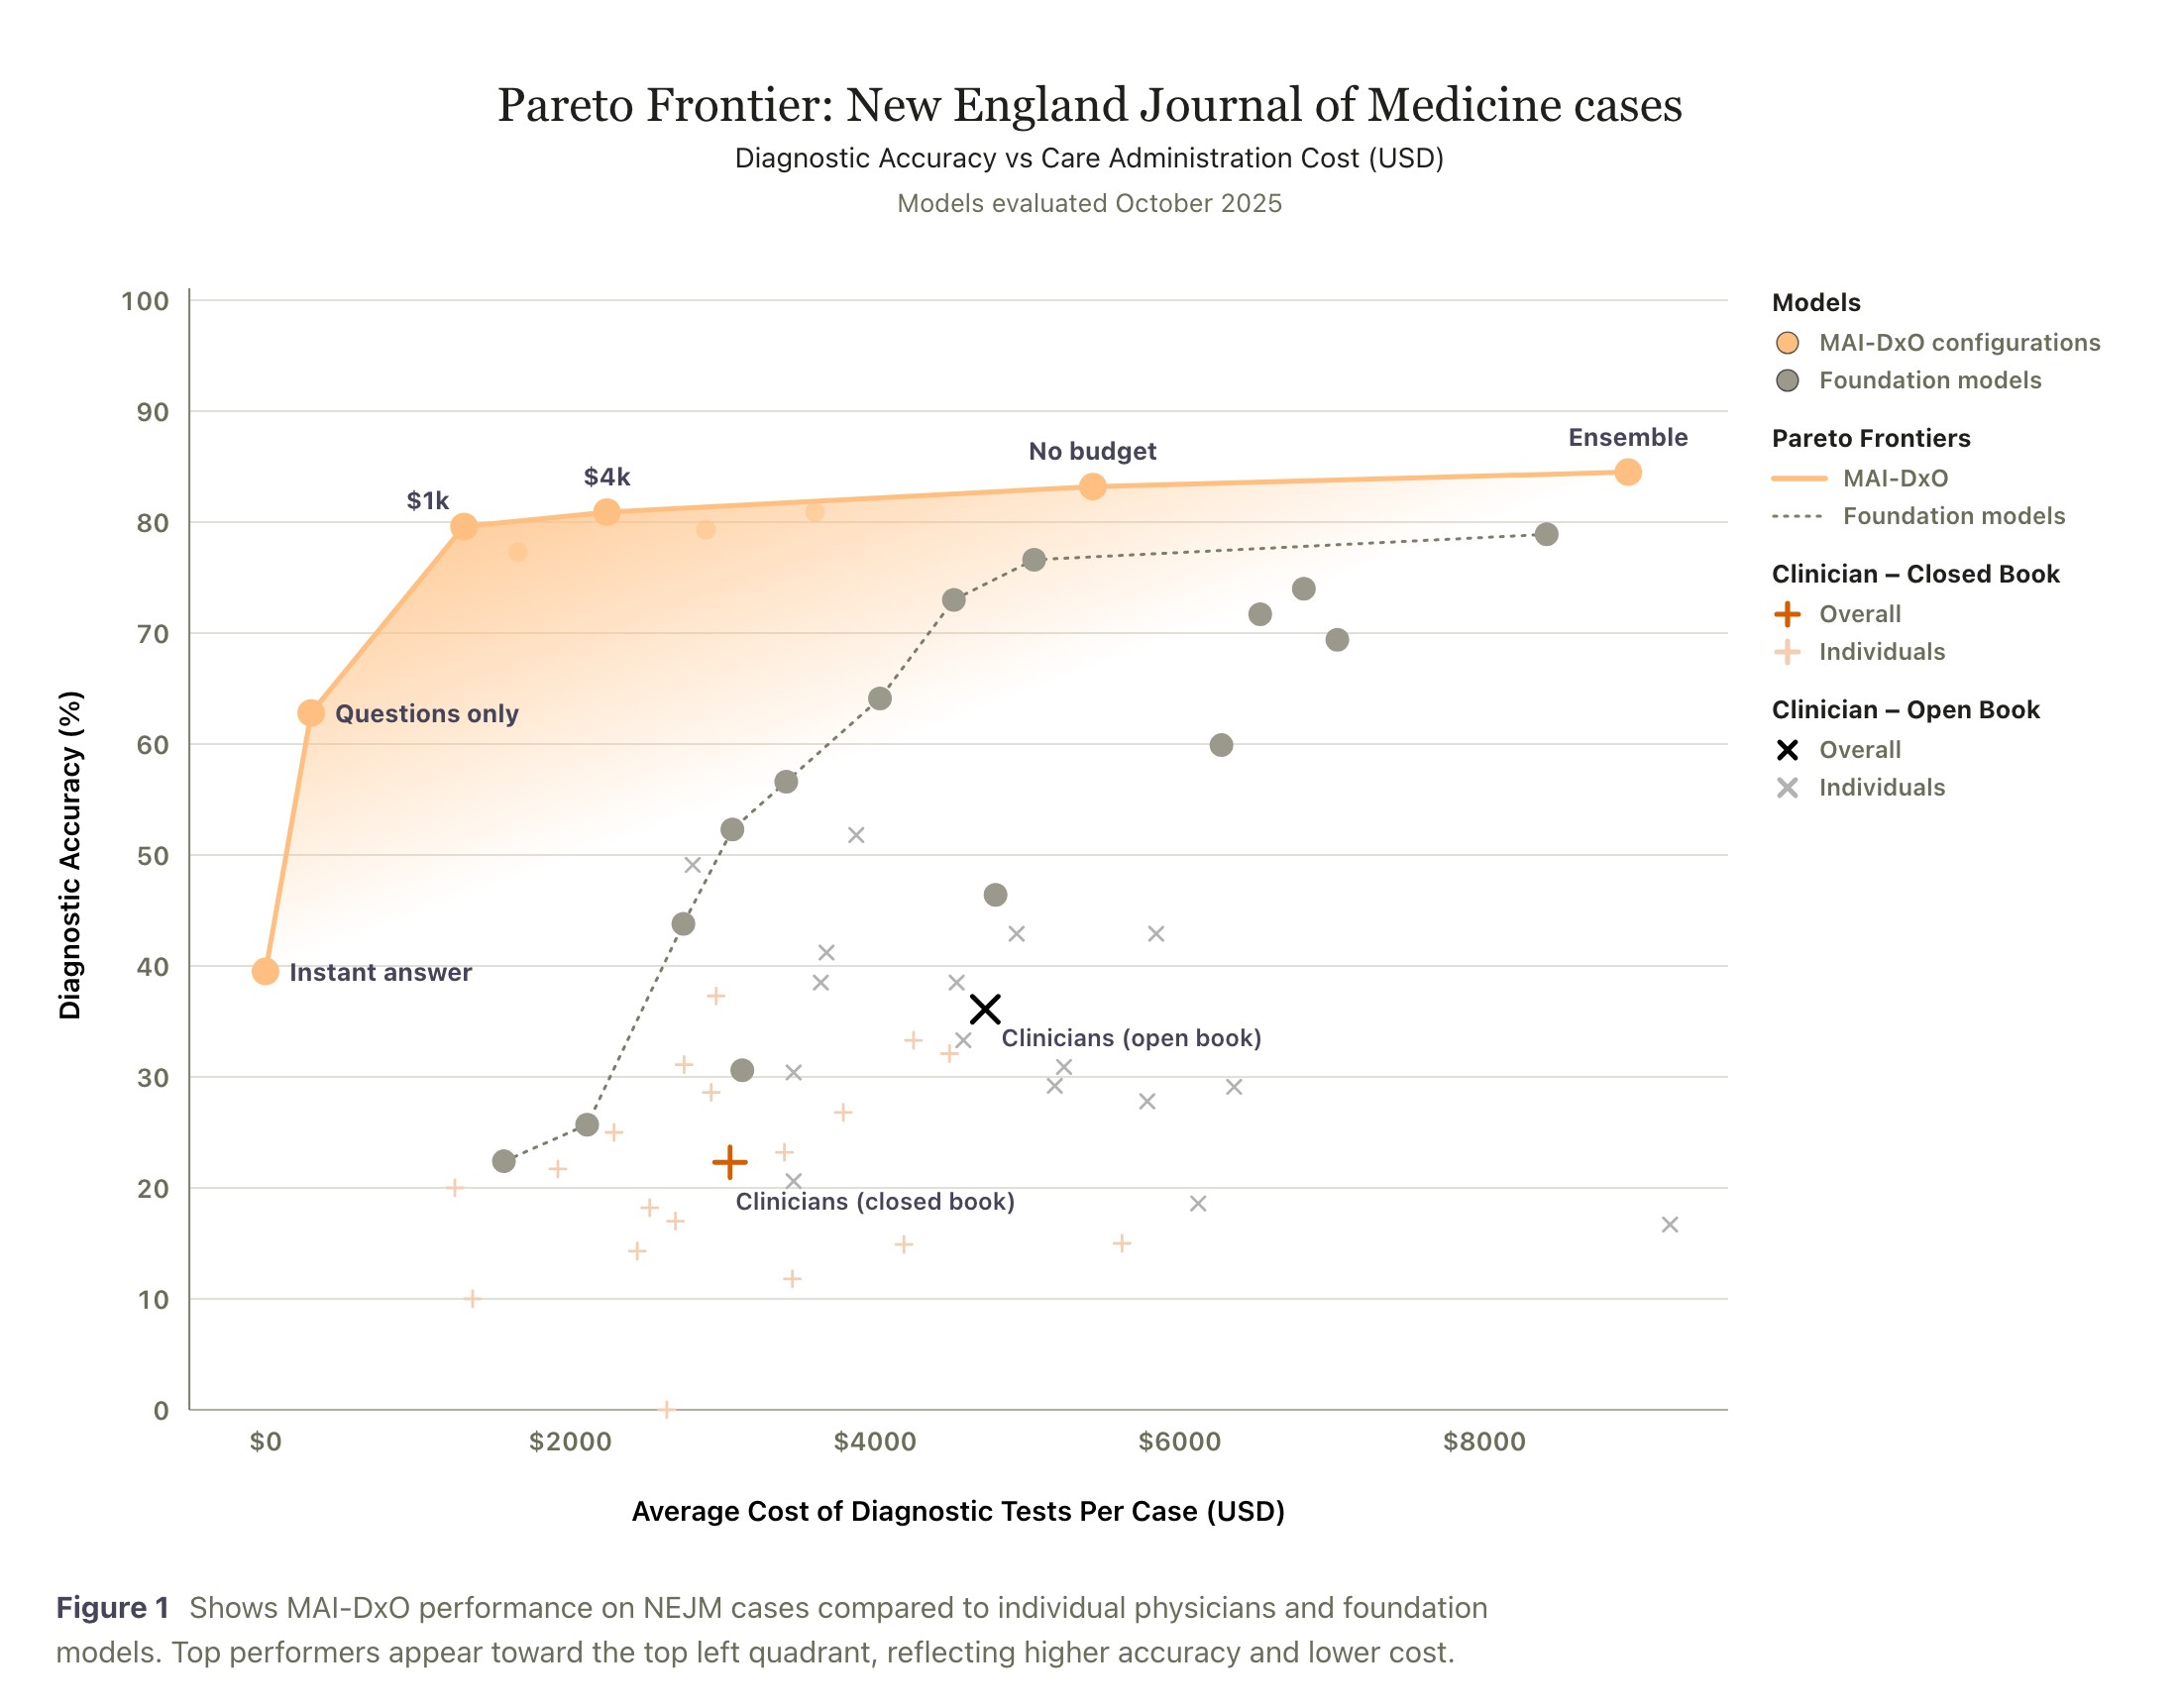
Grafiklerde sol üst bölge, daha yüksek doğruluk ve daha düşük maliyet anlamına geliyor. Turuncu çizgi MAI-DxO’nun farklı bütçe yapılandırmalarını (“Instant answer”, “Questions only”, 1.000 ve 4.000 dolar bütçe, bütçesiz ve “Ensemble”) gösteriyor. Gri noktalar temel modelleri, artı ve çarpı işaretleri ise sırasıyla kaynaksız (closed book) ve kaynaklı (open book) çalışan hekimleri temsil ediyor.
Microsoft, seçili NEJM vakaları için SDBench’i açık kaynak olarak yayımlıyor. Paket; benchmark’ı, bilgi akışını yöneten “Gatekeeper”ı, değerlendirmeyi yapan “Judge”ı ve maliyet tahmini kodunu içeriyor. Böylece araştırmacılar değerlendirmeyi tekrarlayabilir, başka modelleri test edebilir ve bulgulara itiraz edebilir ya da onları genişletebilir: SDBench’i incele.
Daha iyi tanıdan daha iyi bakıma
Tanı, bakım sürecinin yalnızca bir parçası. Daha iyi bakım; güncel tıbbi bilgiyi takip etmeyi, doğru tedaviyi seçmeyi, zaman içindeki değişimi anlamayı ve kişinin değerlerine ve bakıma erişimine uygun seçimleri desteklemeyi de gerektiriyor. Microsoft, BMJ Digital Health and AI’daki “The Building Blocks of Medical Superintelligence” makalesinde yapay zekânın bu geniş vizyonu desteklemesi ve sonunda bugünün en güçlü klinik ekiplerinin ve sağlık sistemlerinin yeteneklerini aşması için neler gerektiğini ele alıyor.
Adım adım tanı bunun erken bir örneği: Birlikte çalışan, varsayımlara itiraz eden ve kanıt geldikçe klinik akıl yürütmesini geliştiren yapay zekâ hekimleri. Microsoft’un hedefi tek bir klinik görevde iyi olan değil, bakım sürecinin tamamında bilgi, bağlam ve kararları birbirine bağlayan bir yapay zekâ. Mayo Clinic ile iş birliği kapsamında frontier yapay zekâyı, klinik uzmanlığı ve uzun dönemli çok modlu verileri bir araya getirmeyi amaçlıyor.
Gerçek dünyada test
Benchmark’lar önemli ama asıl sınav gerçek klinik ortamlardaki performans. Microsoft, Boston’daki Beth Israel Deaconess Medical Center ile yeni bir ortaklık kurdu. İleriye dönük (prospektif) bir çalışmada hastalar sistemle doğrudan etkileşime girecek ve sistemin performansı hekimlerin bağımsız değerlendirmeleriyle karşılaştırılacak. Klinik ekiplerle birlikte çalışmak, teknolojinin nerede başarılı olduğunu, nerede yetersiz kaldığını ve yoğun iş akışlarına nasıl uyabileceğini gösterecek.
Microsoft’ta sağlık
Microsoft, Microsoft Research’teki bilim insanları ile Dragon Copilot ve PowerScribe gibi ürünlerin arkasındaki ekipler dahil, şirket genelindeki sağlık ekiplerini Microsoft AI çatısı altında tek bir çalışmada birleştiriyor. Amaç, daha iyi klinik sonuçlar ve bakım deneyimleri sağlayan güvenilir yapay zekâ sistemlerinin hayata geçmesini hızlandırmak.
Sonuçlar dikkat çekici, ancak hepsi kontrollü bir benchmark ortamında, geriye dönük vakalarla elde edildi. Hekimlerin doğruluk oranlarının, gerçek hayatta danışabilecekleri meslektaşlar ve ek bilgi olmadan ölçüldüğünü de not etmek gerekiyor. Sistemin gerçek hastalarda nasıl çalıştığını Beth Israel Deaconess ile yapılacak ileriye dönük çalışma gösterecek. SDBench’in açık kaynak olması ise sonuçların bağımsız olarak doğrulanabilmesi açısından önemli bir adım.
Kaynak: https://microsoft.ai/news/building-medical-superintelligence/