
AWS, Amazon S3 için annotations adlı yeni bir metadata özelliği duyurdu. Bu özellikle nesnelere zengin ve büyük ölçekli iş bağlamı doğrudan eklenebiliyor. Nesne başına her biri 1 MB’a kadar 1.000 adlandırılmış annotation, toplamda nesne başına 1 GB’a kadar veri saklanabiliyor; format olarak JSON, XML, YAML ya da düz metin kullanılabiliyor. Annotation’lar nesneyi yeniden yazmadan istendiği zaman değiştirilip silinebiliyor.
Kurumlar veriyi insan müdahalesi olmadan bulup anlayan ve üzerinde işlem yapan AI agent’ları ve otonom iş akışları kuruyor. Bunun için veriyle birlikte gelişebilen, petabaytlarca nesneye ölçeklenebilen ve pahalı veri çağırma işlemleri olmadan sorgulanabilen metadata gerekiyor. S3 annotations ile AI tarafından üretilmiş transkriptler, içerik derecelendirmeleri ya da teknik özellikler doğrudan nesnenin yanında saklanabiliyor. Bu bağlam kopyalama, replikasyon ve bölgeler arası aktarımda nesneyle birlikte taşınıyor, nesne silindiğinde S3 onu da kaldırıyor. S3 Metadata etkinleştirildiğinde annotation’lar otomatik olarak Amazon Athena ve diğer analitik motorlarla sorgulanabilen yönetilen tablolara akıyor.
Kullanım senaryoları
- Medya ve eğlence: Video varlıklarında transkriptler, içerik moderasyon sonuçları, altyazı dosyaları ve lisans bilgileri ayrı annotation’lar olarak tutulabiliyor; metadata’yı birden fazla medya varlık yönetim sistemi arasında senkronize etmeye gerek kalmıyor.
- Finansal hizmetler: Araştırma dokümanlarına AI tarafından üretilmiş yatırım özetleri ve duygu analizleri eklenebiliyor; otonom araştırma agent’ları ayrı bir metadata veritabanı olmadan ilgili veri setlerini doğal dil sorgularıyla bulabiliyor.
- Yaşam bilimleri: Klinik deney verileri regülasyon durumu, hasta kohort detayları ve onay zincirleriyle etiketlenebiliyor; S3 Glacier sınıflarındaki arşiv verisi için bile bağlam veri çağırma ücreti olmadan erişilebilir kalıyor.
Annotations mevcut seçeneklerden nasıl ayrılıyor
S3 zaten nesneleri tanımlamanın birkaç yolunu sunuyordu: sistem metadata’sı boyut ve storage class gibi özellikleri tutuyor, object tag’ler erişim kontrolü ve lifecycle gibi operasyonel işler için kullanılıyor, kullanıcı metadata’sı ise yükleme sırasında küçük miktarda özel bilgi eklemeye izin veriyor. Annotations bunlardan çok farklı bir ölçek ve esneklik sunuyor:
| Özellik | Maksimum boyut | Değiştirilebilir mi? | En uygun kullanım |
|---|---|---|---|
| Sistem metadata’sı | Sabit | Hayır | Nesne özellikleri (boyut, storage class, oluşturma zamanı) |
| Kullanıcı metadata’sı | 2 KB | Hayır (yüklemede ayarlanır) | Küçük özel key-value çiftleri |
| Object tag’ler | 10 tag, key/value başına 128/256 karakter | Evet | Erişim kontrolü, lifecycle kuralları, maliyet dağılımı |
| Annotations | 1 GB (1.000 × 1 MB) | Evet | Zengin iş bağlamı (JSON, XML, YAML, düz metin) |
Bugün S3 nesnelerini tanımlayan metadata çoğu zaman ayrı veritabanlarında ya da yan dosyalarda (sidecar) duruyor ve bazen veri depolama maliyetini aşan karmaşık senkronizasyon süreçleri gerektiriyor. Annotation tabloları etkinleştirildiğinde bu bağlam Athena üzerinden ölçekli sorgulanabiliyor. AI agent’lar da S3 Tables MCP sunucusu ile veriyi doğal dille keşfedebiliyor. Annotation’lar her storage class’taki nesneler için, nesneyi geri yüklemeden ve veri çağırma ücreti ödemeden sorgulanabiliyor.
Annotations kullanmaya başlamak
Önce IAM politikasının ya da bucket politikasının s3:PutObjectAnnotation ve s3:GetObjectAnnotation izinlerini verdiğinden emin olmak gerekiyor. Sonra PutObjectAnnotation API’siyle mevcut ya da yeni herhangi bir nesneye annotation eklenebiliyor.
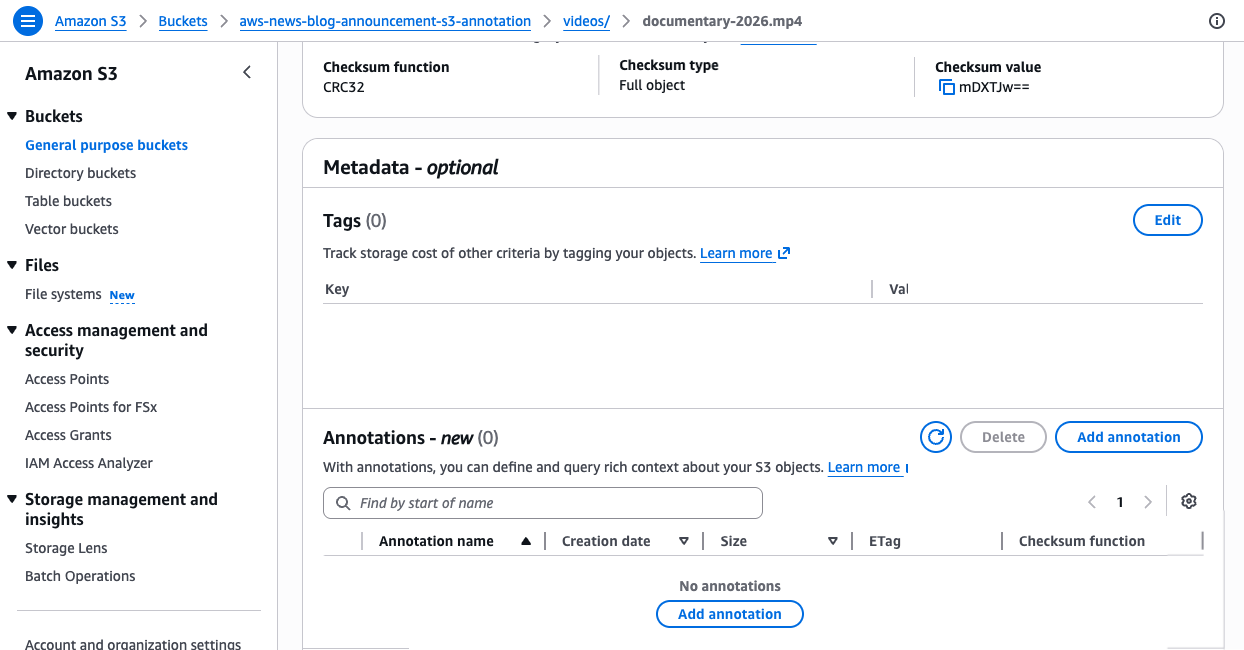
Örneğin bir medya şirketi, AWS CLI ile bir video varlığına teknik özellikleri ve AI tarafından üretilmiş bir özeti ekleyebilir:
# Teknik metadata içeren bir JSON dosyası oluşturun
cat > mediainfo.json << 'EOF'
{"codec":"H.265","resolution":"3840x2160","audio_tracks":8,"frame_rate":29.97}
EOF
# Annotation olarak ekleyin
aws s3api put-object-annotation \
  --bucket my-media-bucket \
  --key videos/documentary-2026.mp4 \
  --annotation-name mediainfo \
  --annotation-payload ./mediainfo.json
# AI tarafından üretilmiş düz metin özeti ayrı bir annotation olarak ekleyin
echo "A 90-minute nature documentary covering wildlife migration patterns across three continents, featuring aerial footage and underwater sequences. Languages: English, Spanish, Portuguese." > ai_summary.txt
aws s3api put-object-annotation \
--bucket my-media-bucket \
--key videos/documentary-2026.mp4 \
--annotation-name ai_summary \
--annotation-payload ./ai_summary.txtBu komutlar aynı video nesnesine iki ayrı annotation ekliyor: mediainfo yapılandırılmış teknik özellikleri JSON olarak, ai_summary ise metin açıklamayı tutuyor. Her annotation benzersiz bir adla tanımlanıyor ve bağımsız olarak okunup değiştirilebiliyor. Böylece örneğin bir ekip teknik metadata eklerken diğeri içerik sınıflandırması ekleyebiliyor ve birbirlerini etkilemiyorlar.
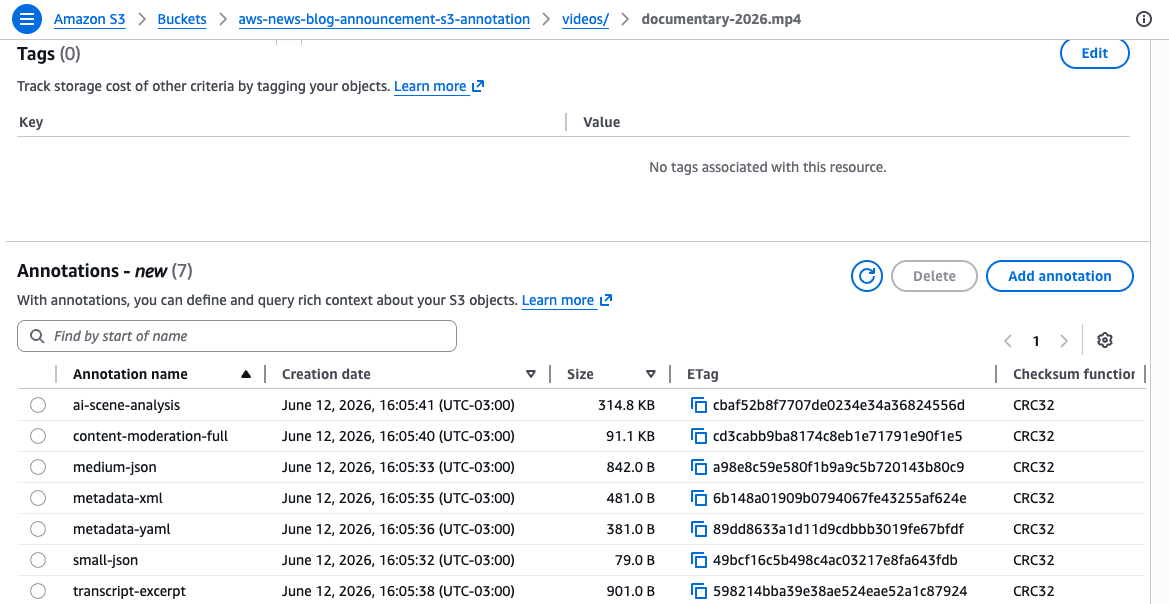
Belirli bir annotation’ı okumak, bir nesnenin tüm annotation’larını listelemek ve bir annotation’ı silmek için:
aws s3api get-object-annotation \
  --bucket my-media-bucket \
  --key videos/documentary-2026.mp4 \
  --annotation-name mediainfo \
  ./mediainfo-output.json

aws s3api list-object-annotations \
  --bucket my-media-bucket \
  --key videos/documentary-2026.mp4

aws s3api delete-object-annotation \
  --bucket my-media-bucket \
  --key videos/documentary-2026.mp4 \
  --annotation-name mediainfo
Mevcut bir annotation’ı güncellemek için PutObjectAnnotation’ı aynı adla tekrar çağırmak yeterli. Multipart upload ile yüklenen büyük nesnelerde annotation’lar yükleme tamamlandıktan sonra ekleniyor.
S3 Metadata tablolarıyla ölçekli sorgulama
Asıl güç, tüm annotation’lar üzerinde ölçekli sorgu yapabilmekte. Bir bucket’ta S3 Metadata annotation tabloları etkinleştirildiğinde S3, annotation’ları otomatik olarak tamamen yönetilen bir Apache Iceberg tablosuna (annotation table) indeksliyor. Bu tablo Athena ya da Iceberg uyumlu herhangi bir motorla sorgulanabiliyor. Etkinleştirmek için S3 konsolu ya da CreateBucketMetadataConfiguration API’si kullanılıyor. Aşağıdaki örnek, değişiklik takibi için journal tablosunu açık tutup canlı inventory tablosunu kapatarak annotation tablolarını etkinleştiriyor:
{
  "JournalTableConfiguration": {
    "RecordExpiration": { "Expiration": "DISABLED" }
  },
  "InventoryTableConfiguration": { "ConfigurationState": "DISABLED" },
  "AnnotationTableConfiguration": {
    "ConfigurationState": "ENABLED",
    "Role": "arn:aws:iam::123456789012:role/S3MetadataAnnotationRole"
  }
}
Bucket’ın zaten bir metadata yapılandırması varsa UpdateBucketMetadataAnnotationTableConfiguration API’si kullanılıyor:
aws s3api update-bucket-metadata-annotation-table-configuration \
  --bucket my-media-bucket \
  --annotation-table-configuration '{"ConfigurationState":"ENABLED","Role":"arn:aws:iam::123456789012:role/S3MetadataAnnotationRole"}'
Journal tabloları neredeyse gerçek zamanlı güncellenirken annotation tabloları bir saat içinde yenileniyor. Önceden tanımlı şema isteyen klasik metadata tablolarının aksine annotation tabloları yazdığınız her JSON, XML ya da YAML yapısına otomatik uyum sağlıyor; her annotation içeriği text_value sütununda saklanan bir satır oluyor. Annotation’lı nesneleri zaten olan bir bucket’ta tablo etkinleştirilirse S3 mevcut annotation’ları arka planda tabloya dolduruyor; bu işlem nesne sayısına göre saatler ile günler sürebiliyor.
Örneğin bucket genelinde 8’den fazla ses kanalı olan tüm video varlıklarını Athena ile bulmak için:
SELECT DISTINCT bucket, object_key
FROM "s3tablescatalog/aws-s3"."b_my_media_bucket"."annotation"
WHERE name = 'mediainfo'
AND CAST(json_extract_scalar(text_value, '$.audio_tracks') AS INTEGER) > 8
Ya da journal tablosu üzerinden son 24 saatte yeni annotation alan tüm nesneleri bulmak için:
SELECT bucket, key, version_id, record_timestamp, annotation.name
FROM "s3tablescatalog/aws-s3"."b_my_media_bucket"."journal"
WHERE record_timestamp >= (current_date - interval '1' day)
AND annotation.name IS NOT NULL
AND record_type IN ('CREATE_ANNOTATION', 'DELETE_ANNOTATION')
Bu ikinci sorgu, yeni ya da silinen annotation’lara tepki veren event tabanlı iş akışları kurmak için uygun. Amazon SageMaker Unified Studio’daki agent’lar ya da S3 Tables MCP sunucusunu kullanan herhangi bir IDE ile doğal dilde de arama yapılabiliyor; örneğin “2023’ten İspanyolca altyazılı tüm PG dereceli filmleri bul” sorusu, birbirinden kopuk birden fazla sistemi sorgulamanın saatler alacağı bir işi saniyeler içinde yanıtlıyor.
Erişilebilirlik ve fiyat
S3 annotations, AWS China bölgeleri dahil tüm AWS bölgelerinde kullanılabiliyor. Annotation tabloları ise S3 Metadata’nın sunulduğu tüm bölgelerde mevcut. Annotation depolaması, ana nesne S3 Glacier ya da başka bir storage class’ta olsa bile her zaman S3 Standard fiyatıyla ücretlendiriliyor. Ayrıntılar için S3 fiyatlandırma sayfasına ve S3 dokümantasyonuna bakabilirsiniz.
S3 annotations, ayrı bir metadata veritabanı ya da sidecar dosya yönetmek zorunda kalan herkes için pratik bir çözüm. Bence en güçlü yanı, metadata’nın nesneyle birlikte replikasyon ve kopyalamada taşınması ve Iceberg tablosu olarak Athena’dan sorgulanabilmesi. Dikkat edilmesi gereken nokta maliyet: Glacier’daki bir nesnenin annotation’ı bile S3 Standard fiyatından ücretlendiriliyor ve nesne başına 1 GB’a kadar çıkabildiği için büyük arşivlerde annotation boyutunu kontrol altında tutmak gerekecek. Annotation tablolarının bir saate kadar gecikmeyle güncellenmesi de gerçek zamanlı ihtiyaçlarda journal tablosunu tercih etmeyi gerektiriyor.