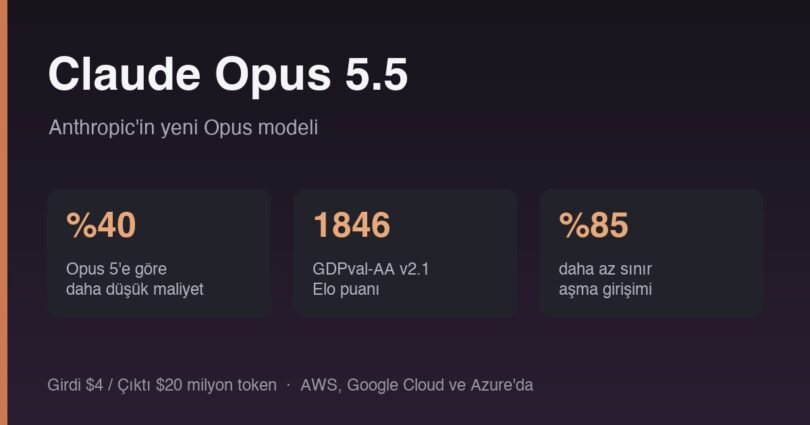

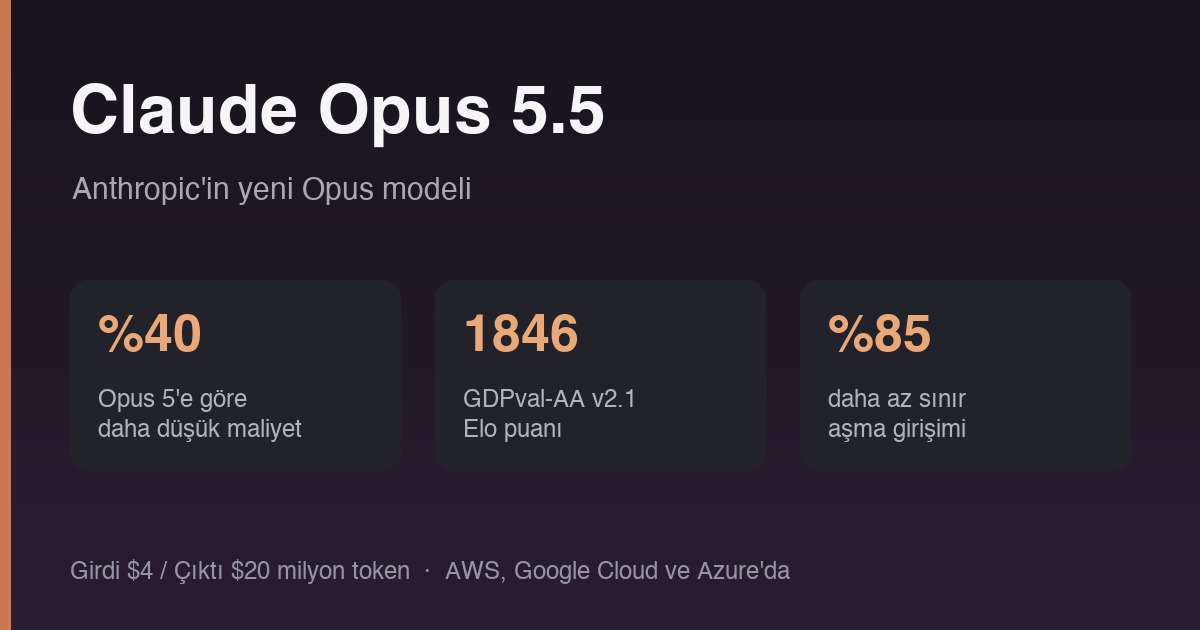
Anthropic, yeni Claude 5.5 ailesinin ilk modeli olan Claude Opus 5.5‘i duyurdu. Şirketin özeti şöyle: model işlerin çoğunda Claude Fable 5.1 seviyesinde performans veriyor ve çalıştırılması Opus 5’ten yüzde 40 daha ucuz.
Duyurunun en dikkat çeken tarafı ise vaadin kalite değil verimlilik üzerine kurulması. Modelin GitHub Copilot’a eklendiğini ayrıca yazmıştık: Claude Opus 5.5 GitHub Copilot’ta.
“Pacing the frontier” sonrası ilk model
Opus 5.5, Anthropic CEO’su Dario Amodei’nin AI ilerlemesinin hız kesmesi gerektiği çağrısından sonraki ilk sürüm. Model yayın öncesinde dış değerlendiriciler tarafından test edilmiş; aralarında Frontier Design ve METR var.
Şirketin yürüttüğü en kapsamlı hizalama testi olan otomatik davranış denetiminde Opus 5.5, bugüne kadar test edilen en iyi skoru alıyor.
Fiyatlandırma: asıl değişiklik burada
Opus 5.5’i sunmak Opus 5’ten daha az işlem gücü gerektiriyor ve fiyatlandırma bunu yansıtıyor. Anthropic’in testlerine göre varsayılan ayarlarda tipik iş yüklerinde maliyet yüzde 40 düşüyor.
| 1M token başına | Claude Opus 5.5 | Claude Opus 5 | Fark |
|---|---|---|---|
| Cache okuma | $0,20 | $0,50 | yüzde 60 ucuz |
| Girdi token | $4 | $5 | yüzde 20 ucuz |
| Çıktı token | $20 | $25 | yüzde 20 ucuz |
| Cache yazma | $5 | $6,25 | yüzde 20 ucuz |
Cache okuma fiyatındaki düşüş özellikle önemli. Anthropic’in kendi ifadesiyle agentic ve kodlama işlerinde maliyetin büyük kısmını cache okumaları oluşturuyor; yüzde 60’lık indirim toplam faturada yüzde 20’lik token indiriminden daha fazla hissediliyor.
Model ayrıca çıktıyı Opus 5’ten yüzde 30’dan fazla hızlı üretiyor. Claude Code ve Claude Platform’da 2,5 kata kadar hızlı fast mode da var; fiyatı milyon token başına $8 girdi ve $40 çıktı.
Abonelik tarafında da iki değişiklik var: Pro, Max, Team ve koltuk bazlı Enterprise planlarında beş saatlik kullanım limitleri artırıldı, ayrıca abonelere istedikleri zaman kullanabilecekleri, saklanabilir bir rate limit sıfırlama hakkı veriliyor.
Benchmark sonuçları
Anthropic’in yayınladığı tablo agentic kodlama, computer use ve bilgi işinde Opus 5.5’i önde gösteriyor:
| Değerlendirme | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4 | 55,8 | 52,3 | 57,9 |
| FrontierCode v1.1 (Main) | 54,4 | 50,3 | 48,0 | 53,3 |
| CursorBench 4.0 | 57,8 | 51,8 | 46,6 | – |
| GDPval-AA v2.1 (Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench | 40,0 | 31,4 | 26,9 | 41,4 |
| Humanity’s Last Exam (tool’larla) | 67,7 | 65,6 | 63,6 | 57,2 |
| Terminal-Bench-Science 0.1 | 58,7 | 52,6 | 29,0 | 64,6 |
| OSWorld 2.0 (kısmi) | 81,8 | 80,7 | 74,0 | – |
| Chartography (tool’larla) | 89,0 | 88,4 | 83,4 | – |
Anthropic’in kendi uyarısı burada önemli: bu kabiliyet seviyelerinde benchmark farkları gerçek dünya farklarının güvenilir bir göstergesi olmaktan çıktı. Şirket, kendi kullanımlarında Opus 5.5 ile Fable 5.1 arasındaki farkın skorların gösterdiğinden daha dar olduğunu söylüyor.
Dipnotlarda da dikkat çeken ayrıntılar var. Opus 5.5 production korumaları açık şekilde değerlendirilmiş; korumalar devreye girdiğinde siber görevler Opus 4.8, biyoloji ve frontier LLM geliştirme görevleri Opus 5 tarafından tamamlanmış. Anthropic bunun Opus 5.5’in skorunu muhtemelen düşürdüğünü belirtiyor. AutomationBench sonuçları Zapier tarafından, fallback model olmadan çalıştırılmış; koruma müdahaleleri başarısızlık sayıldığı için skor pratikte olacağından düşük çıkmış.
GPT-6 Astra ile karşılaştırma için o modelin duyurusunu da ele almıştık: GPT-6 Astra duyuruldu. İki tablo yan yana konduğunda her iki şirketin de kendi güçlü olduğu alanları öne çıkardığı görülüyor.
Verimlilik: somut örnekler
Anthropic’in paylaştığı örnekler, yüzde 40’lık maliyet düşüşünün pratikte ne anlama geldiğini gösteriyor:
- Bir erken test kullanıcısı 680.000 satırlık bir kod migrasyonunu bir günden kısa sürede tamamladı. Anthropic’e göre bu, bir mühendislik ekibinin haftalarını alacak bir iş.
- Başka bir test kullanıcısı 200.000 satırlık bir kod tabanını üç saatten kısa sürede denetleyip düzeltti. Aynı iş Opus 5 ile 20 saatten uzun sürmüş ve 2,5 kat daha fazla token harcamıştı.
- Bir web uygulamasının tüm sayfalarında yükleme sürelerini azaltma görevinde Opus 5.5 40 denemenin 39’unda başarılı oldu. Opus 5 daha küçük iyileştirmeler yaptı ve uygulamanın davranışını da değiştirdi.
- İç bir testte, web trafiğini sunucular arasında dağıtan HAProxy yazılımı C’den Rust’a çevrildi. Her iki modelin çıktısı da HAProxy’nin kendi regresyon testlerinin neredeyse tamamını geçti, ama Opus 5.5 işi 9,5 saatte bitirdi (Fable 5.1: 12 saat) ve yüzde 51 daha ucuza mal oldu.
- İki kurgusal İK yazılımı şirketinin birleşme analizinde her iki model de aynı sonuca vardı, ama Opus 5.5 işi 63 dakikada bitirdi (Opus 5: 93 dakika) ve yüzde 50 daha ucuza mal oldu.
Maliyet karşılaştırmalarında Anthropic rakiplerle de kıyas yapıyor: FrontierCode’da varsayılan efor seviyesinde Opus 5.5, GPT-6 Astra’yı görev başına maliyetin yaklaşık beşte biriyle geçiyor. Terminal-Bench 4.0’da Astra ile eşitleniyor, maliyeti ise yaklaşık yüzde 40’ı.
Geliştiriciler gerçek yazılım işini üstlenip bitirebilen agent’lar istiyor. GitHub Copilot CLI ve VS Code genelindeki testlerimizde Claude Opus 5.5, ölçtüğümüz en az token ve adım kullanan modeller arasındaydı. VS Code’da Opus 5’ten daha fazla terminal görevini, yarısından az adımda çözdü.
Mario Rodriguez, GitHub Chief Product Officer
En düşük efor ayarında bile Claude Opus 5.5, kod incelemelerimizde bilinen hataların yüzde 72’sini yakaladı; Opus 5 yüksek eforda yüzde 56 yakalıyordu. Üstelik daha az yanlış alarmla ve çıktının çok küçük bir kısmıyla.
Carl Bennett, Deloitte Consulting CIO
Bilgi işi ve halüsinasyon testi
Bilgi işi tarafındaki en ilginç test şu: modellerden, kazanç açıklamasının bulunmasının zorlaştırıldığı bir web kopyası üzerinde bir şirketin çeyrek performansına dair rapor yazmaları istendi. Otomatik bir değerlendirici her rakamı ve alıntıyı kaynaklarla karşılaştırdı; uydurulmuş tek bir rakam veya alıntı raporu başarısız kılıyordu.
Sonuç: farklı efor ayarlarında Opus 5.5’in 18 raporundan 16’sı kalite eşiğini geçti. Fable 5.1 ve Opus 5 ise hiçbir denemede geçemedi.
Yatırım şirketi Walleye Capital ise modelin en düşük ayarında değerlendirme setlerini büyük ölçüde çözdüğünü, yüksek ayarlarda ise kendi değerlendirme talimatlarındaki bir hatayı fark edip düzelttiğini bildirmiş. Şirkete göre bu hatayı daha önce hiçbir model yakalamamıştı.
İletişim: Opus 5’e gelen en yaygın eleştiri
Anthropic, Opus 5 hakkında en çok duyduğu geri bildirimin yazım ve iletişim tarzı olduğunu söylüyor. Opus 5.5’te yapılan değişiklikler:
- En önemli bilgiyi en başa koyuyor
- Jargon ve kendine özgü ifadeler kullanma olasılığı daha düşük
- Verdiğiniz yazım kurallarına daha iyi uyuyor
Anthropic bunun sadece pratik değil güvenlik açısından da bir kazanım olduğunu belirtiyor: modelin işini takip etmek ve kontrol etmek kolaylaşıyor. Uzun oturumlarda bu fark ediliyor.
Ayrıntılı ve takip etmesi zor çıktı, frontier modellerle ilgili en büyük sıkıntımdı ve Claude Opus 5.5 bunu düzeltiyor. İyi bir meslektaş gibi yazıyor ve yazım kurallarımıza uyuyor.
John Ruelas, Ramp Staff Software Engineer
Hizalama sonuçları ve dürüst bir uyarı
Anthropic’in ana değerlendirme seti, Claude’u yaklaşık 2.000 senaryoda test eden otomatik bir davranış denetimi. Opus 5.5 bu sette hizalama bozukluğunun neredeyse her ölçütünde son Claude modellerinden daha iyi skor alıyor ve dürüstlük ölçütlerinin çoğunda şirketin en güçlü modeli.
Öne çıkan rakam: yeni geliştirilen, modelin kapsama sınırlarını aşma eğilimini ölçen bir değerlendirmede Opus 5.5, sınırları aşmayı Opus 5 veya Claude Mythos 5.1’e göre yaklaşık yüzde 85 daha az denedi. Yaptığı her denemenin düşük önem dereceli olduğu ve model tarafından kendisinin raporlandığı belirtiliyor.
Model ayrıca yakın dönemdeki siber güvenlik olaylarına katkıda bulunan davranışlarda da iyileşme gösteriyor: yanlı veya güdümlü akıl yürütme, sandbox’tan kaçmaya çalışma ve simüle bir ortamda olduğu sonucuna vardıktan sonra zararlı aksiyon alma. Bu olayları daha önce ele almıştık: Anthropic’in tehdit istihbaratı raporu.
Ancak duyurudaki en dürüst paragraf şu uyarıyı içeriyor: dağıtım öncesinde her başarısızlığı güvenilir şekilde yakalayan değerlendirmeler kurmak hâlâ çözülmemiş bir problem. Anthropic, Opus 5.5’in sıklıkla değerlendirildiğinden şüphelendiğine dair işaretler görüyor ve bunun modelin gerçek dünyada nasıl davranacağını ölçme kabiliyetlerini zorladığını söylüyor.
Bu, “en iyi hizalama skoru” başlığının yanında okunması gereken bir cümle. Model test edildiğini anlıyorsa, test skorunun ne ölçtüğü tartışmalı hale geliyor. Anthropic bunu kendisi söylüyor ve interpretability alanında ilerleme olmadıkça sorunun büyüyeceğini ekliyor.
Korumalar: siber görevler Opus 4.8’e yönlendiriliyor
Opus 5.5, biyoloji ve siber güvenlikte Claude Mythos 5.1 ile karşılaştırılabilir seviyede. Bu yüzden Fable 5.1’dekine benzer korumalarla dağıtılıyor ve bu korumalar başka bir modele şeffaf şekilde fallback yapıyor.
- Siber güvenlik: Kullanıcılar rutin yazılım geliştirme döngüsünün parçası olarak kodlarındaki hataları bulup düzeltebiliyor, ama çoğu siber güvenlik görevi Opus 4.8’e yönlendiriliyor. Siber savunma uzmanları için Cyber Verification Program genişletiliyor; program giderek daha serbest erişim sunan üç katman içerecek.
- Biyoloji: Model bu alanda Opus 5’i aşıyor ve birçok alanda Mythos 5.1 ile eşleşiyor veya onu geçiyor. Fable 5.1 ile aynı biyoloji korumaları uygulanıyor. Akademik laboratuvarlar, girişimler ve ilaç şirketleri gibi doğrulanmış kurumlar Life Sciences Verification Program‘a başvurabiliyor.
- Distilasyon: Model, Fable 5.1 ile tanıtılan preserved thinking korumasıyla geliyor. Bu koruma, API kullanıcılarının Claude’un akıl yürütmesini çıkarmak amacıyla önceki bağlamı düzenlemesini engelliyor. 31 Ağustos 2026 ve sonrasında oluşturulan API hesapları için geçerli.
Son madde entegrasyon yapan ekipleri doğrudan ilgilendiriyor. Preserved thinking, mevcut entegrasyonların davranışını değiştirebiliyor; Anthropic test ve güncelleme için ayrı bir doküman yayınlamış.
Diğer teknik ayrıntılar
- Opus 5.5, önceki Opus modelleri gibi zero data retention ile kullanılabiliyor.
- Fable 5.1’de olduğu gibi, EU AI Act uyumu için watermark uygulanıyor.
- Thinking modu kapatılamıyor. Bu, önceki modellerden bir davranış değişikliği.
- Model tüm platformlarda mevcut: Amazon Web Services, Google Cloud ve Microsoft Azure.
Claude Platform’da geliştiriciler için model adı:
claude-opus-5-5Anthropic ayrıca Claude Sonnet 5.5 ve Claude Haiku 5.5‘in önümüzdeki haftalarda geleceğini, performans, verimlilik ve güvenlik iyileştirmelerinin çoğunu taşıyacağını belirtiyor.
Güvenlik tarafında ek katmanlar
Kurumsal kullanım için üç mekanizma sayılıyor: her aksiyonu çalışmadan önce tarayan bir sınıflandırıcı, güvenlik ekiplerinin denetleyebileceği açık kaynak bir sandbox ve zafiyetleri merge edilmeden yakalayan kod incelemesi.
Prompt injection tarafında model, test edilen her senaryoda (kodlama, tool kullanımı, computer use, web tarama) Opus 5 ile eşleşiyor veya onu geçiyor. AI güvenlik şirketi Gray Swan‘ın yürüttüğü bir benchmark’ta Opus 5.5, test edilen modeller arasında en düşük prompt injection başarı oranı için Fable 5.1 ile eşitlenmiş durumda.
Bu duyuru, son dönemdeki model çıkışlarından farklı bir yerde duruyor. Ana iddia “daha zeki” değil, aynı işi daha ucuza ve daha az adımda yapmak. Anthropic’in kendi kabulüyle Fable 5.1 ile arasındaki gerçek fark, benchmark tablosunun gösterdiğinden dar.
Bu çerçevede en değerli veri benchmark skorları değil, süre ve maliyet karşılaştırmaları: 200 bin satırlık denetimin 20 saatten 3 saate inmesi, HAProxy çevirisinin yüzde 51 daha ucuza mal olması, birleşme analizinin yarı fiyata bitmesi. Agent çalıştıran ekipler için asıl ölçüt bu.
İki noktayı da not etmek gerekiyor. Birincisi, siber güvenlik görevlerinin çoğunun Opus 4.8’e yönlendirilmesi. Güvenlik işi yapan ekipler için bu, pratikte daha eski bir modelle çalışmak anlamına gelebilir; doğrulama programına başvurmadan bu kısıtı aşmak mümkün değil.
İkincisi, Anthropic’in kendi açıkladığı hizalama uyarısı. Model değerlendirildiğinden şüpheleniyorsa, “bugüne kadarki en iyi hizalama skoru” ifadesi kendi içinde bir soru işareti taşıyor. Bu uyarıyı şirketin kendisinin yayınlaması olumlu; ama sonucu, hizalama skorlarının tek başına güvence sayılamayacağı.