
OpenAI, bu ay başında duyurduğu GPT-6 Astra‘nın ardından aileyi iki modelle genişletti: GPT-6 Sol ve GPT-6 Luna. Şirketin çerçevesi şu: en zorlu ve önemli projeler hâlâ Astra’nın tam derinliğini gerektiriyor, ama iş farklı ölçeklerde, ritimlerde ve bütçelerde yapılıyor.
İki model de Astra ile benzer yöntemlerle eğitilmiş. Duyurunun ana iddiası zeka sıçraması değil, maliyet verimliliğinde sınırı ileri taşımak. Astra’yı daha önce ayrıntılı ele almıştık: GPT-6 Astra duyuruldu.
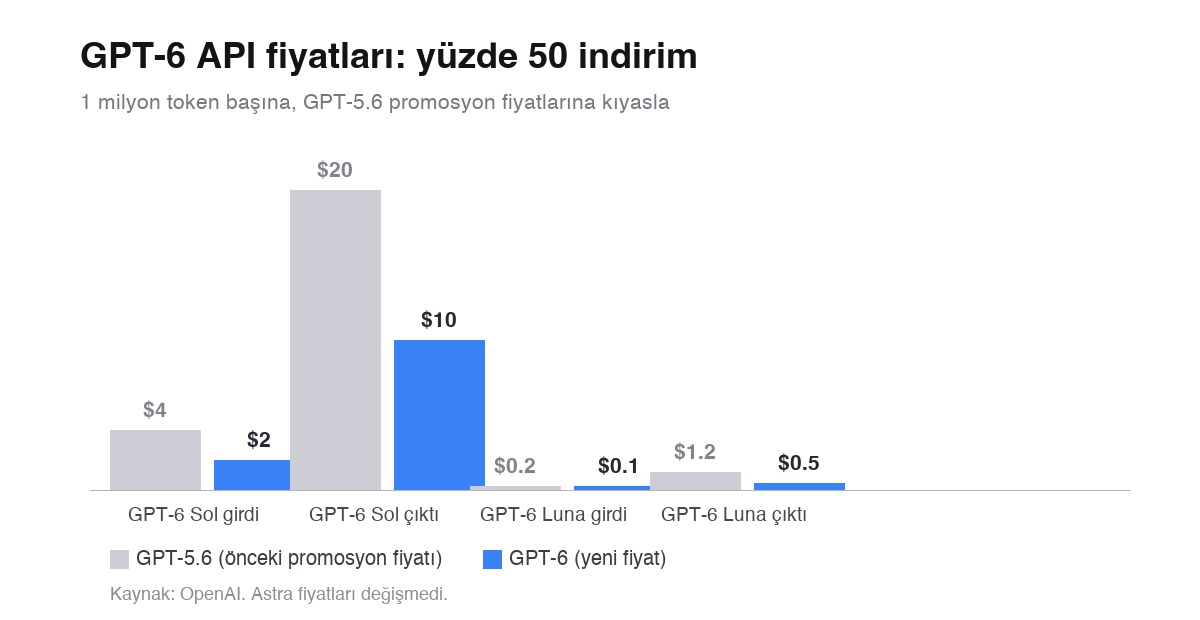
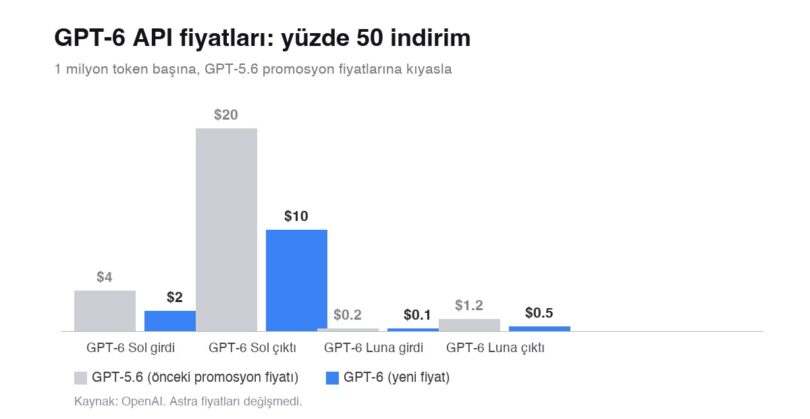
Fiyatlar yarıya indi
OpenAI, caching ve çıkarım tarafındaki iyileştirmelerin modelleri daha ucuza sunmayı mümkün kıldığını ve bu tasarrufu doğrudan kullanıcılara yansıttığını söylüyor. Sol ve Luna için API fiyatları, GPT-5.6 promosyon fiyatlarına göre yüzde 50 düşürüldü.
| Model | Girdi | Çıktı | Değişim |
|---|---|---|---|
| GPT-5.6 Sol → GPT-6 Sol | $4 → $2 | $20 → $10 | yüzde 50 ucuz |
| GPT-5.6 Luna → GPT-6 Luna | $0,20 → $0,10 | $1,20 → $0,50 | yüzde 50 ucuz |
GPT-6 Astra ise her alanda şirketin en iyi modeli olmaya devam ediyor. OpenAI, en iyi sonucu ve ödün vermeyen bir deneyimi istediğinizde onu seçmenizi öneriyor.
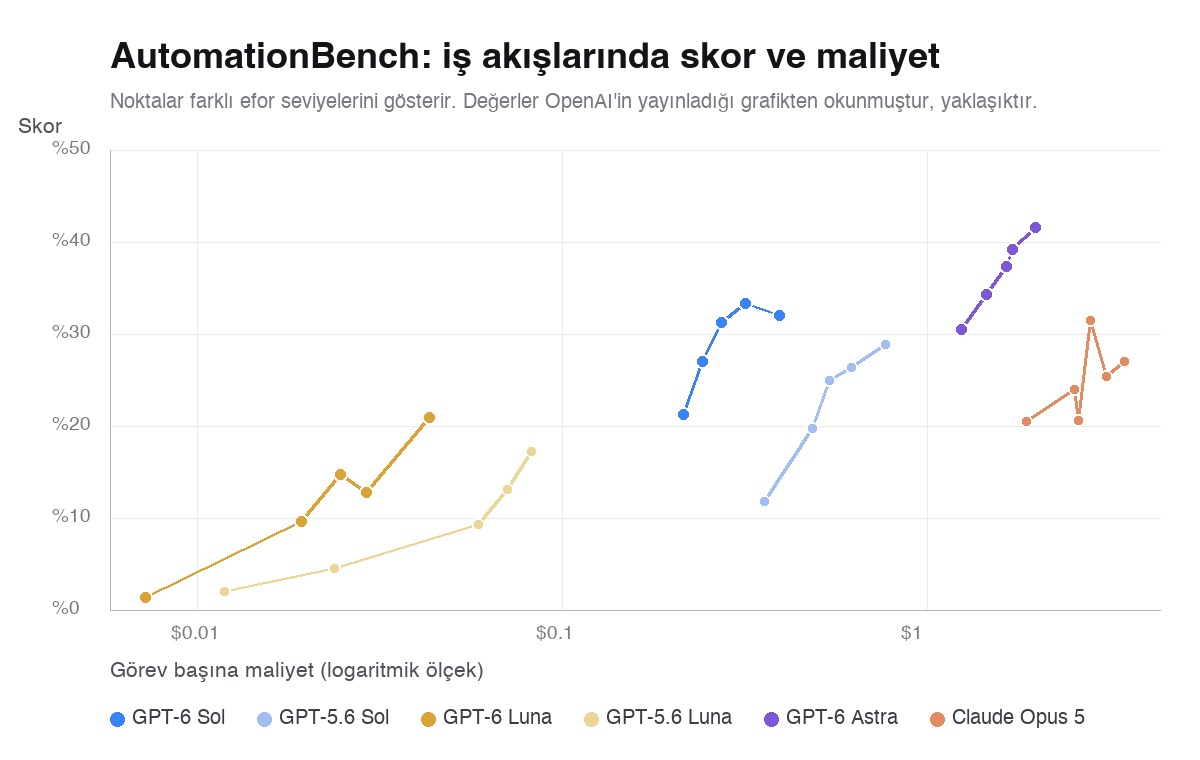
Grafik notu: Aşağıdaki karşılaştırma grafikleri, OpenAI’in duyurusunda yayınlanan etkileşimli grafiklerdeki veri noktalarından üretilmiştir. Değerler grafikten okunduğu için yaklaşıktır; kesin rakamlar için kaynak duyuruya bakın.
Profesyonel iş: AutomationBench
Uygulamalar arası iş akışlarını test eden AutomationBench‘te OpenAI’in öne çıkardığı sonuç şu: GPT-6 Sol, xhigh efor ayarında, maksimum efordaki Claude Opus 5’i görev başına maliyetin sadece yüzde 9’uyla geçiyor. GPT-6 Luna ise high eforda selefini 5,4 puan geçerken görev başına maliyeti yüzde 58 daha düşük.
| Model (efor) | Skor | Görev başına maliyet |
|---|---|---|
| GPT-6 Sol (xhigh) | 33,2 | $0,27 |
| GPT-6 Astra (low) | 30,3 | GPT-6 Sol’un 3,9 katı |
| Claude Opus 5 (max) | 26,9 | GPT-6 Sol’un 11,1 katı |
| Claude Fable 5.1 + Opus 5 fallback (max) | 31,4 | GPT-6 Sol’un 8,9 katından fazla |
Son satırdaki dipnot önemli ve OpenAI bunu kendisi belirtiyor: Claude Fable 5.1’in maliyet verisi, görevlerin yaklaşık yüzde 40’ında devreye giren Opus 5 fallback’lerinin maliyetini içermediği için gerçek maliyeti olduğundan düşük gösteriyor. Yani o karşılaştırmadaki fark pratikte daha da büyük, ama ne kadar olduğu raporlanmamış.
Agents’ Last Exam‘de ise GPT-6 Sol maksimum eforda 56,4 puan alıyor; Claude Opus 5’in aynı değerlendirmedeki en yüksek skorunun üzerinde ve görev başına maliyeti yüzde 60 daha düşük.
Olgusal doğruluk
OpenAI’in iç olgusal doğruluk değerlendirmesi, kullanıcıların önceki modellerde hata bildirdiği, kimliksizleştirilmiş gerçek konuşmalara dayanıyor. Sonuç: GPT-6 Sol, selefinin yaklaşık yarısı kadar hata yapıyor ve çok daha düşük maliyetle Astra seviyesindeki güvenilirliğe yaklaşıyor. Luna da belirgin şekilde iyileşiyor; yüksek efor seviyelerinde GPT-5.6 Sol ile eşleşiyor, maliyeti ise onun yaklaşık yüzde biri.
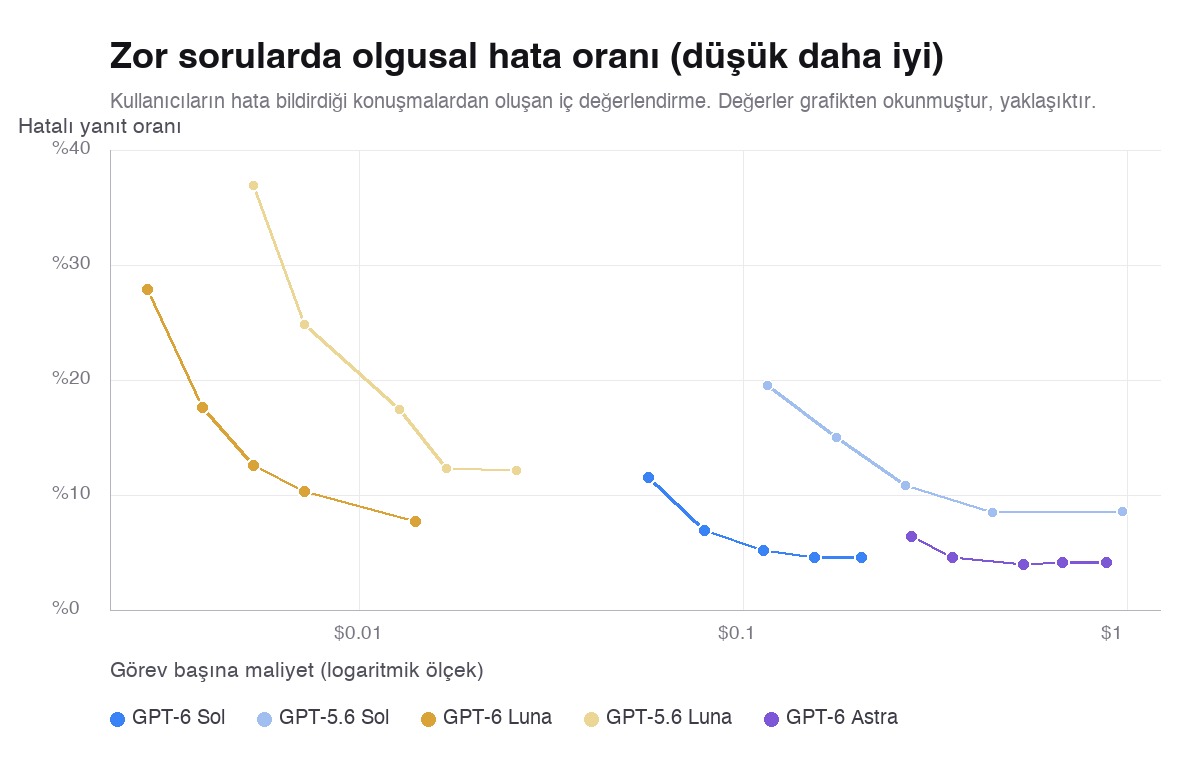
OpenAI’in bu değerlendirme için koyduğu şerh de önemli: bu hata üreten konuşmalar tipik kullanımı temsil etmiyor, gerçek kullanımda olgusal hatalar daha nadir.
Kodlama
Duyuruda kodlama bölümü, maliyetin neden bu kadar öne çıktığını açıklayan bir veriyle başlıyor. OpenAI’in kendi iç kullanımı üssel olarak büyümüş: API fiyatlarıyla değerlendirildiğinde günlük token kullanımı medyan araştırmacı için 600 doları, 90. yüzdelikteki araştırmacılar için 7.000 doları aşmış.
Kodlama agent’ları daha uzun ve zorlu görevleri üstlendikçe sürekli kullanımın maliyeti daha çok önem kazanıyor. OpenAI’in argümanı bu: daha düşük fiyat, geliştiricilere yineleme için daha fazla alan veriyor.
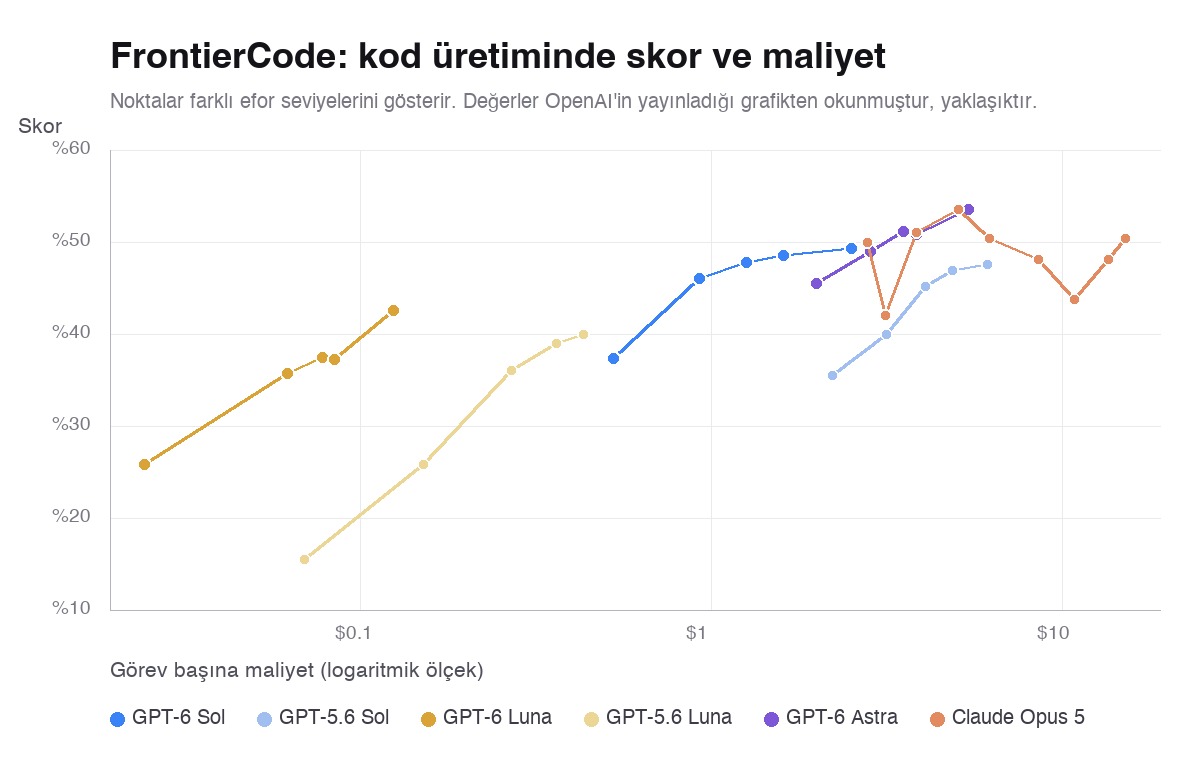
FrontierCode, bir kodlama agent’ının ürettiği değişikliklerin gerçek kod tabanlarına merge edilmeye hazır olup olmadığını değerlendiriyor. GPT-6 Sol burada GPT-5.6 Sol’un belirgin şekilde üzerine çıkıyor ve Claude Fable 5.1’in xhigh skoruna çok daha düşük maliyetle ulaşabiliyor.
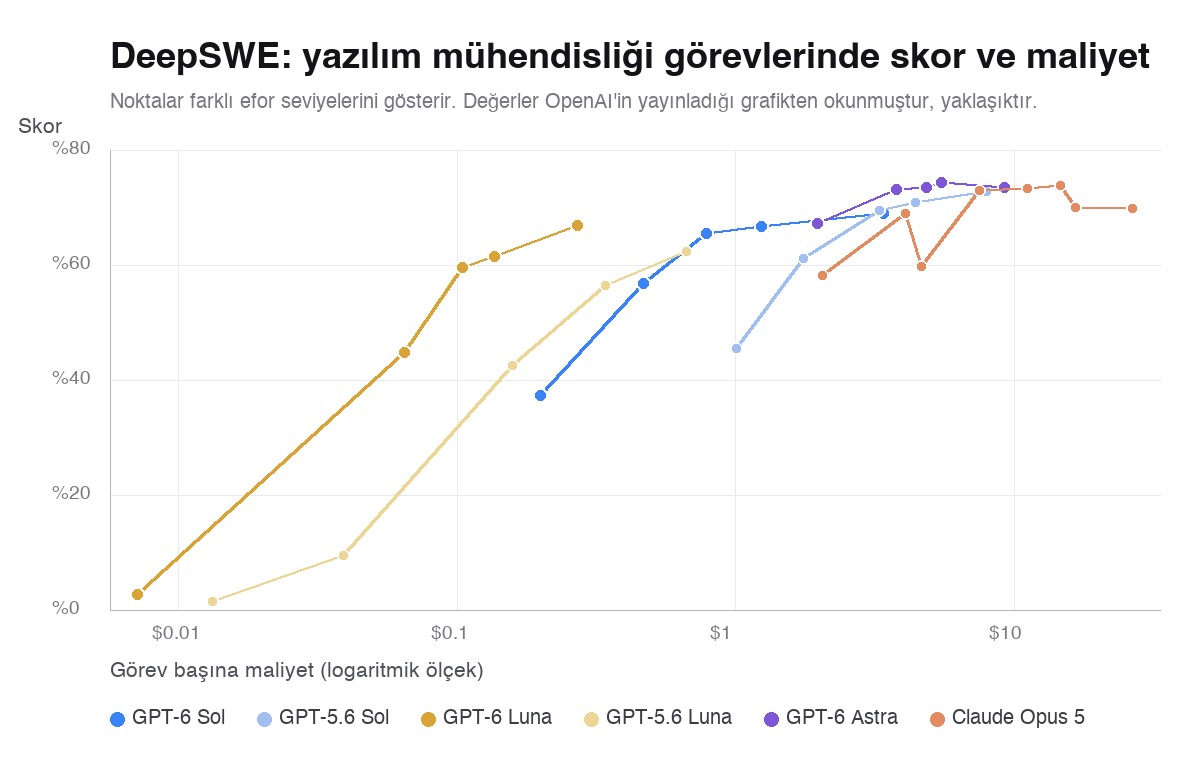
DeepSWE v1.1‘de GPT-6 Sol maksimum eforda 68,8 puan alıyor. Bu, Claude Fable 5’in aynı değerlendirmedeki en yüksek skorunun (xhigh eforda 69,9) 1,1 puan altında, ama görev başına maliyeti yaklaşık yüzde 80 daha düşük.
GPT-6 Luna ise maksimum eforda 66,6 puan alıyor; bu, orta efordaki Claude Opus 5 ve Fable 5 ile karşılaştırılabilir bir sonuç. Bu karşılaştırmalarda Luna’nın görev başına maliyeti Opus 5’ten yüzde 93, Fable 5’ten yüzde 96 daha düşük.
Anthropic’in aynı dönemde yaptığı maliyet vurgusuyla karşılaştırmak için: Claude Opus 5.5 duyurusu. İki şirket de bu turda zekâdan çok maliyeti konuşuyor.
Computer use
GPT-6 Astra computer use’da dünyanın en iyi modeli olmaya devam ediyor, ama Sol ve Luna seleflerine göre daha maliyet verimli. OSWorld 2.0 offline setinde GPT-6 Sol xhigh eforda 60,5 puan alıyor; orta efordaki Claude Opus 5’in 60,3 puanına benzer bir sonuç, görev başına maliyeti ise yaklaşık yüzde 80 daha düşük. GPT-6 Luna (max) ise GPT-5.6 Sol’un (medium) skorunu onun onda biri maliyetle geçebiliyor.
İletişim tarzı
Astra’nın geliştirilmiş iletişim tarzı Sol ve Luna’ya da taşınmış. OpenAI’e göre bu özellikle teknik ve kodlama konuşmalarında fark edilecek:
- Daha fazla netlik
- Daha az jargon
- Daha az tuhaf ifade
- Daha az değersiz ayrıntı
- Genel olarak biraz daha kısa cevaplar, öz kaybedilmeden
Duyuruda bir örnek karşılaştırma da var. OpenAI kendi tercihini açıklarken gerekçelerini sıralıyor: yeni model sonuca daha hızlı atlamıyor, soranın zaten bildiği ayrıntıları tekrar etmiyor, muğlak ifadelerden kaçınıyor, neyi kontrol edip neyi etmediğini daha açık söylüyor.
Caching iyileştirmeleri
Token fiyatlarının yanında, uygulamaların tekrar kullandığı bağlam için de tasarruf var. GPT-6’da prompt caching varsayılan olarak daha yüksek cache isabet oranı verecek şekilde iyileştirilmiş; cache’ten okunan girdi token’larında yüzde 90 indirim geçerli.
Geliştiriciler için üç yeni imkân sayılıyor:
- İzleme ve teşhis: Prompt Caching Dashboard girdinin ne kadarının cache’lendiğini ve bunun zaman içinde nasıl değiştiğini gösteriyor. Teşhis aracı kaçırılan caching fırsatlarını ve nedenini açıklıyor.
- Cache bozmadan ayar değiştirme: Zor görevler için reasoning effort’u artırmak veya basit takip soruları için düşürmek, ayrıca tool’ları açıp kapatmak artık önceki bağlamın cache’te kalmasını bozmuyor.
- Hangi ön eklerin cache’leneceğini seçme: Açık breakpoint’ler, cache’lenen prompt ön eklerinin nerede biteceğini belirlemeye izin veriyor.
GitHub’ın bildirdiğine göre bu iyileştirmeler son birkaç ayda, OpenAI modellerine yapılan milyarlarca istek genelinde yeniden işlenmesi gereken prompt token’larının payını yüzde 50’den fazla azaltmış ve Copilot’un daha hızlı yanıt vermesine yardımcı olmuş.
Hizalama
Sol ve Luna, Astra ile tanıtılan hizalama çalışmasının üzerine kuruluyor. OpenAI’in hizalama değerlendirmelerinde her iki model de GPT-5.6 muadillerine göre iyileşme gösteriyor; bunlara kodlama işleri hakkında yanıltıcı iddialarda bulunma oranının düşmesi de dahil.
Şirketin kendi koyduğu şerh burada da var: bu değerlendirmeler bilinçli olarak zorlu durumları test ediyor ve tipik kullanımdaki başarısızlık oranlarını ölçmüyor.
Erişim
GPT-6 Sol ve GPT-6 Luna, bugünden itibaren ChatGPT Work ve Codex‘te tüm Plus, Pro, Business, Enterprise ve Edu kullanıcıları için kullanılabilir. Free ve Go kullanıcıları masaüstü uygulamasından GPT-6 Luna’ya erişebiliyor. Modeller henüz Chat’te yok.
API tarafında model adları:
gpt-6-sol
gpt-6-luna
OpenAI, servisi herkes için stabil tutmak adına ChatGPT’de dağıtımı gün boyunca kademeli yapacağını belirtiyor. Copilot tarafındaki model eklemelerini de takip ediyoruz: GPT-6 Astra GitHub Copilot’ta.
Bu duyuru, geçen haftaki Claude Opus 5.5 duyurusuyla aynı hikâyeyi anlatıyor: rekabet artık en yüksek skorda değil, aynı skoru kaç dolara verdiğinizde. Grafiklerin hepsinin skor-maliyet ekseninde çizilmiş olması bunun en açık göstergesi.
Karşılaştırma verilerini okurken iki şeyi akılda tutmak gerekiyor. Birincisi, rakip model skorları kamuya açık raporlardan alınmış ve Fable 5.1 verisi bulunamadığında Fable 5 skorları kullanılmış. İkincisi, OpenAI’in kendi dipnotu: Fable 5.1’in maliyeti, görevlerin yüzde 40’ında devreye giren fallback maliyeti dahil edilmediği için eksik gösteriliyor. Bu tür dipnotlar genelde başlıklara yansımıyor.
Pratik çıkarım, kendi iş yükünüzü ölçmekten geçiyor. Sol ve Luna’nın vaadi daha iyi cevap değil, aynı cevabın daha ucuza alınması. Bunu test etmenin yolu benchmark tablosu okumak değil, mevcut agent iş akışınızı iki modelde çalıştırıp harcanan token ve tamamlanan görev sayısını karşılaştırmak. Caching iyileştirmeleri de faturayı doğrudan etkilediği için, ölçümü cache isabet oranınızla birlikte yapmakta fayda var.
Kaynak: https://openai.com/index/introducing-gpt-6-sol-and-luna/