
Microsoft, üçüncü nesil yapay zekâ hızlandırıcısı Azure Maia 300‘ün mimarisini ayrıntılı bir yazıyla anlattı. Azure Hardware Systems and Infrastructure başkanı Rani Borkar ve Saurabh Dighe imzalı yazı, çipin yalnızca bir silikon değil; yazılım, ağ, rack altyapısı ve veri merkeziyle birlikte tasarlanmış bir sistem olduğunu vurguluyor. Maia 300’ün duyurusunu daha önce şurada ele almıştık; bu yazı mimari tarafına odaklanıyor.
Maia’nın ilk günden beri tek bir hedefi var: büyük dil modeli çıkarımını (inference) uçtan uca optimize edip harcanan her watt ve her dolardan daha fazla “zekâ” elde etmek. Microsoft’a göre çok adımlı yürütme, uzun bağlamlı decode ve araç kullanımı içeren ajan tabanlı iş yükleri çıkarımın hesaplama profilini değiştiriyor. Bu yükleri karşılamak için veriyi hesaplamaya yakın tutmak, yeterli bellek kapasitesi ve bant genişliği sağlamak, veri hareketini azaltmak ve tüm bunları veri merkezinin sabit güç ve soğutma sınırları içinde yapmak gerekiyor.
Microsoft bu iş yüklerini Microsoft Copilot, GitHub Copilot ve Microsoft Foundry üzerinden ölçekte çalıştırıyor. Maia 300’ün hedefi, watt başına ve dolar başına üretilen işe yarar token sayısını en üst düzeye çıkarmak.
Yazılım tanımlı veri akışı: SDLA
Maia 200 ile birlikte Microsoft, Software Defined Locally Accessed Dataflow Architecture (SDLA) adını verdiği bir hızlandırıcı mimarisi tanıtmıştı. Mimarinin çıkış noktası, verinin saklanması, taşınması ve dönüştürülmesinin modern yapay zekâ sistemlerinin temel sorunlarından biri olması. SDLA, kontrol yolu programlamasını veri yolu yürütmesinden ayırıyor. Yazılım; verinin yerleşimini, hareketini, dönüşümünü ve senkronizasyonunu yerel bellekler, DMA motorları, hesaplama motorları ve ağ arasında açıkça koordine edebiliyor.
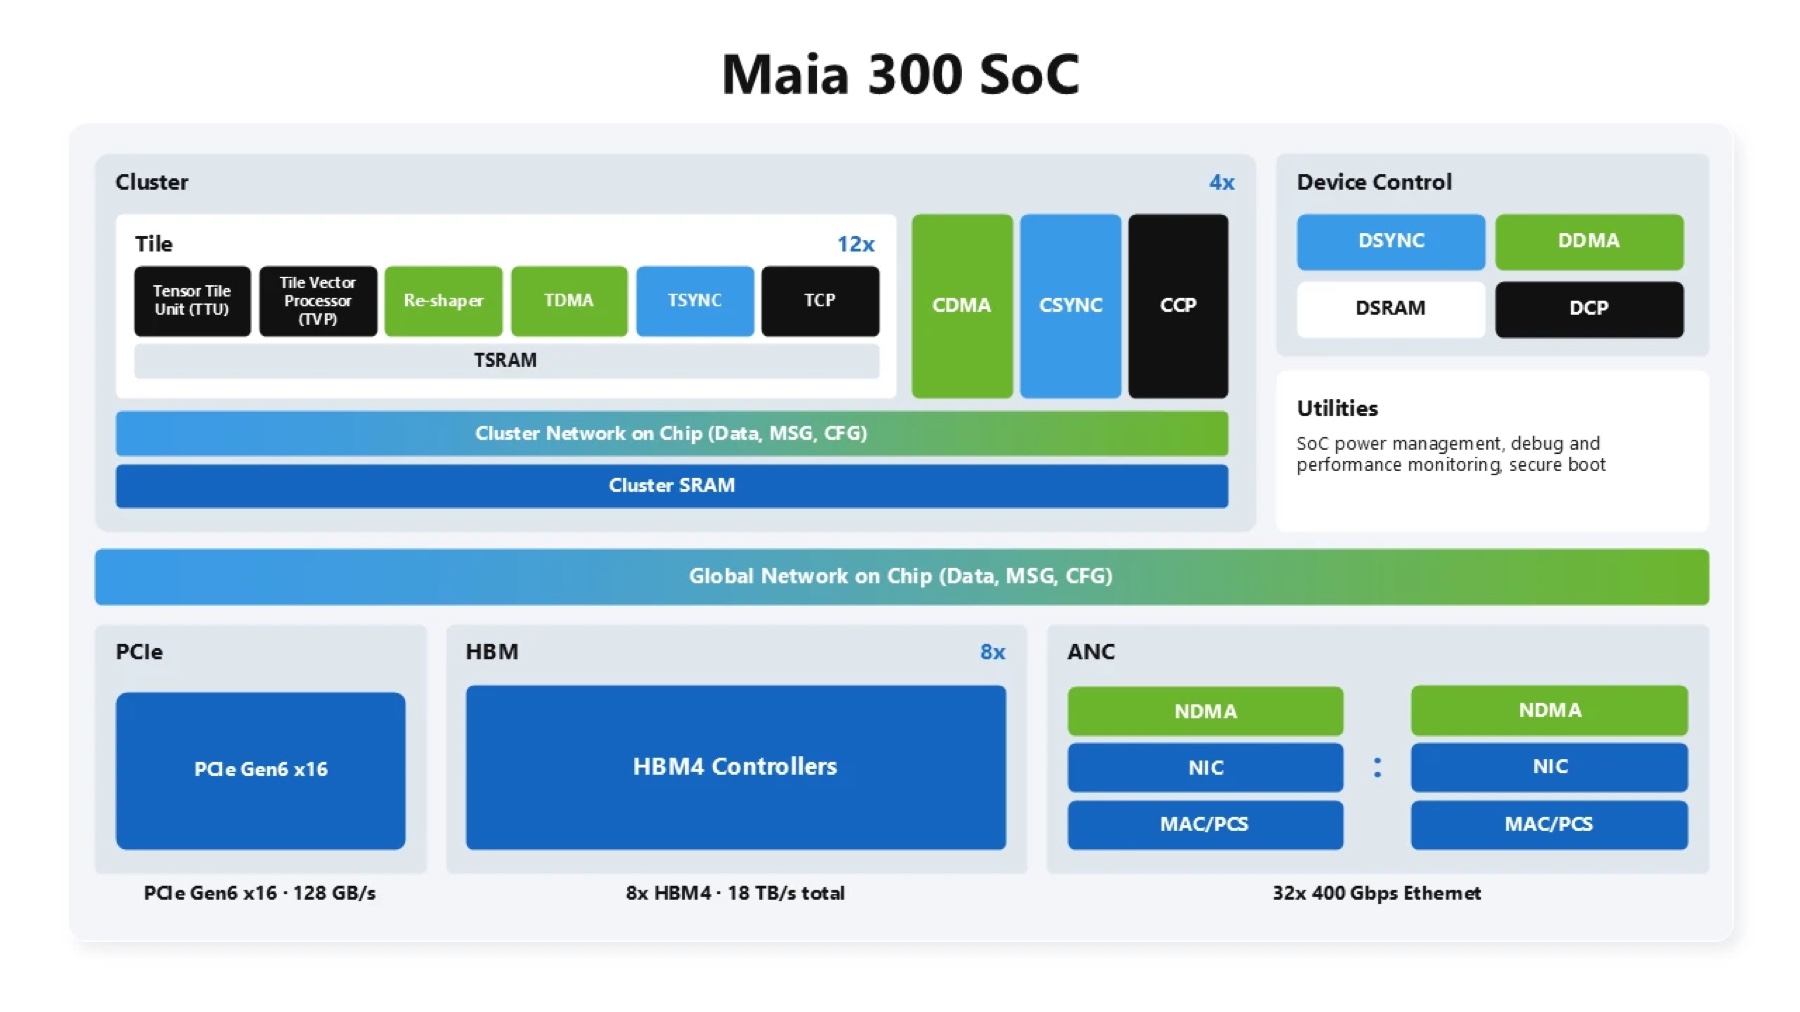
Maia 300 bu mimariyi uzun bağlamlı, akıl yürütme ağırlıklı ve decode yoğun çıkarım için üç noktada geliştiriyor:
- Bellek, SoC’deki tekdüze erişimli (UMA) yapıdan chiplet’ler arasında konuma duyarlı, tekdüze olmayan (NUMA) bir yapıya geçiyor. Yazılım veriyi onu kullanan hesaplama biriminin yanına yerleştirebiliyor.
- Donanım hızlandırmalı veri tipi dönüşümüyle gelen yeni dar hassasiyetli formatlar, token başına taşınan bayt miktarını azaltıyor.
- Rack başına hızlandırıcı sayısı 96’ya çıkıyor ve scale-up alanı 12.288 hızlandırıcılık bir “superpod”a büyüyor.
Watt başına performansı artıran yenilikler
Microsoft, performansı yalnızca daha fazla güç ve silikon alanıyla artırmak yerine veri hareketi, yerellik, hassasiyet ve bellek verimliliği üzerinden iyileştirdiğini söylüyor:
- Çoklu chiplet mimarisi: Hesaplama birimleri TSMC N2P sürecinde üretiliyor. Bellek denetleyicisi ve G/Ç işlevleri ise bant genişliği, bağlantı ve maliyet için optimize edilmiş ayrı kalıplara (die) taşınıyor. Bu yaklaşım hesaplama FLOP’larını %36 artırıyor, HBM bant genişliğini 2,5 katına çıkarıyor ve %14 daha fazla scale-up bant genişliği sağlıyor.
- Düşük hassasiyetli çıkarım: Geliştirilmiş MXFP4 ve 3 bitin altındaki depolama formatları bellek ayak izini ve veri hareketini azaltıyor. Aynı güç bütçesiyle daha büyük modeller, daha uzun bağlamlar ve daha fazla eşzamanlı oturum destekleniyor.
- ISA geliştirmeleri: Vektör motoru softmax, düşük hassasiyetli veri dönüşümü gibi temel çıkarım çekirdekleri için optimizasyonlar içeriyor.
- Kalıp üzerinde verimli veri hareketi: Her hesaplama bölgesinin yakınında bir bellek var. SDLA’nın DMA motorları, yerel SRAM, HBM ve çip içi ağ üzerindeki açık kontrolü sayesinde veri daha kısa mesafe kat ediyor ve taşıma için harcanan enerji düşüyor.
- Watt başına bant genişliği odaklı bellek hiyerarşisi: Yazılım tarafından yönetilen SRAM ile birlikte hızlandırıcı başına 288 GB kapasite ve 18 TB/s bant genişliği sunan sekiz HBM4 yığını. Maia 200’e göre 2,5 kat bellek bant genişliği, %33 daha fazla kapasite ve watt başına yaklaşık 2 kat HBM bant genişliği.
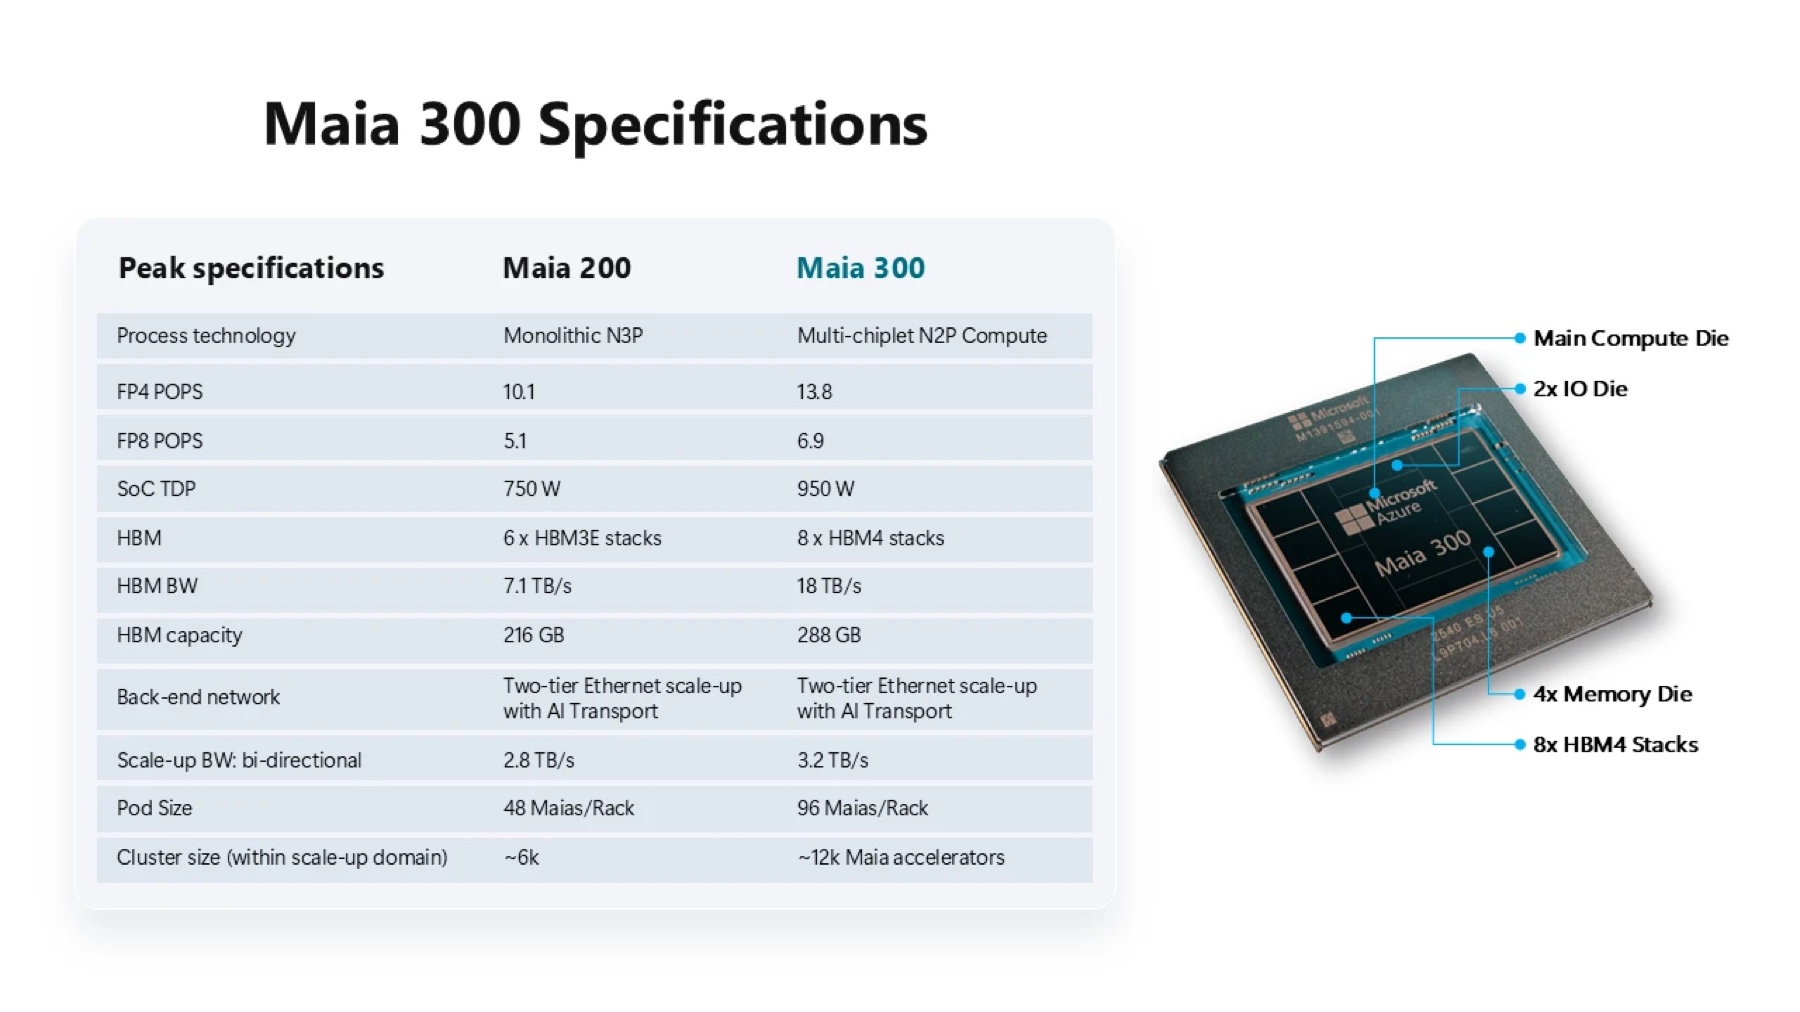
Görseldeki teknik özellik tablosunun Türkçesi:
| Tepe değerler | Maia 200 | Maia 300 |
|---|---|---|
| Üretim teknolojisi | Monolitik N3P | Çoklu chiplet, N2P hesaplama |
| FP4 POPS | 10,1 | 13,8 |
| FP8 POPS | 5,1 | 6,9 |
| SoC TDP | 750 W | 950 W |
| HBM | 6 x HBM3E yığını | 8 x HBM4 yığını |
| HBM bant genişliği | 7,1 TB/s | 18 TB/s |
| HBM kapasitesi | 216 GB | 288 GB |
| Arka uç ağı | İki katmanlı Ethernet scale-up, AI Transport | İki katmanlı Ethernet scale-up, AI Transport |
| Scale-up bant genişliği (çift yönlü) | 2,8 TB/s | 3,2 TB/s |
| Pod boyutu | Rack başına 48 Maia | Rack başına 96 Maia |
| Küme boyutu (scale-up alanı içinde) | ~6 bin | ~12 bin Maia hızlandırıcı |
Tek scale-up ağı: Pod’dan superpod’a
Maia 300’de ağ, yazılım tanımlı veri akışı mimarisinin doğal bir uzantısı olarak tasarlanmış. Maia’nın yapay zekâ ağ denetleyicisi Ethernet tabanlı özel bir AI transport protokolü kullanıyor. İki katmanlı ağ, 12.288 hızlandırıcıya kadar çıkan bir superpod oluşturuyor. Yazılım açısından superpod içindeki herhangi bir hızlandırıcıya veri göndermek aynı iletişim modeliyle yapılıyor.
- Yarı anahtarlamalı rack içi topoloji: Her hızlandırıcının scale-up bağlantısı doğrudan bağlantılar ve anahtarlamalı yollar arasında bölünüyor. Doğrudan bağlantılar aynı tepsideki iki hızlandırıcıyı birbirine bağlıyor; anahtarlamalı ağ ise rack’teki 96 hızlandırıcının tamamını bir pod olarak birleştiriyor. Güç ve maliyeti düşürmek için rack içindeki tüm bağlantılar elektriksel.
- Rack’ler arası optik ikinci katman: İkinci katman switch’ler 128’e kadar rack’i birleştirerek superpod’u oluşturuyor. Pod’lar arasındaki mesafe için optik bağlantı kullanılıyor.
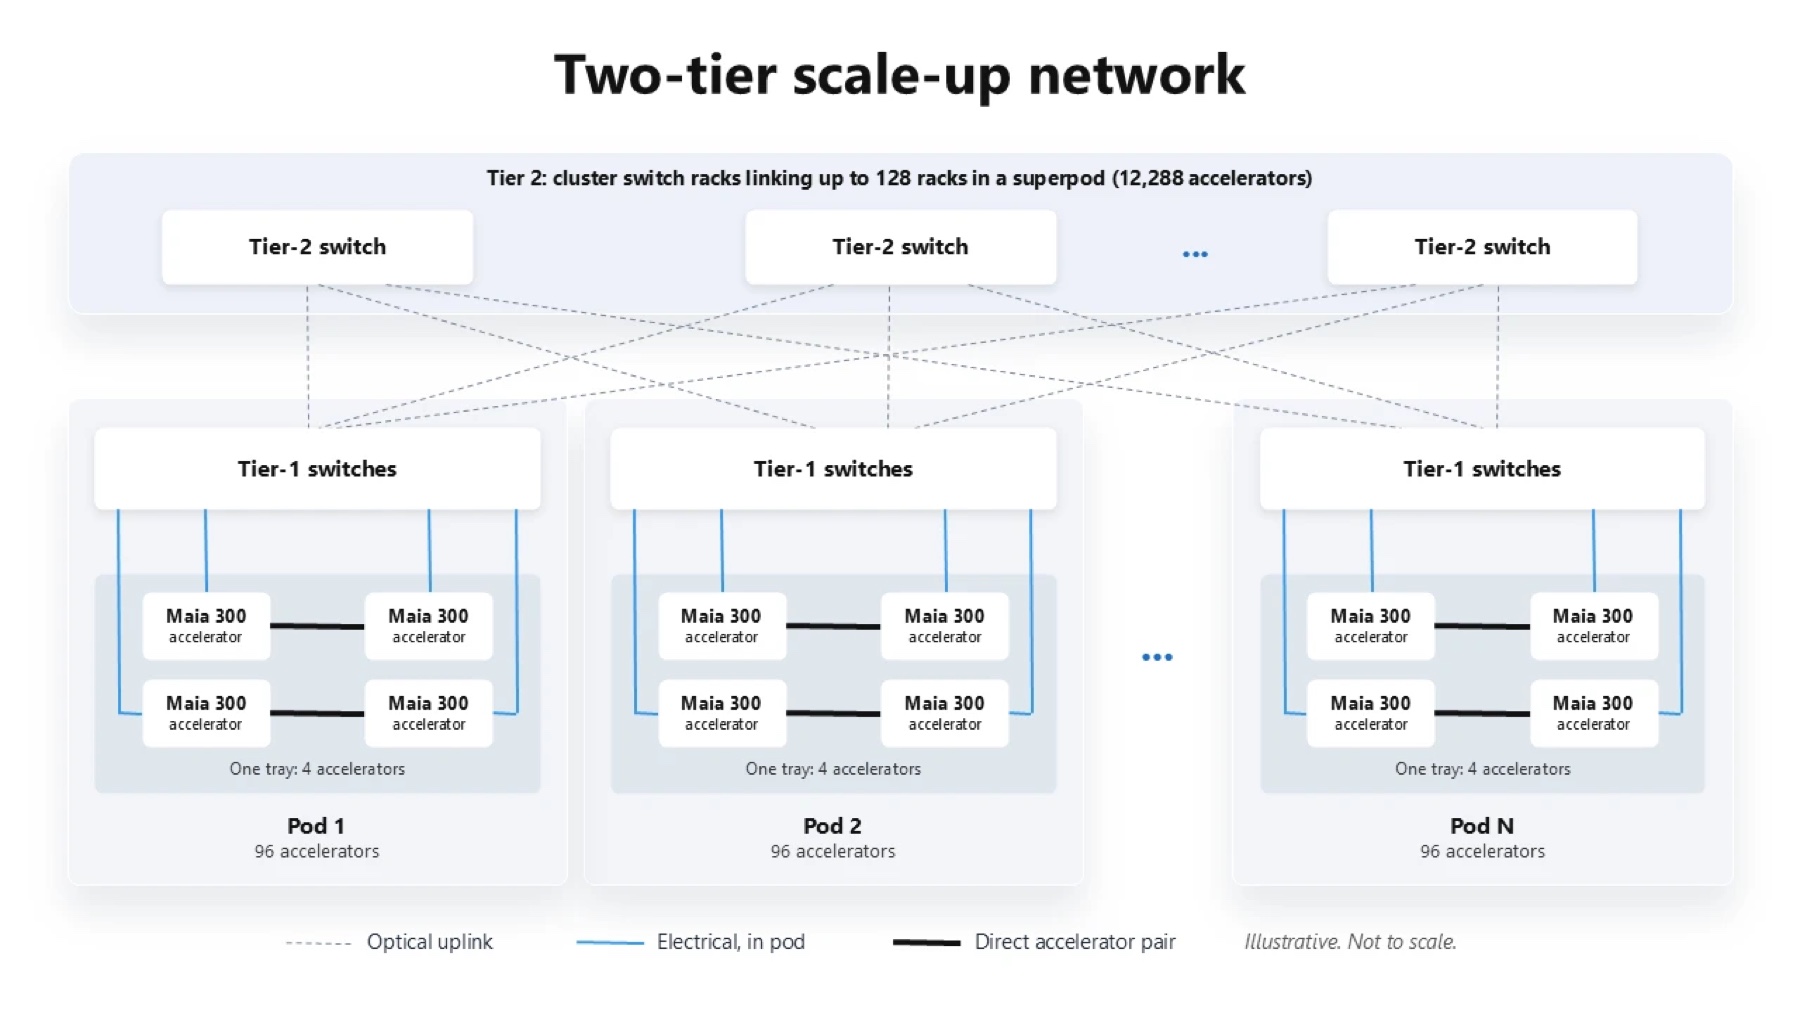
- Ayrı scale-up ve scale-out alanları yerine tek ağ: Entegre ağ denetleyicileri pod içinde ve superpod genelinde aynı iletişim semantiğini kullanıyor. Hızlandırıcılar, host’u ya da ayrı bir scale-out NIC’i devreye sokmadan superpod’daki herhangi bir hızlandırıcıyla doğrudan iletişim başlatabiliyor.
- Az atlamalı yollar: Üç gecikme seviyesi var. En düşük gecikme doğrudan bağlı hızlandırıcı çiftinde. Pod içindeki hızlandırıcılar bir switch atlaması, pod’lar arasındaki hızlandırıcılar üç switch atlaması uzaklıkta. Gecikmeye duyarlı tensor-parallel trafik en düşük gecikmeli alanda tutulabiliyor.
- İş yüküne göre bant genişliği: Hızlandırıcı başına rack içi ve rack’ler arası bant genişliği paylaşımı tasarımda sabitlenmiyor; işlerin yerleşimine göre ayarlanan bir parametre. Yalnızca bir kısım hızlandırıcı rack dışına çıktığında, bir hızlandırıcı superpod’daki herhangi bir eşine 750 GB/s’ye kadar veri gönderebiliyor.
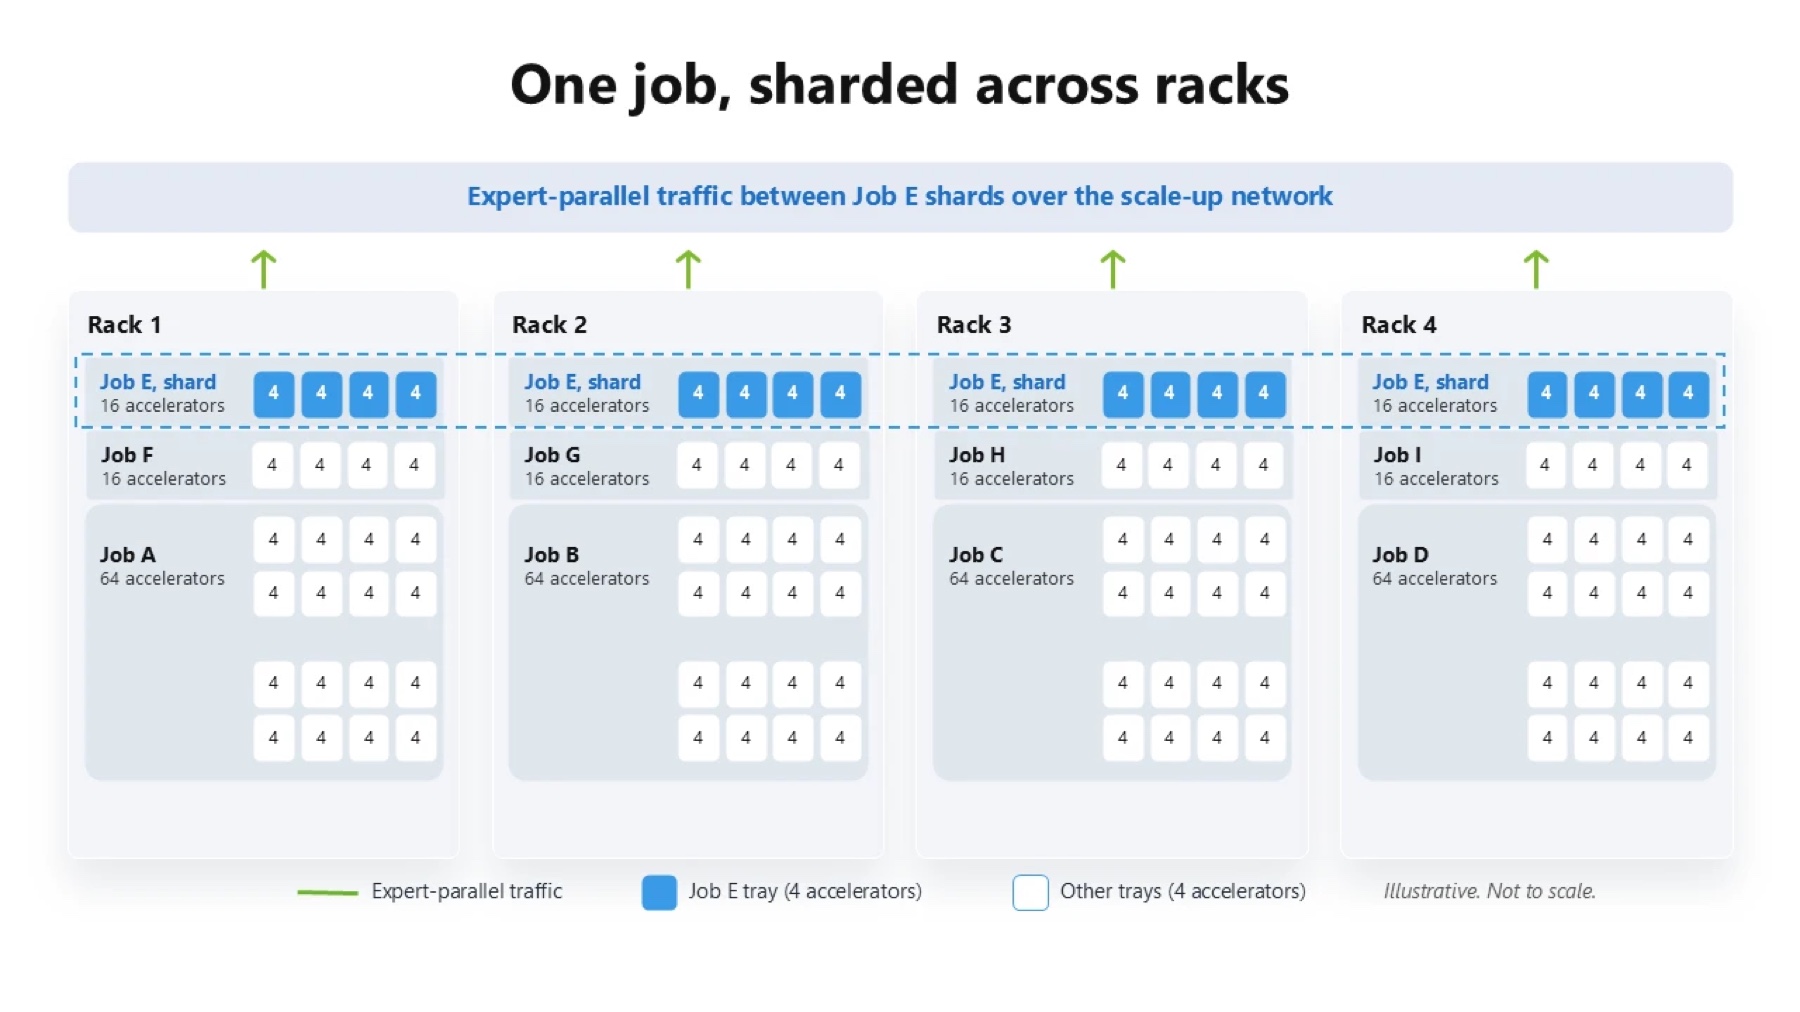
- Esnek iş yerleşimi: Tensor paralelliği 96 hızlandırıcılı rack içinde kalırken daha geniş expert ve pipeline paralelliği rack’lere yayılabiliyor. İş boyutu fiziksel rack yapısına uymadığında boşta kalan hızlandırıcı sayısı azalıyor.
- Scale-up alanı içinde ayrıştırılmış çıkarım: Prefill ve decode işçileri birbirinden bağımsız boyutlandırılıp yerleştirilebiliyor. Prefill tamamlandığında KV durumu, host üzerinden geçen ayrı bir scale-out yolu yerine aynı scale-up ağı üzerinden doğrudan decode işçilerine aktarılıyor.
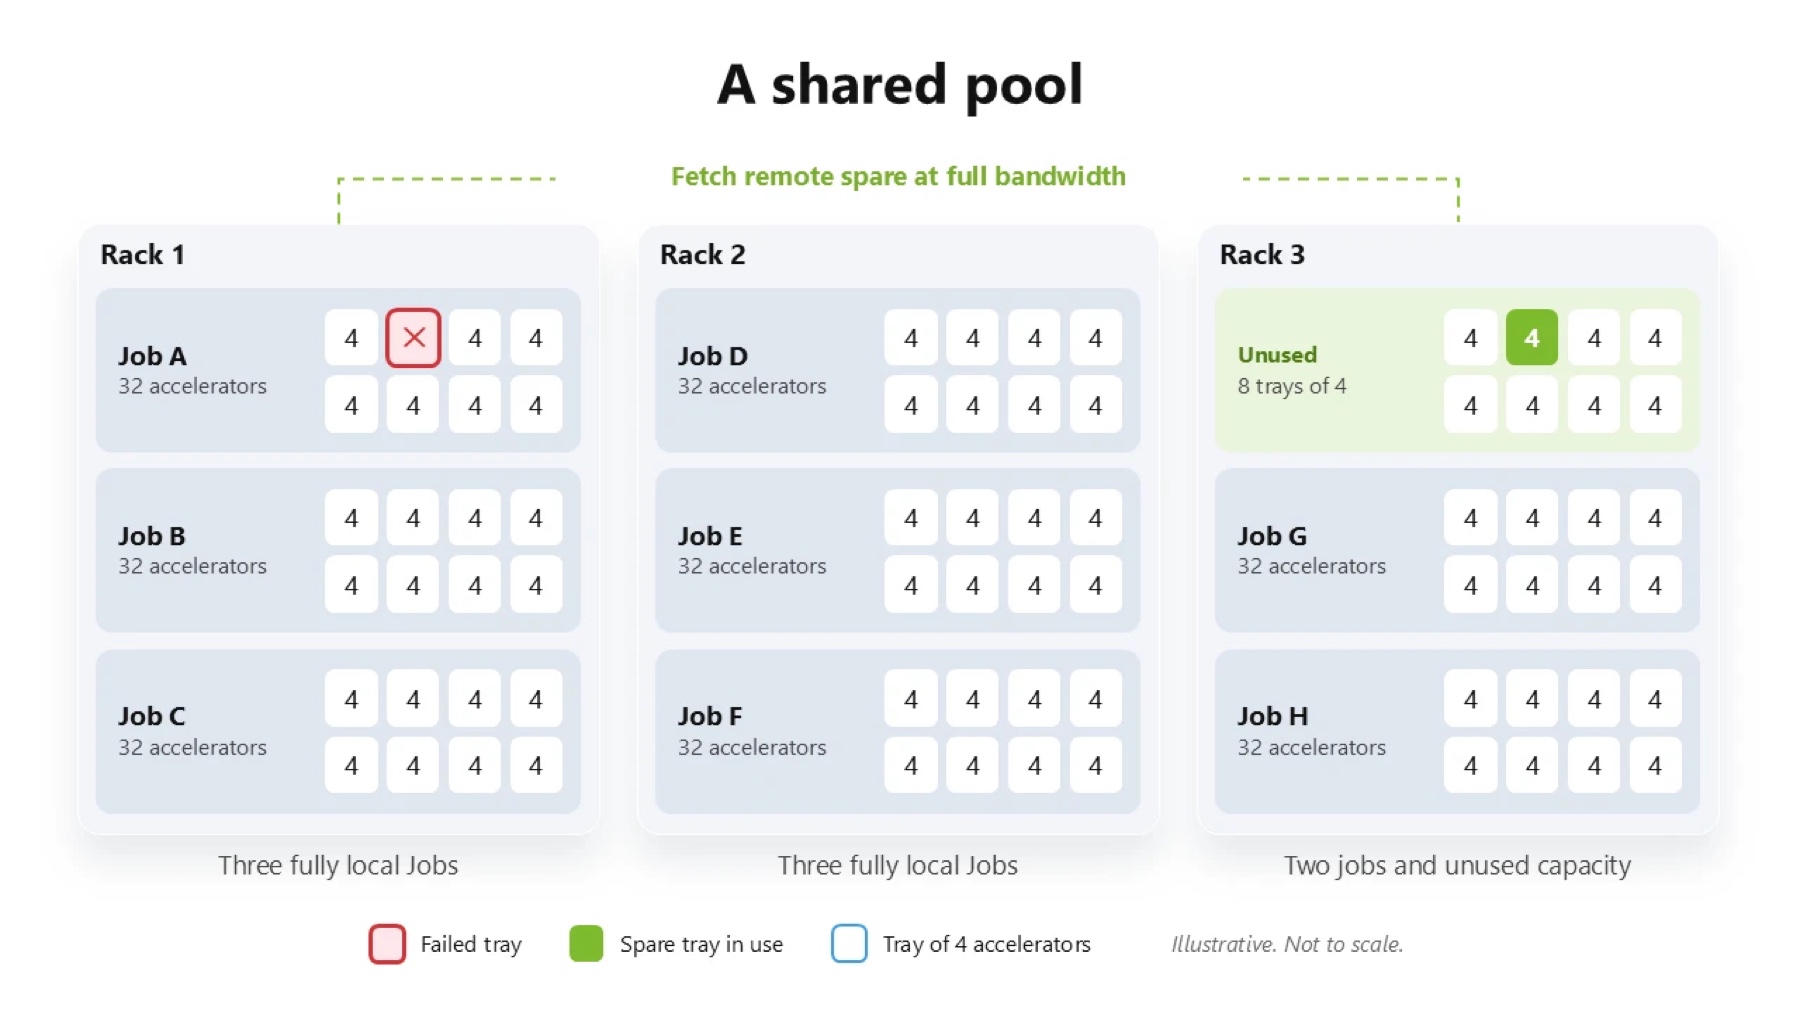
- Rack’ler arası dayanıklılık: Hızlandırıcılar devre dışı kaldığında zamanlayıcılar superpod içindeki başka bir rack’teki yedek kapasiteyi kullanabiliyor. Bu, yazılım çekirdekleri açısından şeffaf. İş yükü scale-up ağında kalıyor; biraz daha uzun yol gecikmesi karşılığında erişilebilirlik ve kaynak kullanımı artıyor.
Rack ölçeğinde mimari
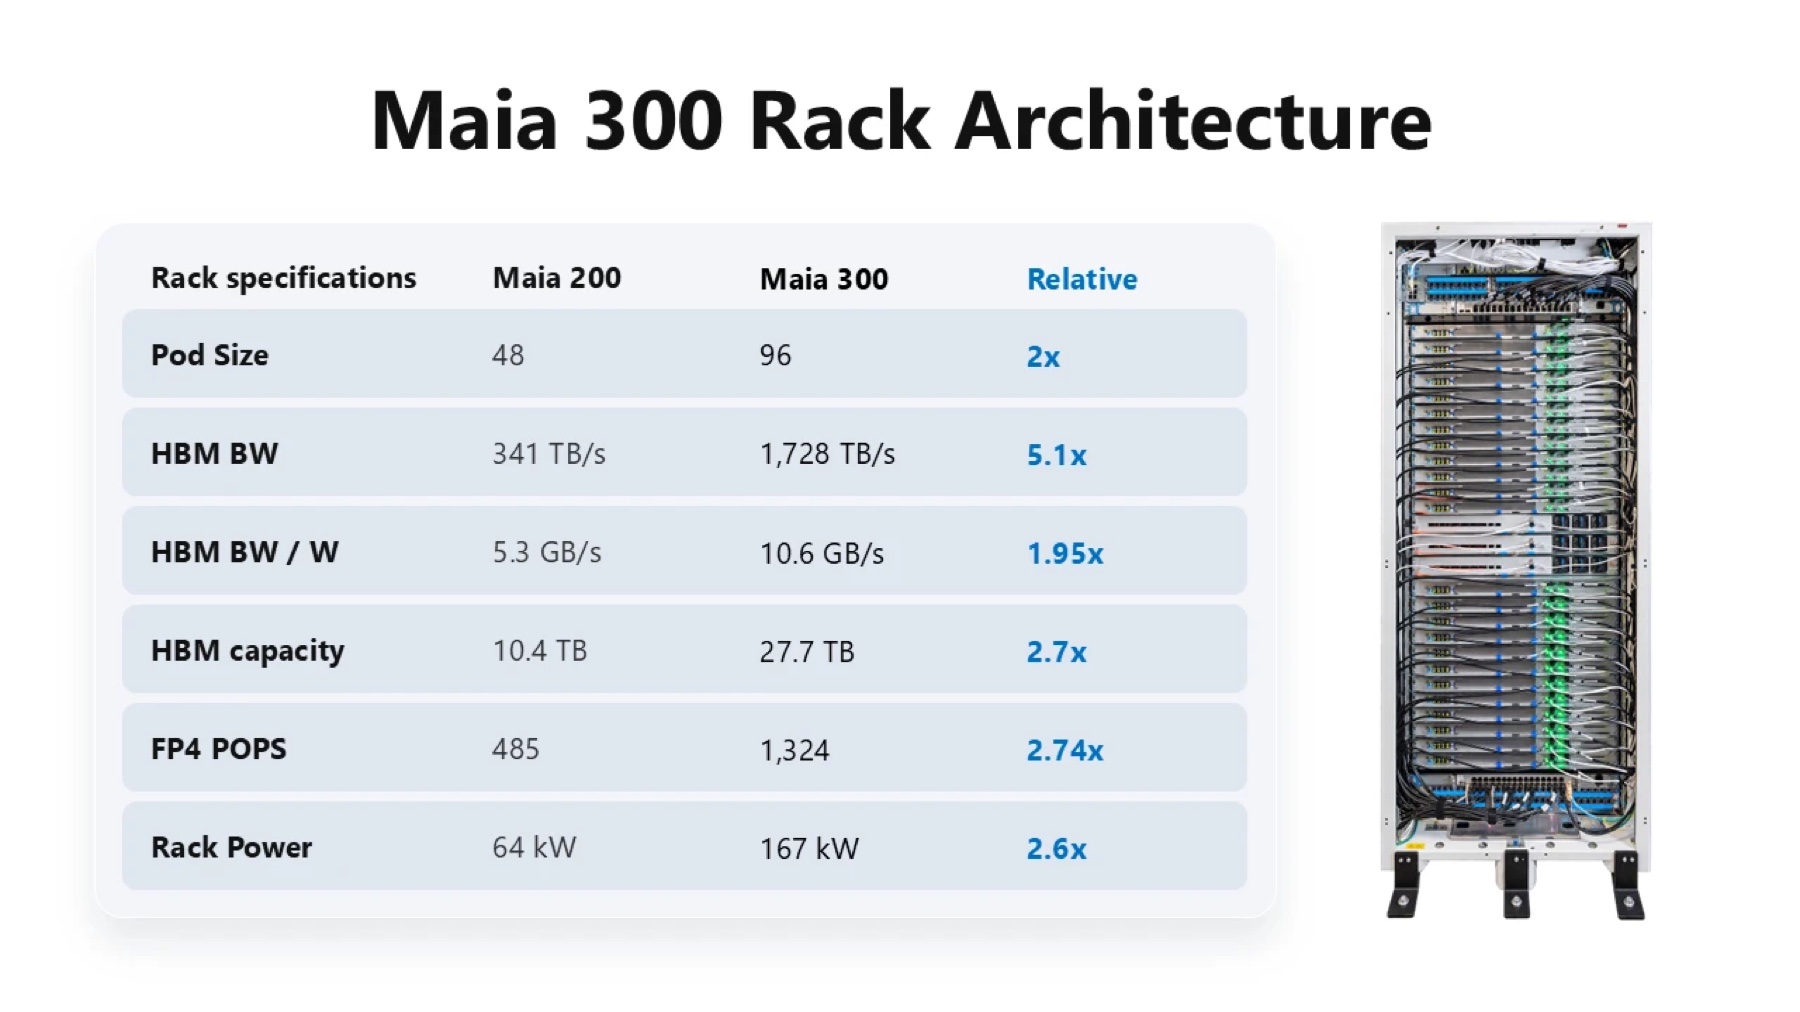
Veri merkezi ölçeğinde verimlilik, sabit bir güç ve soğutma bütçesi içinde ne kadar işe yarar altyapı kurulup işletilebildiğine bağlı. Maia 300 rack’i sunucu yerleşimi ve yoğunluğu, ağ topolojisi, güç ve soğutma tasarımı ve telemetriyi birlikte ele alıyor. Microsoft’a göre sonuç, Maia 200’e kıyasla watt başına 2,5 kata kadar daha yüksek performans.
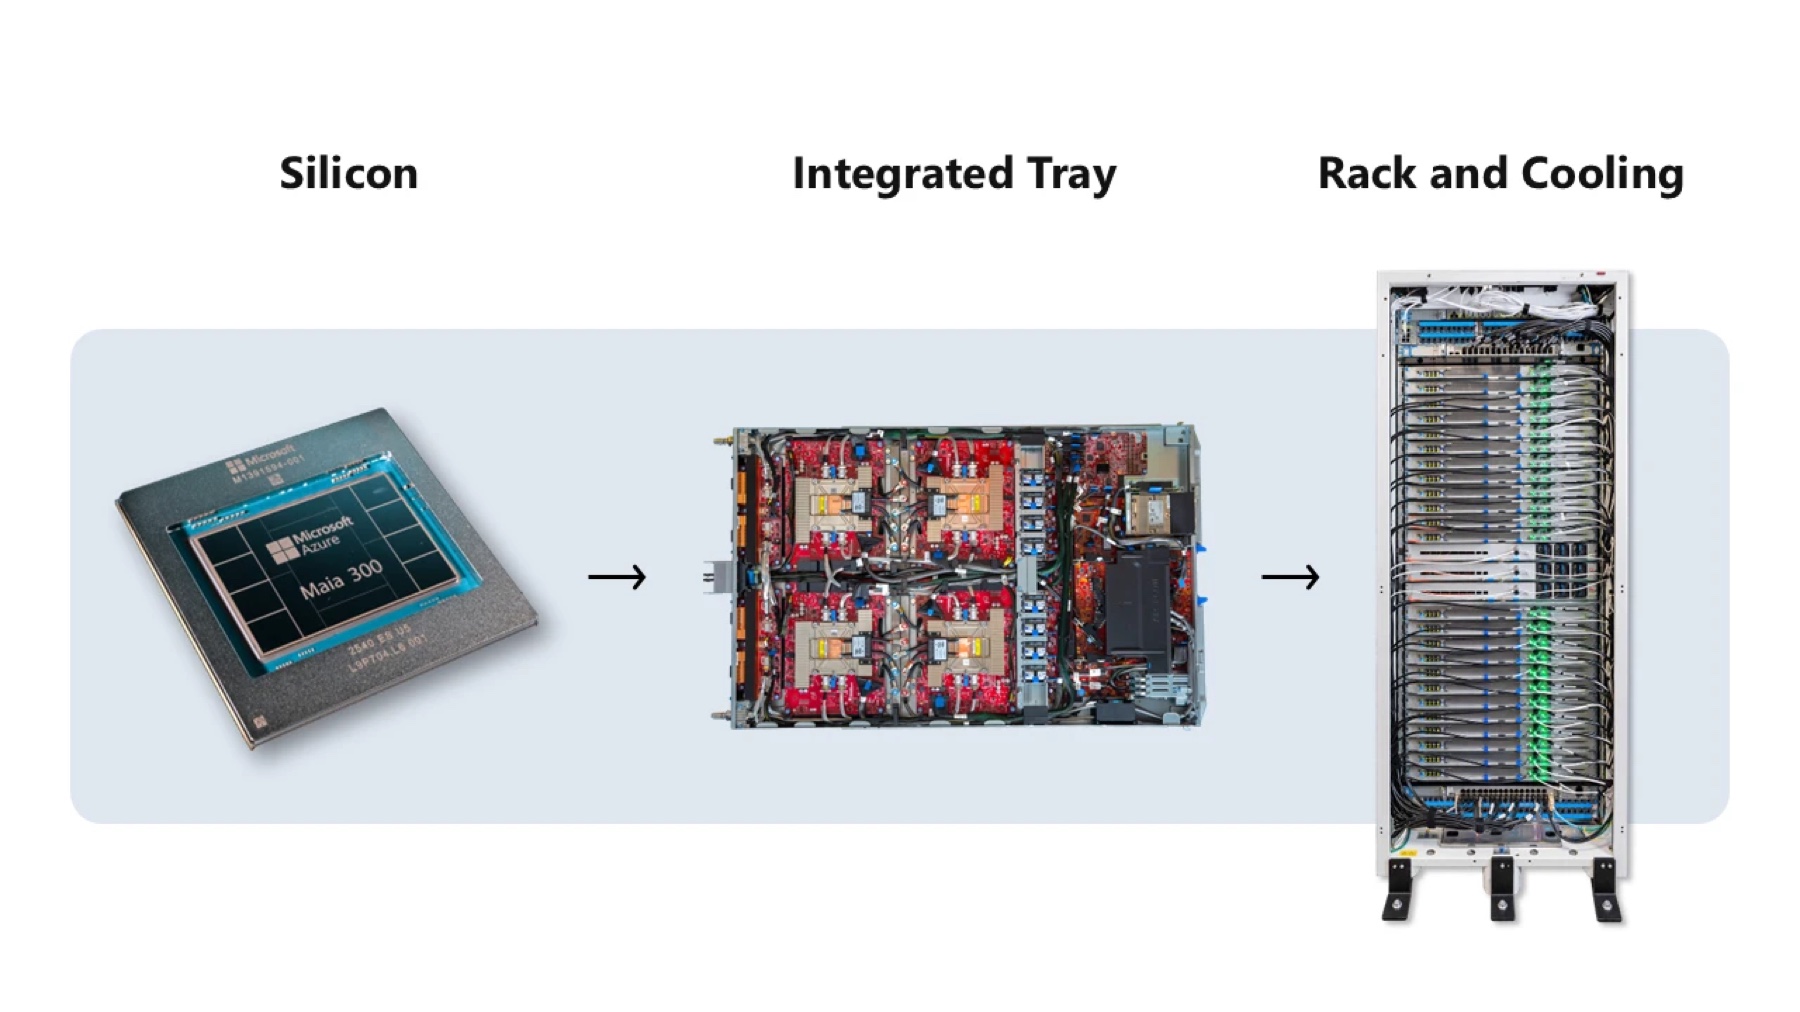
- 167 kW içinde 96 hızlandırıcı: 96 hızlandırıcı, her biri dört hızlandırıcı taşıyan 24 tepsiye yerleşiyor ve rack 167 kW tüketiyor. Bu, Maia 200’ün hızlandırıcı yoğunluğunun iki katı. Her tepside dört hızlandırıcının yanında host işlemci, bellek, depolama ve soğutma da var. Ayrı host tepsilerinin kaldırılması rack’te yer açıyor ve güç ile ısı tek bir sistem olarak yönetilebiliyor.
- Birleştirilmiş switch mimarisi: Altı yüksek port sayılı switch ASIC’i, sıvı soğutmalı üç switch tepsisine entegre edilmiş. 96 hızlandırıcının ihtiyaç duyduğu rack içi bağlantıyı sağlarken switch’lerin kapladığı alanı ve gücü azaltıyor.
- Rack seviyesinde güç dağıtımı: Çift güç beslemesi, yüksek kapasiteli güç rafları ve 50 V busbar mimarisi gücü hızlandırıcı ve switch tepsilerine verimli şekilde dağıtıyor. Entegre otomatik transfer anahtarı, beslemelerden biri bakım için kapalıyken bile erişilebilirliği koruyor.
- Esnek soğutma: Sıvı soğutma, hızlandırıcılar, voltaj regülatörleri ve switch ASIC’lerinden gelen ısının %80’inden fazlasını alıyor. Bellek, depolama ve diğer bileşenler hava ile soğutuluyor. Maia 300, tesis suyu bulunan yerlerde doğrudan ona bağlanabiliyor; hava soğutmalı veri merkezlerinde ise bir ısı eşanjörü ünitesi kullanabiliyor.
- Veri merkeziyle entegre telemetri: Önceki dağıtımlardan alınan derslerle güvenilirlik, erişilebilirlik ve servis edilebilirlik (RAS), gözlemlenebilirlik, hata ayıklama ve yedeklilik güçlendirilmiş. Rack ve sıra seviyesindeki güç telemetrisi veri merkezi operasyonlarına bağlanıyor. Bu veriler, gücü dinamik olarak dağıtan ve iş yükü yerleşimini optimize eden algoritmaları besliyor.
Maia 300 ne getiriyor?
Microsoft’un verdiği rakamlara göre Maia 300, 96 hızlandırıcılı tam yapılandırmada Maia 200’e kıyasla rack ölçeğinde 7 kata kadar daha yüksek token işleme hacmi ve 2,5 kattan fazla watt başına performans sunuyor. Watt başına daha fazla bellek bant genişliği, rack başına iki kat hızlandırıcı ve çekirdekten veri merkezi ölçeğine kadar tek bir programlama modeli sunan iki katmanlı scale-up ağı da bunun parçası.
Microsoft, Kasım’da San Francisco’da ve çevrim içi düzenlenecek Microsoft Ignite 2026‘da yapay zekâ stratejisi hakkında daha fazla bilgi paylaşacağını söylüyor. Ek kaynaklar: Maia 300 ürün sayfası, Azure’un silikondan sistemlere yaklaşımı ve Maia 200 mimari yazısı.
Rakamların hepsi Microsoft’un kendi ölçümleri ve “en fazla” ifadesiyle verilmiş; bağımsız bir karşılaştırma henüz yok. Yine de tablodaki tepe değerler net bir tablo çiziyor: hesaplama gücü yaklaşık %36 artarken bellek bant genişliği 2,5 katına çıkıyor. Microsoft’un bu nesilde en çok yatırımı bellek ve veri hareketine yaptığı görülüyor.
Kaynak: https://azure.microsoft.com/en-us/blog/deep-dive-into-azure-maia-300-architecture/