
Google Antigravity ekibinden Alex Astrum’un yazısının çıkış noktası şu: Ajanlarla çalışırken artık asıl kısıt modelin kendisi değil, onun etrafına kurulan düzen, yani harness. Yazı tek seferlik prompt’lardan saatlerce kendi başına çalışabilen agentic döngülere (loop) nasıl geçileceğini anlatıyor. Bunu yaparken sayılarla düşünmeyi öneriyor. Aşağıda yazının ana fikirlerini, hesaplarını ve kod örneklerini özetledim.
Her iş için ajan döngüsü gerekmez
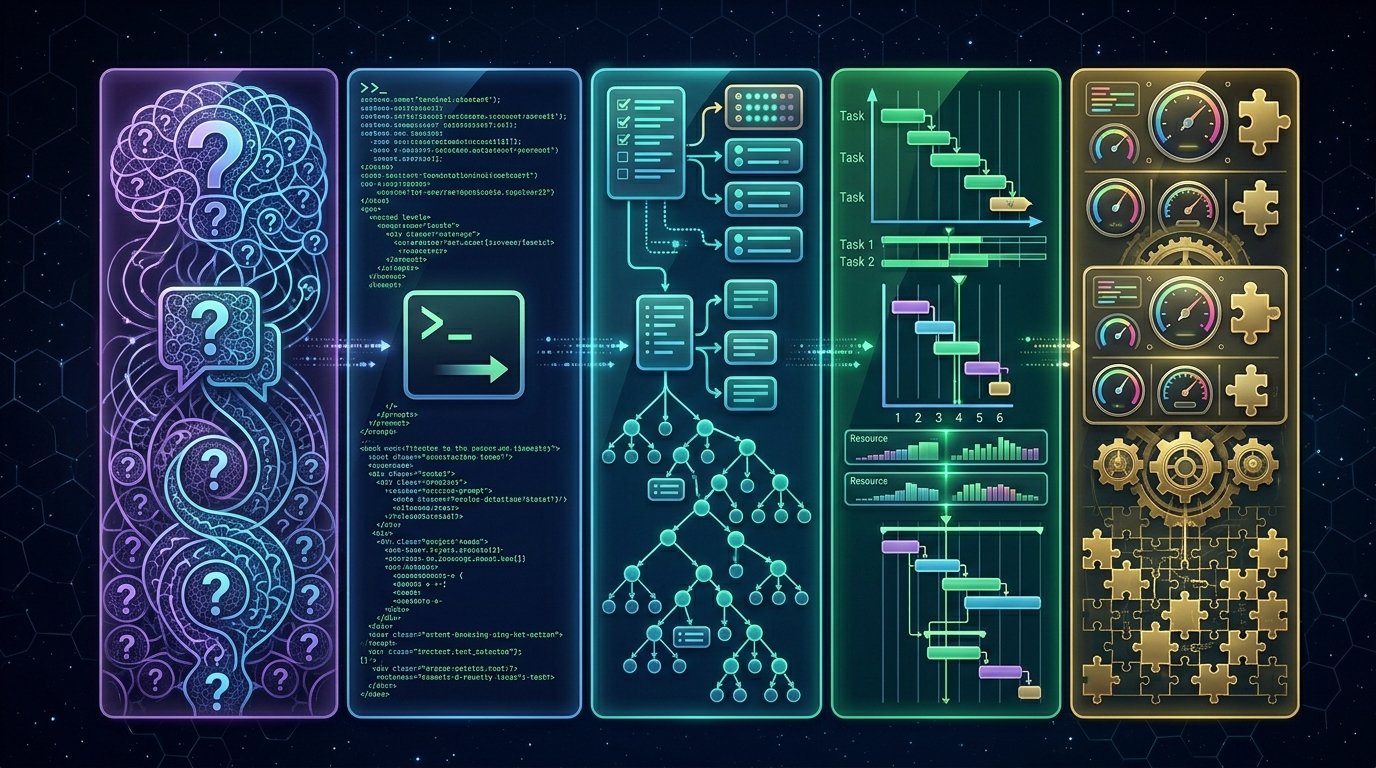
Yazar ajanlara verilen işleri beş seviyeye ayırıyor:
- Basit soru: Ajana gerek yok, bir asistan cevaplar.
- Görev veya fikir: Tek prompt’la çözülebilir. Hızlı prototip için Google AI Studio öneriliyor.
- Uygulama veya büyük özellik (story): Yapay zekâdan önce haftalık planlama gerektiren iş. Burada döngüler ve Antigravity gibi tam donanımlı ajanlar devreye giriyor. Spec, plan ve çalıştırılabilir testler döngü başlamadan önce sabitleniyor.
- Proje (epic): Birbirine bağlanan birkaç özellik. Döngüler planlamada da işe yarıyor.
- Sistem: Tüm projelerin üst görünümü. AGENTS.md talimatları, skill’ler, doğrulama kapıları ve izleme burada kuruluyor. Döngülerin en çok fark yarattığı seviye bu, riskin en yüksek olduğu seviye de bu.
Döngü fikri nereden geldi?
Yazar döngülerin geçmişini kısaca şöyle özetliyor. Başlangıç noktası Ekim 2022’deki ReAct makalesi. ReAct, akıl yürütme adımlarıyla araç çağrılarını iç içe kullanıyordu. 2023’te AutoGPT geldi. Sık sık sonsuz döngüye girse de geliştiricilerin elini sürmeden çalışan otomasyon istediğini gösterdi. 2025 ortasında geliştiriciler prompt’u komut satırı ajanına basan ve her turda bağlamı sıfırlayan basit bash döngüleri yazmaya başladı. Bu yöntem kalıcı durum modelin dışında tutulduğu için işe yarıyordu: Git geçmişinde, ilerleme dosyalarında ve test suite’inde. 2026 baharında araçlar bu deseni /goal gibi yerleşik komutlarla hazır olarak sunmaya başladı.
Yazıda aktarılan bir araştırmaya göre 2026 başında GitHub’daki 128 binden fazla aktif repodan yüzde 22 ile 29’u kodlama ajanı kullanıyor.
Hesap: neden doğrulama kapısı şart?
Yazının en işe yarar kısmı bence bu basit olasılık hesabı. Her adımı birbirinden bağımsız ve başarı olasılığı p olan N adımlık bir zincirin tamamının başarılı olma olasılığı pN. Adım başına yüzde 95 doğrulukla 20 dosya değişikliği yapan bir ajan, işi baştan sona sadece yüzde 36 ihtimalle doğru bitiriyor. Adım başına doğruluk yüzde 75 ise 10. adımda bu oran yüzde 6’nın altına iniyor. Yazar 0,95’in bir benchmark sonucu değil, örnek amaçlı seçilmiş bir sayı olduğunu özellikle belirtiyor.
Çözüm sonsuz retry değil. Hatanın nerede olduğunu gösteren bir kontrol ve tek bir hedefli düzeltme denemesi yeterli. Kontrol hatayı yüzde 95 ihtimalle yakalayıp düzeltiyorsa adım başına başarı 0,95 + (0,05 × 0,95) = yüzde 99,75’e çıkıyor. Bu hesabın tutması için kontrolün ajandan bağımsız olması gerekiyor. Derleyiciler, test suite’leri ve linter’lar bu bağımsızlığı zaten sağlıyor. Testle ölçülemeyen anlamsal değerlendirmelerde yazar farklı model ailelerinden bir reviewer kullanıyor. Böylece reviewer, işi yapan modelle aynı kör noktaları paylaşmıyor.
| Zincir uzunluğu | %95 doğruluk | %95 + tek düzeltme |
|---|---|---|
| 3 adım | %86 | %99 |
| 5 adım | %77 | %99 |
| 10 adım | %60 | %98 |
| 15 adım | %46 | %96 |
| 20 adım | %36 | %95 |
| 30 adım | %21 | %93 |
| 50 adım | %8 | %88 |
Bağlam şişmesi de ayrı bir sınır. Her adım bağlamın yaklaşık yüzde 1’ini dolduruyorsa 50 adım civarında sıkıştırma gerekiyor. Yazarın önerisi işi her biri en fazla yaklaşık 20 adımlık alt görevlere bölmek. Üstte de sonuçları birleştiren ve kendi 20 adımlık bütçesi olan bir süpervizör ajan olacak. Her seviyenin kendi değerlendirmesi ve nihai kabul kriterleri olmalı.
Dayanıklı bir sistemin beş ayağı
- Kalıcı durum: Git tabanlı checkpoint’ler sayesinde ajan bir çökme sonrasında kaldığı yerden devam edebiliyor.
- Doğrulama kapıları: Testler ve derleyiciler değişiklikleri deterministik olarak kontrol ediyor. Kabul kriterleri ve testler kod yazılmadan önce yazılmalı. Proje talimatlarında açık bir kural olmalı: ajan bir testi silerek ya da gevşeterek kapıdan geçemez.
- Eval’ler: Deterministik olarak doğrulanamayan ama önemli olan her şey için evet/hayır cevaplı değerlendirmeler yazılmalı, hedef yüzde 95’in üzerinde doğruluk. Sonuçlar karışıyorsa kriterleri daha basit parçalara bölmek gerekiyor.
- Durma koşulları: Tur limiti (yazara göre 20 iyi bir nokta) ile token ve maliyet tavanları, API bütçesi kontrolden çıkmadan çalışmayı durduruyor.
- Standart skill ve talimatlar: SKILL.md formatında tekrar kullanılabilir modüller ve her çalışmada yüklenen proje kurallarını tutan bir AGENTS.md. Skill’ler yalnızca açıklamaları göreve uyduğunda yükleniyor, bu yüzden bağlamı gereksiz yere doldurmuyor.
Yazarın bence en önemli tespiti şu: Modellerin birbirine üstünlüğü artık birkaç hafta sürüyor. Yeni sürümlerden sonra elde kalan şey harness ve süreçler. Bir çalışma başarısız olduğunda sadece kodu değil harness’ı da düzeltmek gerekiyor: yeni bir test, AGENTS.md’ye bir satır, skill’e bir not. Bir sonraki çalışma bağlamı sıfırdan başlasa da bu dersi devralıyor.
Antigravity’deki hazır komutlar: /grill-me ve /goal
Antigravity bu desenlerin bir kısmını yerleşik komutlara dönüştürmüş. /grill-me etkileşimli bir görüşme açıyor. Bu görüşmede tasarım kısıtları, değişmezler ve başarıyı belirleyecek testler sabitleniyor. /goal ise bu çerçevede uzun, çok turlu çalışmayı yürütüyor. Kısaca önce niyette anlaşılıyor, sonra uygulama ajana bırakılıyor. Aynı harness dosyaları repoyla birlikte taşınıyor. Antigravity 2.0, agy CLI ya da VS Code, JetBrains ve Cursor içindeki Antigravity’de aynı şekilde çalışıyor. Yazar bu komutları kullanırken trajectory uzunluğunu ve modelin kafasının karıştığını gösteren işaretleri takip etmeyi öneriyor.
En basit hali: beş satırlık stateless döngü
Geoffrey Huntley’nin “Ralph” döngüsünden esinlenen en basit Antigravity CLI döngüsü şu:
limit=20
for ((i=1; i<=limit; i++)); do
  agy -p "$(cat prompt.md)" --sandbox || break
  ./commit-and-test && break
done
Bu döngü basit ama her turda bağlam sıfırlandığı için çok dosyalı koordinasyonda kırılgan. Modelin ilerlemesini markdown dosyalarına yazmasını ve git log’u takip etmesini söyleyen bir skill bu eksiğin önemli kısmını kapatabilir.
SDK ile bütçeli süpervizör döngüsü
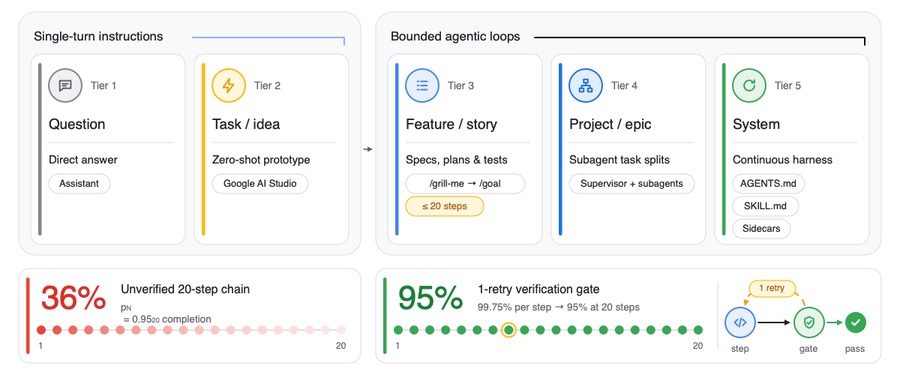
Yazının sonunda Google Antigravity SDK ile yazılmış daha kapsamlı bir Python örneği var. Bu döngü bir süpervizör oturumu açıyor ve görevi çalıştırıyor. Sonra çıktıyı gerçek test suite’iyle doğruluyor ve hata çıktısını tek bir hedefli düzeltme için ajana geri veriyor. Model çağrısı ve token bütçesini de sınırlıyor. İşler modellere görevine göre dağıtılmış:
- Süpervizör ve kodu yazan alt ajan Gemini 4 Carbon kullanıyor.
- Kod tabanında arama yapan alt ajan Gemini 4 Hydrogen kullanıyor.
- Doğrulama ise hiç token harcamayan deterministik bir script’e (
go test) bırakılmış.
import asyncio
import subprocess

from google.antigravity import Agent, LocalAgentConfig, types
from google.antigravity.hooks import policy

def verify_output(workspace_path: str) -> tuple[bool, str]:
    """Verification gate: run the test suite and keep the real failure output."""
    result = subprocess.run(
        ["go", "test", "./..."], cwd=workspace_path, capture_output=True, text=True
    )
    output = (result.stdout + "\n" + result.stderr).strip()
    return result.returncode == 0, output

researcher = types.SubagentConfig(
    name="researcher",
    description="Searches the codebase and summarizes implementation paths.",
    system_instructions=(
        "You are a research subagent. Analyze the codebase, find implementation "
        "paths, and report back without modifying any files."
    ),
    model="gemini-4-hydrogen",
    capabilities=types.SubagentCapabilities(
        enabled_tools=[
            types.BuiltinTools.VIEW_FILE,
            types.BuiltinTools.SEARCH_DIR,
            types.BuiltinTools.FIND_FILE,
        ],
    ),
)

feature_implementer = types.SubagentConfig(
    name="feature_implementer",
    description="Implements a scoped code change and keeps the tests passing.",
    system_instructions=(
        "You are a feature implementation subagent. Follow AGENTS.md, write "
        "clean code, run the tests, and fix compiler errors. Never delete or "
        "weaken a test to make it pass."
    ),
    model="gemini-4-carbon",
    capabilities=types.SubagentCapabilities(
        enabled_tools=[
            types.BuiltinTools.VIEW_FILE,
            types.BuiltinTools.EDIT_FILE,
            types.BuiltinTools.CREATE_FILE,
            types.BuiltinTools.RUN_COMMAND,
        ],
    ),
)

supervisor_config = LocalAgentConfig(
    model="gemini-4-carbon",
    workspaces=["./workspace"],
    subagents=[researcher, feature_implementer],
    policies=[policy.allow_all()],
    budget_config=types.BudgetConfig(
        max_model_calls=20,
        max_total_tokens=200_000,
    ),
    system_instructions=(
        "You are a supervisor agent. Delegate codebase exploration to "
        "@researcher and code changes to @feature_implementer. Summarize each "
        "completed step before moving on."
    ),
)

async def run_agentic_loop(prompt: str, max_retries: int = 1) -> bool:
    async with Agent(supervisor_config) as supervisor:
        for attempt in range(1, max_retries + 2):
            print(f"[Supervisor Loop] Attempt {attempt}/{max_retries + 1}...")
            response = await supervisor.chat(prompt)
            await response.text()

            if response.stop_reason in (
                types.StopReason.MAX_MODEL_CALLS_EXCEEDED,
                types.StopReason.MAX_TOTAL_TOKENS_EXCEEDED,
            ):
                print(f"Loop halted: budget exceeded ({response.stop_reason}).")
                return False

            success, error_msg = verify_output("./workspace")
            if success:
                print("Goal completed: verification gate passed.")
                return True

            prompt = (
                "The previous attempt failed verification with the following output:\n"
                f"{error_msg}\n"
                "Delegate a targeted fix to @feature_implementer and run the tests again."
            )

        print("Verification still failing after the retry. Handing over to a human.")
        return False

if __name__ == "__main__":
    asyncio.run(run_agentic_loop("Refactor types.go to use explicit interfaces."))
Bütçeler şöyle: Süpervizörün tüm oturumu için en fazla 20 model çağrısı (max_model_calls) ve 200 bin token (max_total_tokens) var. Herhangi biri aşılırsa SDK turu durduruyor ve bir stop_reason döndürüyor. max_retries=1, ilk deneme artı bir düzeltme anlamına geliyor. Doğrulama yine geçmezse döngü False döndürüyor ve iş, bütçe bitene kadar dönüp durmak yerine bir insana devrediliyor. Yazar bunun üretime hazır bir çözüm değil, deneysel bir başlangıç noktası olduğunu söylüyor.
Kendi döngüsünü yazıp barındırmak istemeyenler için iki seçenek var. İlki Antigravity Agent: Google Cloud’da izole bir sandbox’ta asenkron çalışan, yönetilen bir kodlama ajanı. İkincisi aynı döngüyü uzun süre açık kalan bir Cloud Run sandbox’ında çalıştırmak. Böylece bilgisayar kapatıldıktan sonra da döngü çalışmaya devam ediyor.
Yazının değeri Antigravity’ye özgü kısımlardan çok, yaptığı basit hesapta. 20 adımlık bir zincirde yüzde 95 doğruluk yüzde 36 başarıya düşüyor, tek bir bağımsız kontrol eklenince yüzde 95’e çıkıyor. Bu fark, “model daha akıllı olsun” beklemek yerine test ve kontrol yazmaya zaman ayırmanın neden mantıklı olduğunu açıkça gösteriyor. Kod örneği Antigravity SDK’ya bağlı. Ama 20 adım sınırı, tek retry, deterministik doğrulama ve sonunda insana devretme fikri her ajan çerçevesine uygulanabilir. Benim için en akılda kalan kural da şu oldu: Ajan bir testi silerek kapıdan geçemez.